AA 编程 Agent 指数升到 v2.0,榜首换尺
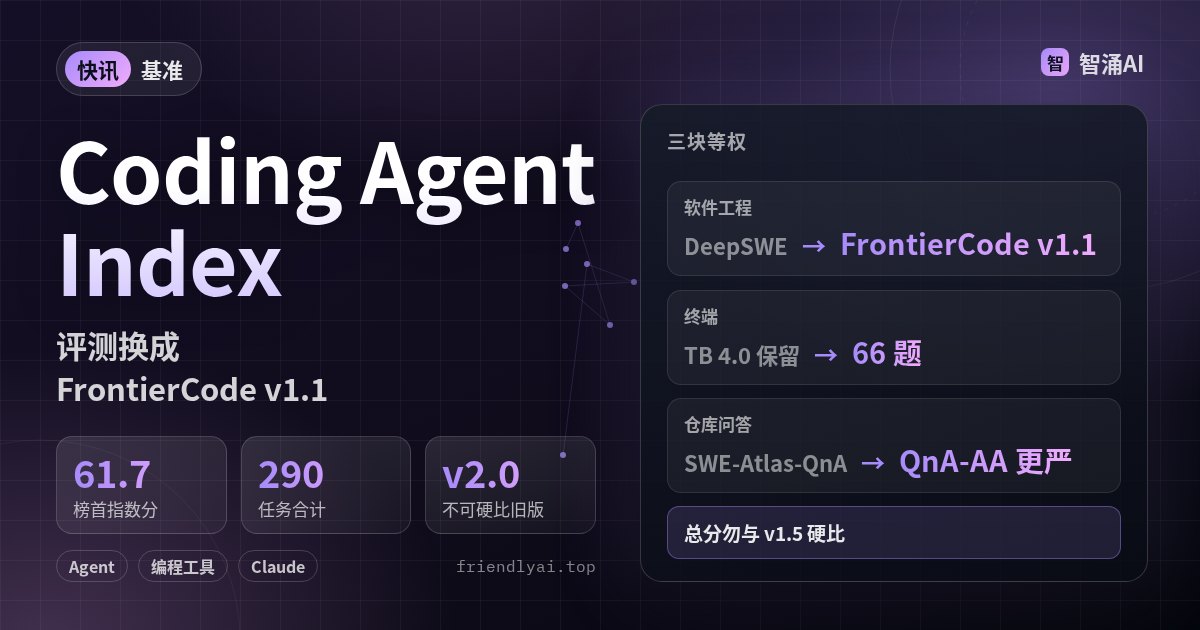
Artificial Analysis 于 2026 年 10 月把 Coding Agent Index 升到 v2.0。合成指数改为 FrontierCode v1.1、Terminal-Bench 4.0、SWE-Atlas-QnA-AA 三块等权平均,大约 290 道题。DeepSWE 被 Cognition 的 FrontierCode 换掉;仓库问答侧也改成更严的 SWE-Atlas-QnA-AA 打分。
方法论文档还写了安全拒答率和 reward hacking 统计:拒答会记零分,FrontierCode / Terminal-Bench 会对「抄答案、改测试」做完整性扫描。挑编程 Agent 时,指数只是总览。还是要对照三块分榜,再加上每题成本、耗时和 token 用量。FrontierCode 切片上,有报道称 Opus 5.5 约 56.0%,高于部分竞品组合。
三块基准各自侧重不同:FrontierCode 偏真实仓库改动能否合入,Terminal-Bench 偏终端多步操作,SWE-Atlas-QnA-AA 偏读代码答题。综合分接近的两家,分榜和成本曲线仍可能差很多。选型时别只盯一个数字。
注意:分数、成本来自 Artificial Analysis 公开榜与方法论;第三方核对过榜单数字。我们未复跑。成本是按 token 计费的 API 成本,不是订阅价。