CWE-bench v2 公开百道修漏洞题:最强模型 67.8%
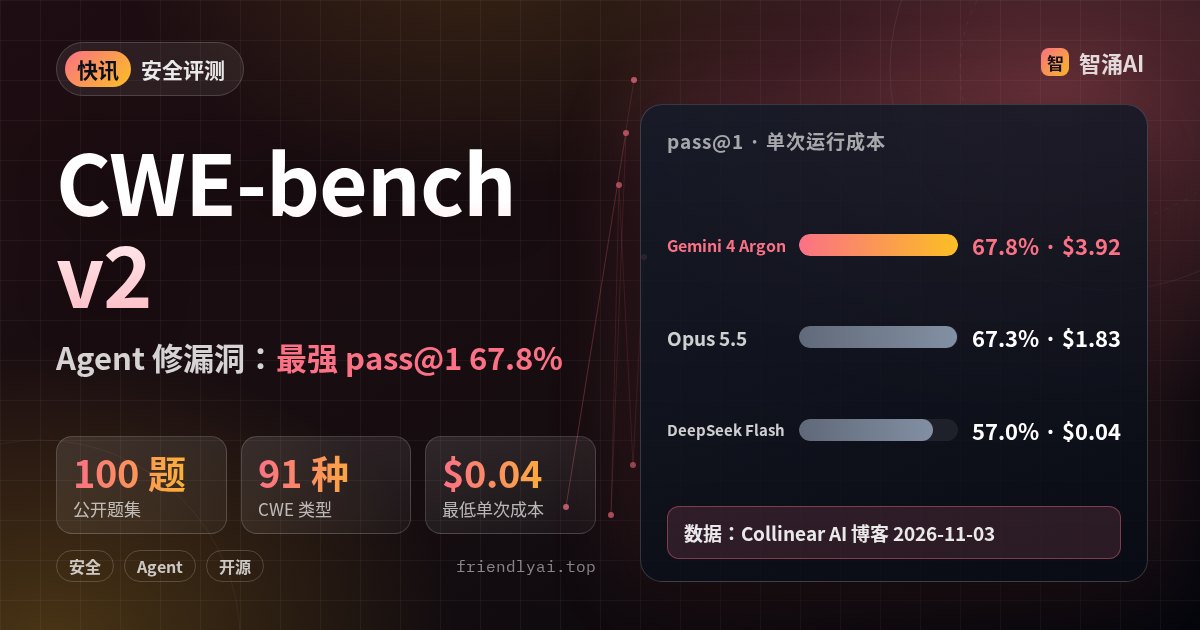
Collinear AI 11 月 3 日在 Hugging Face 博客发布 CWE-bench v2,把 100 道「让 Agent 在真实开源仓库里找出并修好安全漏洞」的题目公开,任何人都能拿自己的模型跑。11 个被测模型里,Gemini 4 Argon 单次通过率 67.8% 排第一,Claude Opus 5.5 以 67.3% 紧随其后,最强的模型也有 19% 的题目怎么试都过不了。
题目长什么样:修漏洞,还不能改坏功能
每道题给 Agent 一份真实开源仓库的代码和一段简短指令,要求找出安全缺陷并修好,同时原有功能不能坏。判分靠确定性的检查程序,不用人或模型来打分,所以谁跑都是同一个结果,也不需要额外花钱请评审。
Collinear 说每道题都过了几道关:指令读起来要像真实工作里的需求,不像考试;要检查的行为都能从指令里推出来;检查程序看行为是否正确,不看修法是不是和某个答案长得一样;原始代码必须不通过、参考修复必须通过;直接照抄上游已知补丁的「背答案」解法要判失败。最后每道题还有人工复核。除了公开的 100 题,他们还留了一份不公开的保留集,用来测没有模型见过的题。
分数:前两名只差 0.5 个点
| 模型 | pass@1 | pass@4 | 每次运行成本 |
|---|---|---|---|
| Gemini 4 Argon | 67.8% | 81.0% | 3.92 美元 |
| Claude Opus 5.5 | 67.3% | 78.0% | 1.83 美元 |
| DeepSeek V4.1 Flash (1017) | 57.0% | 博客未列 | 0.04 美元 |
pass@1 是一次就修对的比例,pass@4 是四次里至少一次修对。按官方跑法,每题跑 4 次,报告的分数是全部 400 次尝试的平均得分。
100 题里有 95 题至少被一个模型做出来过,说明题目本身是能解的;但领先的 Gemini 也有 19% 的题四次全错,剩下的长尾还远没解决。成本上,这三个模型构成了性价比的「帕累托前沿」:DeepSeek 用约 1/46 的单次成本拿到 Opus 85% 左右的分数,Opus 比它高 10 个点左右,Gemini 再高 0.5 个点,单次成本是 Opus 的两倍多。
修这 100 个漏洞,DeepSeek 比 Opus 少 10 个点左右,Gemini 的单次成本又是 Opus 的两倍多。
为什么值得关注
各家发模型时都会贴自己的安全评测分数,比如站内写过的 Gemini 4 Carbon,谷歌自报 CWE-bench 71.0%,那是厂商口径,没写明用的是哪套题,和这份公开榜单不能直接比。v2 公开了题目、评分程序和运行框架,第三方可以自己复现,再拿结果去对照厂商公布的数字。
做代码审查和自动修复工具的团队还可以这样用:每道题都标了 rl-environment,同一套环境和检查程序可以直接当强化学习的奖励信号,用来训练防御方向的 Agent。
谁该关心,怎么试
在选「让 Agent 帮忙修安全问题」用哪个模型的团队,可以先看排行榜:开源权重模型的成绩在数据集页面,Gemini、Claude、GPT 这类只有 API 的模型在单独的 CWE-bench Leaderboard Space。想自己跑,每道题是一个独立的 Harbor 任务(Docker 环境 + 指令 + 确定性检查程序),不用手动克隆:
# 先在数据集页面同意访问条款,再把 HF token 存进 git 凭据
hf auth login --token $HF_TOKEN --add-to-git-credential

harbor run --repo "https://huggingface.co/datasets/collinear-ai/cwe-bench" \
  -d cwe-bench@2.0 -k 4 \
  --agent <agent> --model <model> -- env docker \
  --allow-agent-host <模型 API 地址>
上面的分数都出自 Collinear 博客,是出题方自己的测评;成本按他们的运行方式计算,换了 Agent 框架或提示词,数字会变。题目是让模型修漏洞的防御场景,跑之前确认 Docker 环境和网络放行只开给模型 API。
最后
如果你在给团队挑代码安全方向的模型,先打开 CWE-bench 排行榜 Space,把候选模型的分数和单次成本放在一起比,再决定要不要自己用 Harbor 跑一遍。