Liquid AI LFM3:2B 级端侧多模态家族
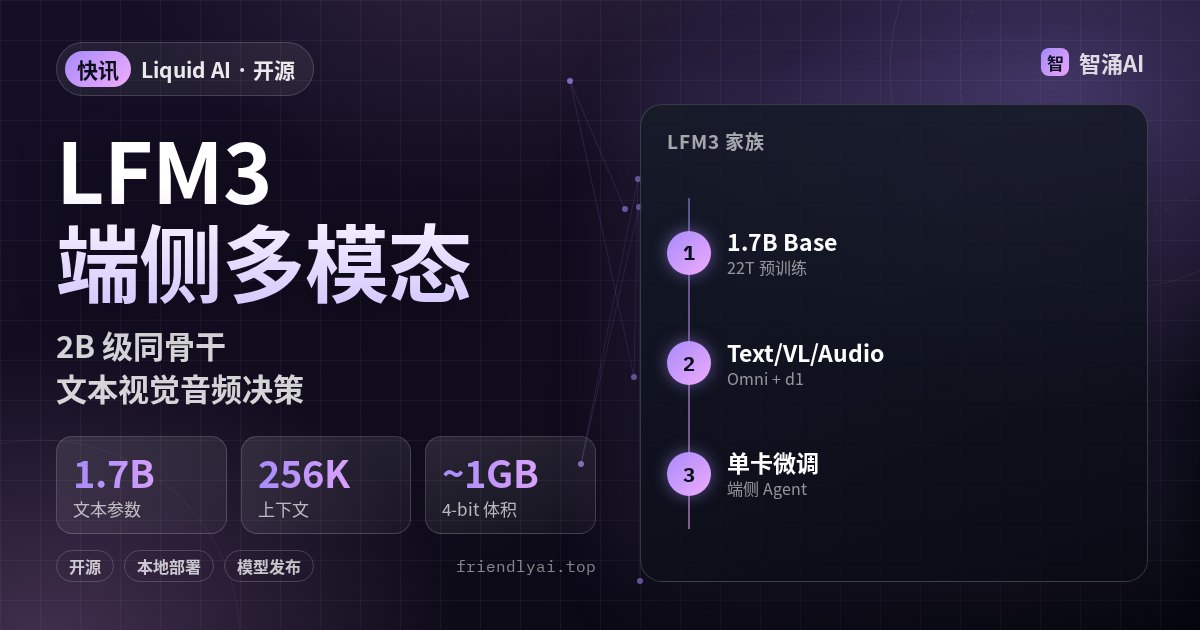
2026 年 10 月 27 日,Liquid AI 发布 LFM3(Liquid Foundation Models 第三代):约 2B 参数量级的多模态家族,文本、视觉、音频、全模态(Omni)与决策模型共用同一套新骨干。基础与后训练权重已在 Hugging Face、Playground 与 Liquid API 开放。短快讯只报了体积和上下文。下面按官方博文与 LiquidAI/LFM3-1.7B 模型卡,把架构、评测口径和「专用智能」定位摊开。本站未下载权重做加载测速。
做本机 本地模型 Agent 或边缘多模态助手时,优先看 Hugging Face 权重与 llama.cpp / MLX / vLLM 的日一支持清单;商用前核对模型卡上的 LFM Open License v1.0(卡上标注为 other 时也以许可证全文为准)。
为什么现在发 2B 级家族
Liquid 把 LFM3 写成「专用智能」底座:参数小到能在单卡微调、能塞进手机或笔记本,又要在工具调用和长上下文上够用。博文对比表里,LFM3-1.7B 在 BFCL V4(71.39)、部分浏览器/办公自动化任务上能压过更大的开源模型;agentic coding 与知识类仍常输给更大模型——模型卡也写明:不推荐把它当复杂 agentic coding 主力。
先选模态实例,再短微调;别指望一颗 2B 通吃编码、知识和端侧延迟。
三混合骨干与训练量
相对 LFM2 的「短卷积 + 注意力」,LFM3 在架构搜索里为 agentic、长上下文加了滑动窗注意力(SWA,窗口 256)。24 层里 13 层门控短卷积(核大小 7)、5 层 SWA、6 层全局注意力;另有 head-wise 门控、部分 RoPE、sandwich norm 等稳定与量化友好改动。词表 128K,与 LFM2.5-8B-A1B 同系。
预训练合计约 22T token:主阶段加科研论文、仓库级代码与数学;最后 3.5T 为 mid-training,提高 agentic 轨迹与多样工具调用占比,并把上下文拉到 256K。后训练四段:SFT(约 1.75T)、混合 RL、多域 on-policy 蒸馏(MOPD)、真实 harness 里的 agentic RL。
| 实例 | 大致参数 | 官方定位(博文/模型卡) |
|---|---|---|
| LFM3-1.7B | 1.73B | 本地 Agent、工具调用、256K 文本 |
| LFM3-VL-2B | ~1.9B | 图像/视频理解、空间与 GUI;自研视觉编码器算力约降为前代 SigLIP2 的 1/3 |
| LFM3-Audio-2B | ~2B | 语音对话、18 语种 ASR/TTS、音频理解与工具调用 |
| LFM3-Omni-2B | ~2.2B | 视听一体问答与多模态工具调用 |
| d1-2B / d1-Omni-2B | ~2B | 单次前向回答多题(含框选、抽取、区间估计);偏路由与结构化决策 |
端侧与吞吐数字怎么读
博文给出的边缘测速:llama.cpp Q4_0、32K 上下文下,LFM3-1.7B 在所列三台设备上预填充与解码都快于对比组,且内存最低;完整 128K 的 KV 约 1.6GB(对比表中 Qwen3.5-4B 约 4.3GB)。GPU 侧宣称单卡 NVIDIA B300、BF16、1024 并发时日产约 36 亿 token——属于厂商自测峰值,换引擎与量化会变。
视觉侧官方称在 62 项视觉评测上平均分显著高于同尺寸对比模型,并接近更大的 Gemma 4 12B;音频侧强调自研编码器可边说边做 prefill,首 token 可低至约 50ms。这些分数与延迟均未在本站复测。
专用智能:微调示例与许可
博文用风机叶片缺陷检测说明短微调:约 3000 张公开图、单卡 A100 数小时,分类准确率提到约 67%(基座与某闭源小模型在同设定下宣称不足 10%)。另有把 VL 模型接到机器人编排 / 导航 / 操作的研究向微调(Isaac Sim、Jetson 等数字同样来自官方)。应用侧更稳的做法是:先选文本或 VL 权重,按 HF 上的 TRL notebook 做 SFT/DPO/GRPO,再用自己的评测集验收。
日一生态包括 llama.cpp、MLX、vLLM、SGLang、Ollama、LM Studio 等(以各项目当日说明为准)。本站未实测下载、量化与端到端对话延迟。
最后
手机或笔记本上的工具 Agent、垂直视觉质检,可以先从 LiquidAI/LFM3-1.7B(或 VL)拉 GGUF/MLX 看延迟;上生产前自己复跑 BFCL 或业务集,并读完 LFM Open License。云端通用推理仍需要更大模型时,把 2B 级 LFM3 当专家小模型即可。
每天的 AI 快讯、实用教程和 AI项目实测,也会同步发到微信公众号。在微信里搜索「智涌AI速递」就能关注;不用微信的话,可以用 RSS 订阅本站。