英伟达小模型 Bolt E4B:4GB 显存跑本地 Agent
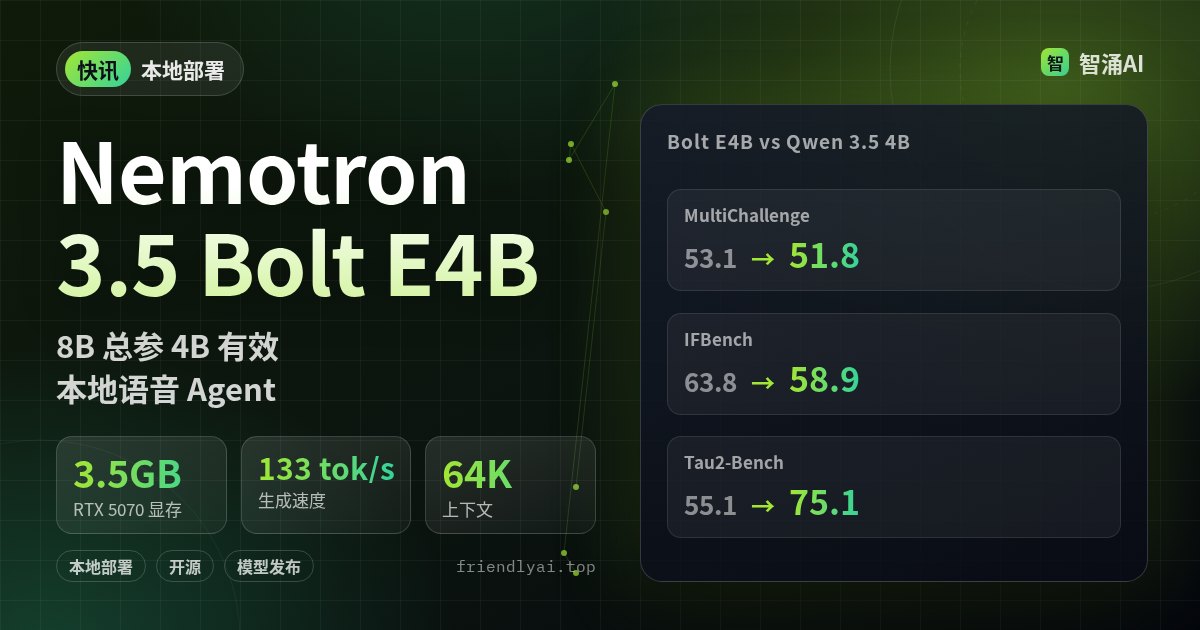
NVIDIA 10 月 23 日发布 Nemotron 3.5 Bolt E4B,一个在 Gemma 4 E4B 上做 Nemotron 后训练的小模型,总参数 8B、有效 4B,上下文 64K,支持 35 种语言。它瞄准的是本地语音助手、游戏 NPC、机器人这类要边说话边调工具的场景。
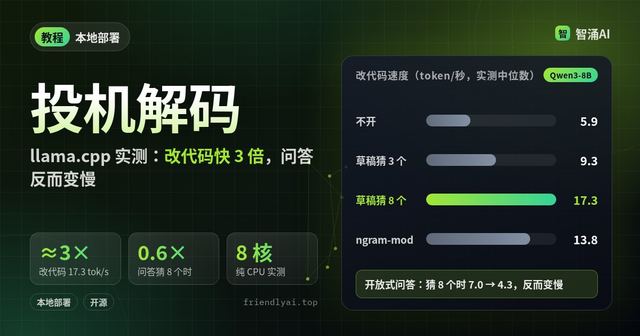
和同尺寸对手比有输有赢:MultiChallenge 53.1、IFBench 63.8 都领先 Qwen 3.5 4B,但多轮客服任务 Tau2-Bench 只有 55.1,Qwen 3.5 4B 是 75.1。另附一个 DFlash 并行草稿模型做投机解码,官方说吞吐比 Gemma 原版 MTP 草稿模型高最多 21%,原理可以参考站内的 llama.cpp 投机解码实测。
名字里的「4GB」指目标负载下的显存占用,不是文件大小。Jetson Orin Nano 8GB 上也能跑,每秒约 15.5 个 token。
注意:跑分是 NVIDIA 自测;Brevity Bench 和 When2Call-MT 两个评测还没公开。中文对话效果官方没有单独给数据。