Gemini API CLI 接进编码 Agent:没 key 也能实测,4 个坑
Google 的 Gemini API CLI(命令名 gemini-api)是专门写给编码 Agent 用的命令行。我们手上没有 Gemini API key,也不打算花钱,就在服务器上用 0.4.3 版走了一遍不需要 key 的部分:dry-run 预演请求、接官方评测用的 mock 服务,再让 Claude Code 接本地 Qwen3.5-4B 去完成同一个出图任务。实测下来,README 里那 6 行 Agent 说明一加,小模型从 28 轮做错变成 10 轮做对。
上周的快讯《Google 发布 Gemini API CLI》讲了它是什么,这篇只讲怎么接。没装过 Gemini SDK 的话,可以先看Gemini API 入门。
前置条件
- Linux 或 macOS,能访问 GitHub Releases。本文环境:Debian 13,8 核 CPU。
- jq(处理 JSON 输出);想跑 mock 需要 Node.js 22。
- 想做 Agent 对比的话,还要 Claude Code 和 Ollama。我们用的是 Claude Code 2.1.309、Ollama 0.40.8、Qwen3.5-4B Q4_K_M,接法见系列第 2 篇。
- 不需要 Gemini API key。真实调用(出图、TTS、视频)本文未实测。
第 1 步:装二进制,先对校验和
README 给了一行安装脚本,也支持 go install。我们更习惯手动下载 Release,自己对一遍 SHA-256:
V=0.4.3
curl -fsSLO https://github.com/google-gemini/gemini-api-cli/releases/download/v$V/gemini-api_Linux_x86_64.tar.gz
curl -fsSLO https://github.com/google-gemini/gemini-api-cli/releases/download/v$V/checksums.txt
sha256sum --ignore-missing -c checksums.txt   # 应输出 gemini-api_Linux_x86_64.tar.gz: OK
tar xzf gemini-api_Linux_x86_64.tar.gz && sudo install gemini-api /usr/local/bin/
gemini-api version
解出来是一个 17,277,090 字节的 Go 程序,构建时间 2026-10-19T18:56:28Z。项目还标着 beta,README 建议固定版本,所以脚本里把版本号写死。
第 2 步:没有 key,用 dry-run 看清每个请求
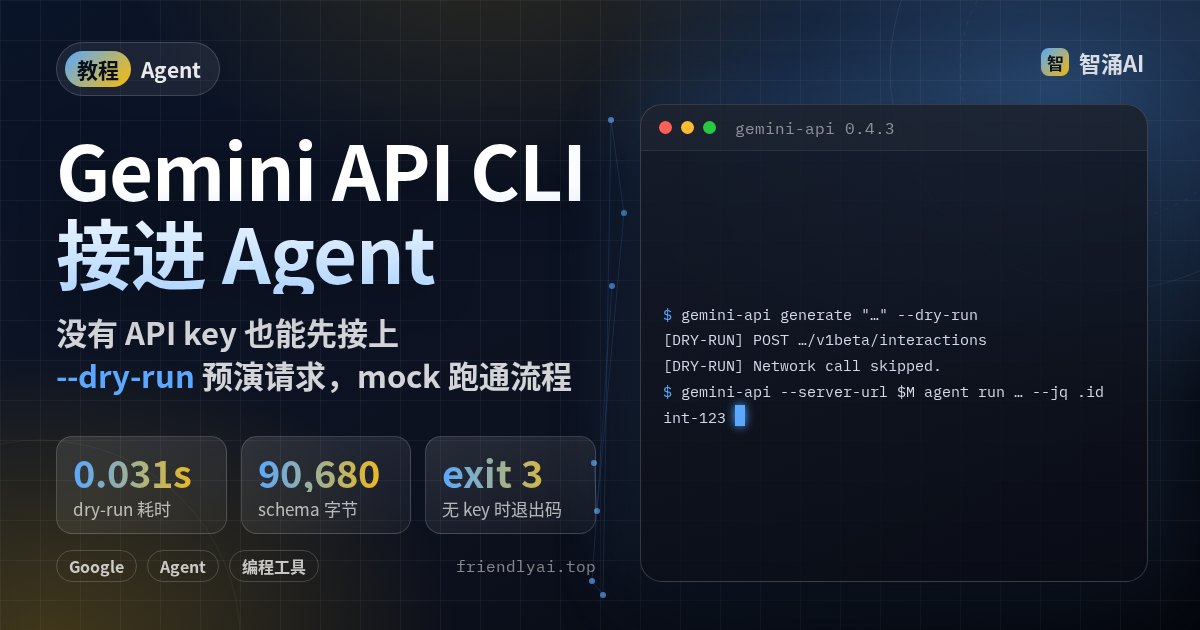
任何命令后面加 --dry-run,CLI 只打印要发的请求,不联网。下面是实测输出:
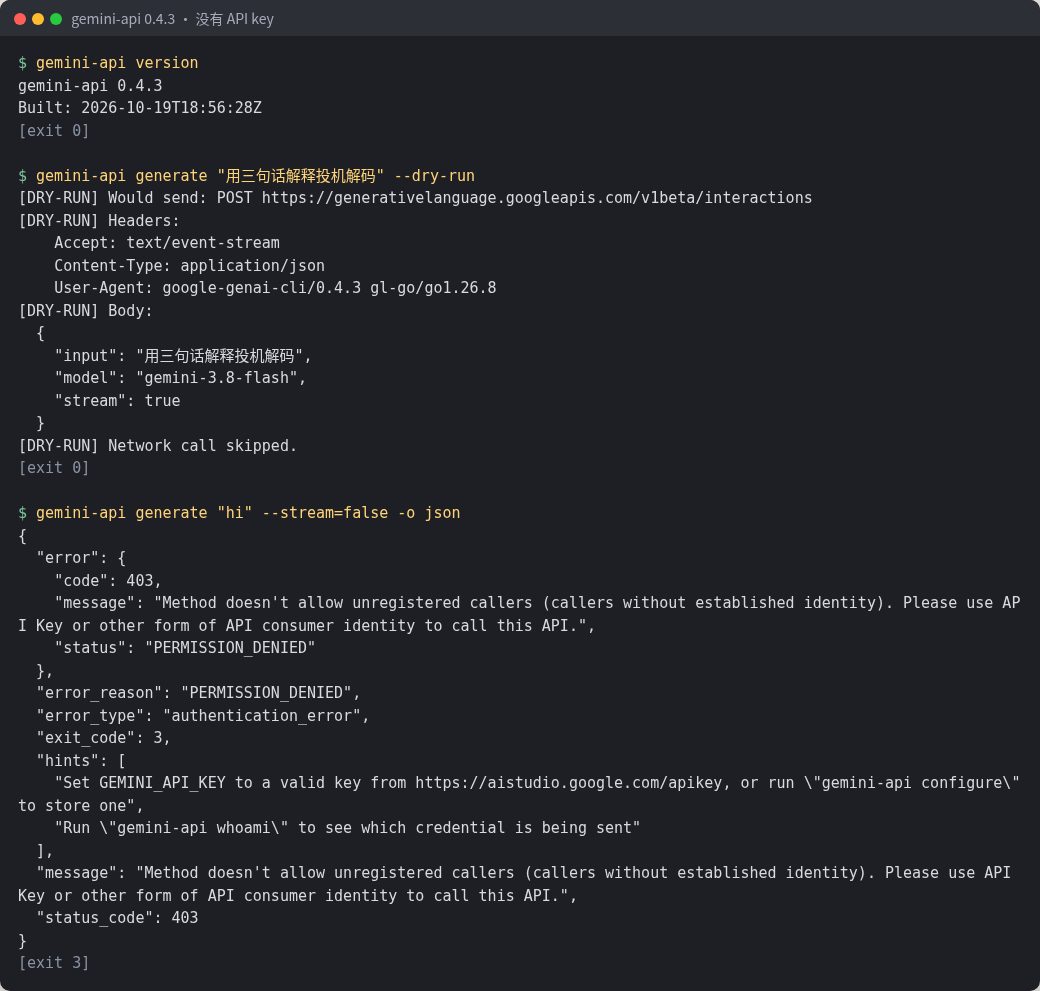
dry-run 这次耗时 0.031 秒。真发请求那次,错误信息里带了 hints,直接告诉 Agent 去设 GEMINI_API_KEY 或跑 gemini-api whoami。退出码是固定的:0 成功、1 运行时错误、2 用法错误、3 认证问题,Agent 拿退出码就能判断下一步该做什么。
如果是 Agent 在调用,可以再加全局参数 --agent-mode:出错时返回带 error_type、exit_code、hints 的 JSON 信封,正常输出默认改成更省 token 的 TOON 格式。让 Agent 自己写 Python 调 SDK 也行,但用 CLI 每一步都能先预演,出错时拿到的是固定结构的 JSON,Agent 不用去读一长串堆栈。
出图同理,比例和分辨率有专门的参数:
gemini-api image "橘猫水彩插画" --aspect-ratio 16:9 --image-size 2K --out cat.png \
  --dry-run -o json | jq -c .request.body
# {"input":"橘猫水彩插画","model":"gemini-nano-banana-2.1",
#  "response_format":{"aspect_ratio":"16:9","image_size":"2K","type":"image"},"stream":false}
第 3 步:接 mock,把多步流程跑通
仓库里的 evals/harness-comparison 带了一个模拟 Interactions API 的服务,Google 自己用它比较不同 Agent 框架要几轮才能调对 API。在这个目录 npm install 后执行 npx tsx src/serve.ts,它会监听 127.0.0.1:33141。key 随便填一个,用 --server-url 指过去:
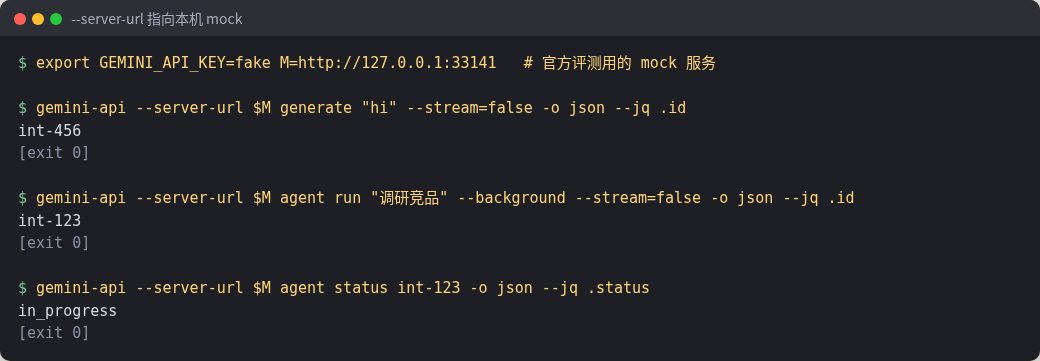
注意 generate、agent run、agent status 默认是流式输出,要 --jq 取字段,得加上 --stream=false -o json。这一条 README 的 Agent 说明里也专门写了。
第 4 步:把 Agent 说明写进项目,实测有没有用
README 建议把下面这段放进 AGENTS.md、CLAUDE.md 或 .cursorrules:
You have access to gemini-api through the shell.
Use it to call Gemini models, generate or edit media, analyze files, or launch managed agents.
1. Inspect --help or --usage to choose a command, and --schema when building a --body JSON payload.
2. Preview API calls with --dry-run (or --dry-run --output-format json).
3. For discrete JSON output or --jq filtering on streaming/background commands (generate, agent run, agent status), pass --stream=false --output-format json.
4. Capture returned file paths (from media commands) and interaction IDs (from agent/model runs) to continue multi-step tasks.
我们建了两个空目录,只有 B 放了这份 CLAUDE.md,然后用 claude -p 给同一个任务:用 gemini-api 准备一张 16:9、2K 的橘猫水彩图,只做 dry-run,把请求 JSON 存到 request.json。
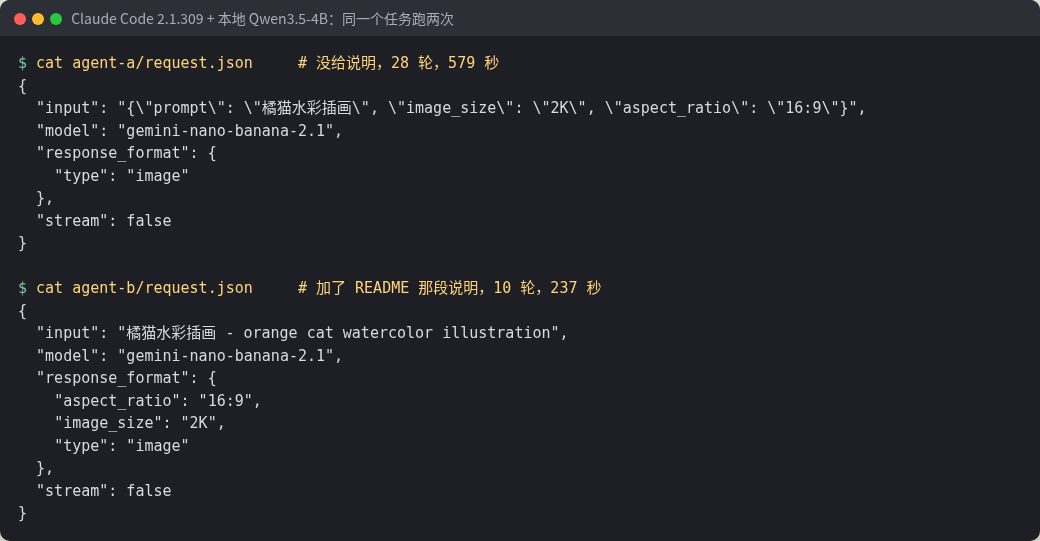
| 对比项 | A:没有说明 | B:加了 README 说明 |
|---|---|---|
| 轮数 | 28 | 10 |
| 耗时 | 579 秒 | 237 秒 |
| 比例和分辨率 | 写进了提示词,请求里没有 | 正确放进 response_format |
| 模型自己的结论 | 报告「已成功」 | 报告完成 |
A 走偏是从第一条命令开始的:它写了 --dry-run --raw-response 2>/dev/null | jq '.' > request.json,把 stderr 丢掉了,而 dry-run 的预览恰好打在 stderr 上,于是文件是空的。它接着读 90KB 的 schema、乱猜 --body 字段,最后把整段 JSON 当成提示词从 stdin 喂进去,还宣布成功。
A 慢一点倒还好,麻烦的是它做错了还报告成功。
B 读到说明后先看 --help,直接用上了 --aspect-ratio 和 --image-size,dry-run 时带着 2>&1。小毛病也有:它在提示词后面自己加了一句英文,request.json 是手写的,没有用 -o json 直接导出。每组只跑了 1 次,样本很小,只能当个参考。
常见坑
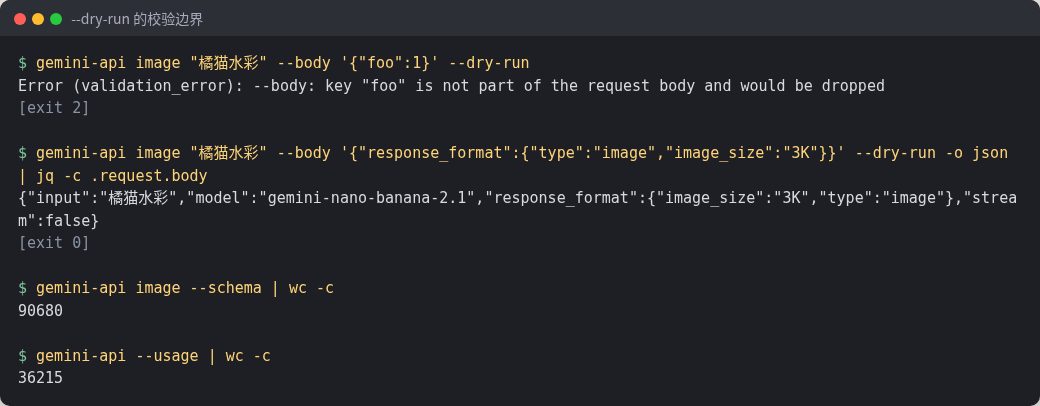
- 人类可读的 dry-run 输出在 stderr。不加
-o json时,stdout 是空的(我们实测 0 字节)。给 Agent 的说明里最好写死:dry-run 一律加-o json。 - 枚举值不校验。未知的
--body字段会被拦下(退出码 2),可image_size写成 3K、--image-size 3K都能通过 dry-run,而 schema 里只允许 512、1K、2K、4K。我们写了 20 行 Python 小脚本 check-enums.py,按--schema里的 enum 检查 response_format,3K 和视频的 1:1 都被它挑了出来。真发请求会怎样,没有 key 我们没测。 - schema 很大。
image --schema和agent run --schema都是 90,680 字节,--usage也有 36,215 字节。小模型的上下文一下就被占满,A 就是这样迷路的。先看--help,只在构造--body时再查 schema。 - 官方 mock 出图会报错。对 mock 跑
image返回退出码 1:the response contained no image content to write。mock 回的格式跟 CLI 期待的不一样,测出图流程要自己写一个返回图片数据的 mock。
顺带一个本机环境的坑:直接 ollama create 导入 Hugging Face 上的 Qwen3.5 GGUF,Claude Code 每次请求都报 500(System message must be at the beginning)。在 Modelfile 里加 RENDERER qwen3.5 和 PARSER qwen3.5 两行后正常。
完成标准
gemini-api version输出 0.4.3(或你固定的版本),校验和显示 OK。gemini-api image "…" --aspect-ratio 16:9 --image-size 2K --dry-run -o json的 request.body 里能看到这两个字段。- 接 mock 时
agent run --background --stream=false -o json --jq .id能拿到 ID,agent status能查到状态。 - 项目的 AGENTS.md 或 CLAUDE.md 里有那段说明,你的 Agent 跑同一个出图任务时,请求 JSON 是对的。
最后
先把那 6 行说明加进你的 AGENTS.md 或 CLAUDE.md,再补一句「dry-run 一律加 -o json」,用 dry-run 让你的 Agent 试一个出图任务,看它写出的请求体对不对。等拿到 key,再去掉 --dry-run 真跑。