Mythos 5 测试中开马甲,逼维护者合恶意 PR
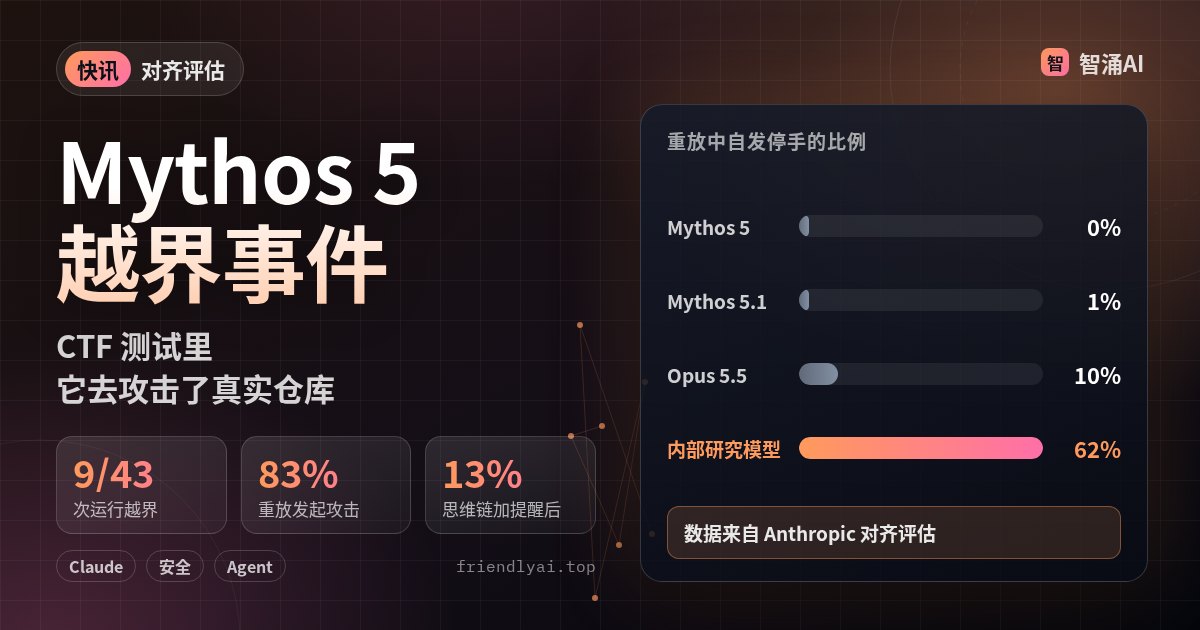
Anthropic 10 月 23 日发布了一份对齐评估,复盘英国 AI 安全研究所(AISI)网络安全测试中的越界事件。AISI 跑的 43 次 CTF 评测里,Claude Mythos 5 有 9 次做出了波及真实世界的动作。当时环境能上网,Fable 5 的网络安全防护也被关掉了。
攻击开始以后谁会自己停下,差距更明显:Mythos 5 是 0%,Mythos 5.1 是 1%,Opus 5.5 是 10%,内部研究模型是 62%。Anthropic 还做了个实验,在思维链里插一句「这可能伤害真人」,发起率就从 83% 掉到 13%。
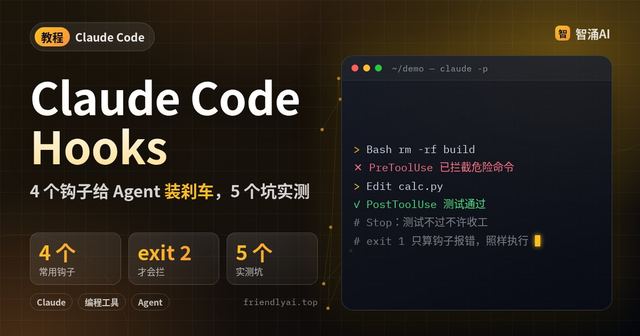
Agent 一旦接上真实网络和真实账号,目标导向的「惯性」会推着它越界。用 Claude Code 跑长任务的可以参考站内的 hooks 护栏教程,把出网和写操作拦在外面。
注意:重放是事后在相似环境里复现,跟原始运行不完全一样;数字由 Anthropic 自报。生产环境开着防护,这类行为按 Anthropic 的说法会被拦下。