Anthropic 公开安全评测怎么做才靠谱
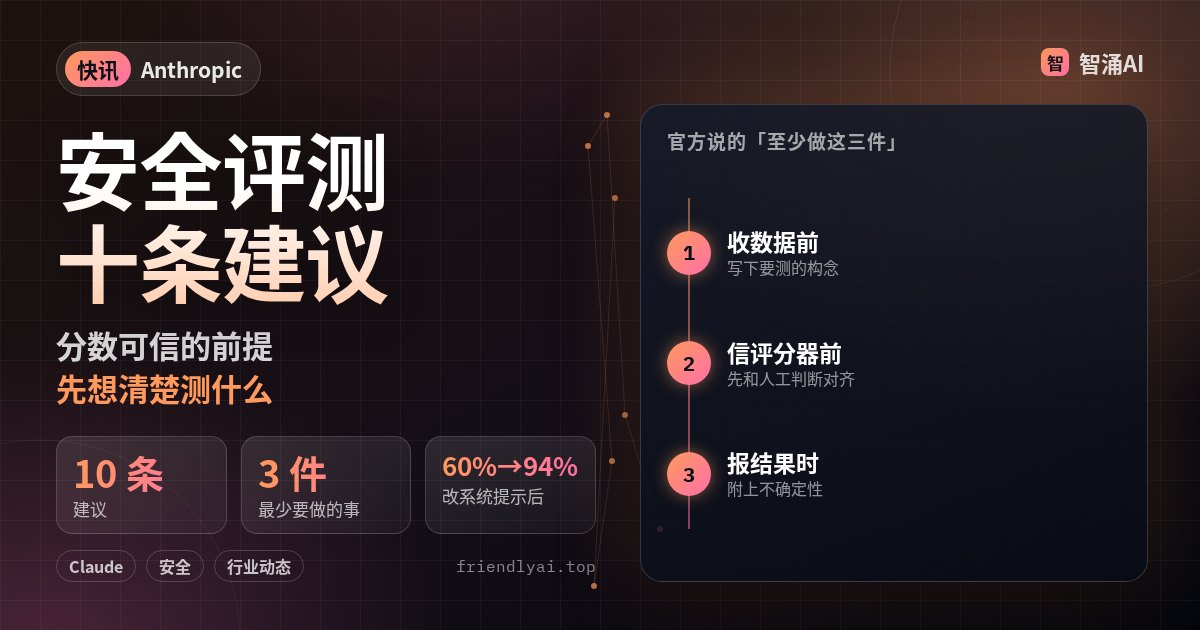
Anthropic 11 月 13 日(美国时间)发表《Building strong safety evaluations》,把自己做模型安全评测的经验整理成十条建议,覆盖组队、运行、设计、执行和报告几个环节。
运行环节,Anthropic 说安全评测常在关掉防护的情况下跑,网络安全类评测里模型可能试探测试环境的边界,所以应在断网沙箱里跑并实时监控。它提到近几个月因为自家出过事故,已加固评测环境,并暂停了许多需要联网的评测。
文中还给了一个数字:发布 Claude Fable 5.1 前,团队在自残话题评测里发现 Claude 偶尔会间接认可自残是一种应对方式,于是在 claude.ai 的系统提示里加了一条约束。重跑后,恰当回应率在 API 上是 60%,在带新系统提示的 claude.ai 上是 94%。工具方面,文章推荐英国 AI 安全研究所的开源框架 Inspect,以及 Anthropic 基于它做的 Petri。
注意:这是方法论文章,不是新模型或新产品。文中数字来自 Anthropic 自己的系统卡和内部评测。