AWS:无服务 MCP 接数据湖
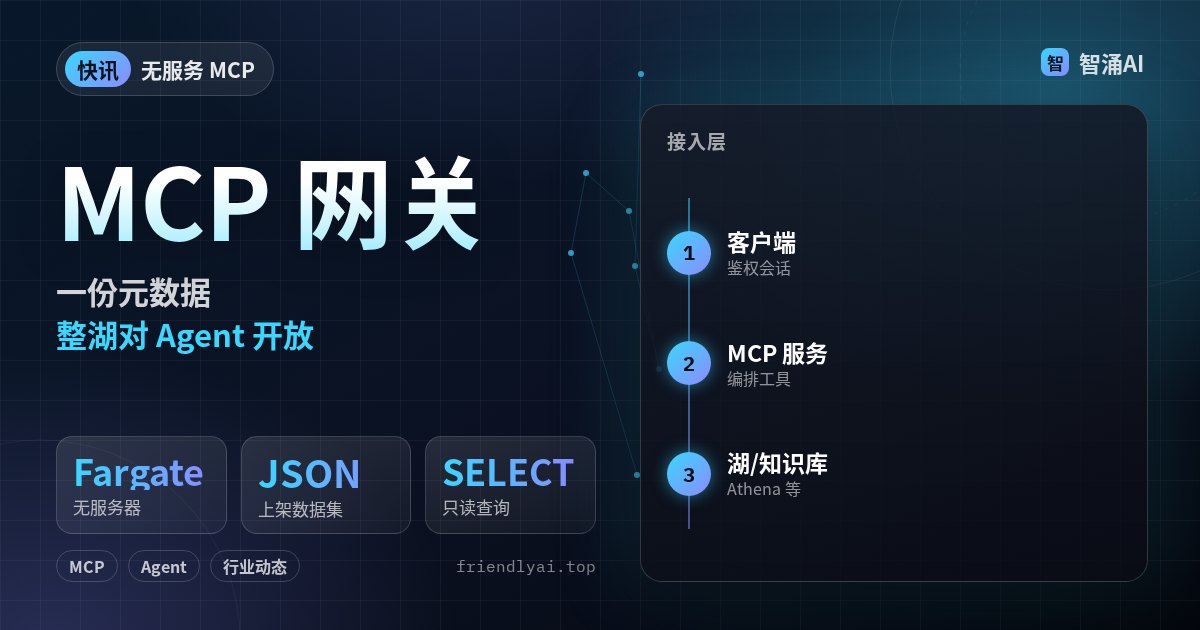
AWS 机器学习博客 2026-11-06(北京时间)分享北美分拣中心(NASC)规划团队的做法:在 Amazon ECS Fargate 上搭无服务 MCP 服务器,让 Agent 经统一网关查企业数据湖,而不是每个助手各自硬编码库表。新数据集丢一份元数据 JSON,流水线同步后即可被发现。本文按官方博文扩写架构、数字与适用边界;短讯原帖同 slug。
发生了什么
NASC 规划团队要对话式查容量、人力与包裹流数据。以往每个 Agent 自己拼 SQL、记 schema、管连接——表一变就要全员打补丁,权限也没有单一审计点。官方做法是把 MCP 当成与 Agent 框架无关的网关:工具层寿命可以长过某一个编排框架。
请求路径大致是:客户端(网页聊天、Slack、IDE 插件或外部 Agent)→ Route 53 / 公网 ALB(HTTPS + WAF)→ Cognito 鉴权 → 私有子网里的客户端服务(DynamoDB 存会话)→ 内部 ALB → MCP 服务层(Bedrock 编排 + FastMCP)→ Athena/Redshift 或 Bedrock Knowledge Bases。数据入湖与知识库刷新由 Lambda 等流水线处理。
为什么重要
对数据平台来说,痛点常在「第三个 Agent」出现之后:集成逻辑被复制三份,schema 漂移没人统一修。元数据驱动把「加一张表」从改代码+发版,收成丢文件+等同步。标准化 /mcp 端点也让多团队、多框架共用同一套工具与同一套访问控制——新 Agent 只要指向端点,不必再挖一套 SQL 生成器。
官方判断:把扩展性做成配置问题(少写集成代码),上架周期才可能从「多天工程」压下来。
可核实数字与机制
| 项 | 官方博文口径 |
|---|---|
| 端到端延迟 | 测试中约 15–20 秒(含上下文收窄后的交互) |
| 上架方式 | 一份元数据 JSON + 可选上下文映射条目 |
| SQL 工具 | 工具层拒绝写操作,仅 SELECT |
| 示例表规模 | 文中示例 regional_order_summary 约 21 亿行、日增刷新 |
| 扩缩容 | 客户端 / MCP 服务按 CPU(或内存)自动扩;Athena、Bedrock 为托管扩缩 |
元数据字段里,business_description_for_the_table 可塞引擎提示(「比较时间戳时用 date() 包字面量」),降低校验失败;column_details 给列类型、自然语言说明和 sample_values——Agent 才知道 warehouse_id 长得像 FC-EAST-07,而不是「东区仓」这种自然语言。流水线用 Titan 文本嵌入把元数据写入 Bedrock Knowledge Bases;索引完成后,已连接的 Agent 无需重启即可发现新表。
上下文映射示例:把 labor_planning 域绑到 workforce.capacity_details 等表。指定表后,MCP 只在这些表里搜目录,降噪、提 SQL 准度;不指定则搜全部已索引表。
一个主对比
| 每 Agent 直连库表 | 无服务 MCP 网关 | |
|---|---|---|
| 加数据集 | 改工具代码、校验、发版 | 丢 JSON,等流水线 |
| 权限与审计 | 散落在各 Agent | 网关层集中 + CloudWatch |
| 换 Agent 框架 | 常要重写集成 | 仍打同一 /mcp |
| 适合规模 | 少数表、单团队 | 多团队、多 Agent、表持续增长 |
谁该关心、怎么试
该看:内部分析助手、要给业务侧「不用写 SQL」对话入口的数据平台;已在用 Athena/Redshift + Bedrock、并准备接多个 MCP 客户端(Amazon Q、IDE 扩展等)的团队。
可能过重:只有几张表、一个人维护的小团队——Fargate + 双 ALB + Cognito + 知识库刷新整套运维成本未必划算,可先用更轻的单进程 MCP,等表与 Agent 数量上来再抄这套分层。
落地注意:架构需落在支持 Bedrock 与 Knowledge Bases 的 Region;多租户更细的列级权限、失败案例回流改进,博文写在「下一步」,当前文中未声称已上线。站内相关:GitHub MCP 工具集与只读开关、BYOB 自带 Agent 上桌。
最后
若你正在给企业数据湖接第二、第三个 Agent,先按博文把「工具层」和「Agent 层」拆开:用一份元数据目录 + SELECT-only 工具 + 统一 Guardrails,再让各客户端打同一个 /mcp。细节与图示以 AWS 官方博文为准。