MCP 是什么、怎么配?2026 新协议实测与 4 个坑
MCP(Model Context Protocol)是一套让 AI 应用接外部工具的开放协议:工具方写一个 MCP 服务器,Claude Code、OpenCode 这些客户端就都能调用,不用每家各接一遍。7 月 28 日发布的新版规范把握手去掉了,很多老教程已经对不上。我们在沙箱里用官方的 filesystem 和 memory 两个服务器从头走了一遍:先手发 JSON-RPC 看清协议,再接进 Claude Code 和 OpenCode,最后让一个本地 4B 小模型真去调用。
MCP 解决的是「一个工具接 N 遍」
没有 MCP 的时候,想让编码 Agent 查数据库、读 Sentry、改 Notion,每个 Agent 都得自己写一套集成。MCP 把这件事拆成三方:宿主应用(Claude Code、OpenCode)里跑着 MCP 客户端,工具方提供 MCP 服务器,两边用 JSON-RPC 说话。服务器对外暴露三类东西:工具(tools,让模型调用)、资源(resources,给模型读的数据)和提示词模板(prompts)。日常用得最多的是工具。
连法有两种。本地服务器走 stdio:客户端把它当子进程拉起来,从标准输入输出收发消息,适合读写本机文件、跑脚本。远程服务器走 Streamable HTTP,适合 SaaS 服务,通常带 OAuth 登录。老的 HTTP+SSE 传输在新规范里被正式列为弃用。
官方仓库 modelcontextprotocol/servers 现在只维护 7 个参考实现:Everything、Fetch、Filesystem、Git、Memory、Sequential Thinking、Time。仓库首页写明它们是教学示例,不是生产级方案;GitHub、Slack、PostgreSQL 等老服务器已归档,找第三方服务器要去 MCP Registry。
前置条件
- Node.js 22(我们用 v22.23.3),
npx能用;Python 写的服务器建议装 uv,用uvx拉起(我们用 0.13.5)。 - 一个 MCP 客户端:本文用 Claude Code 2.1.309 和 OpenCode 1.19.3。
- 测试用服务器:
@modelcontextprotocol/server-filesystem@2.0.0、@modelcontextprotocol/server-memory@2.0.0、mcp-server-fetch==2026.10.19,都免费。 - 想让模型真调用工具的话,要有一个模型。我们没用付费 API,接的是 Ollama 0.40.10 上的 Qwen3.5-4B(Q4_K_M),8 核 CPU、无 GPU。
第一步:先绕开客户端,直接跟服务器说话
想弄懂 MCP,最快的是自己当一回客户端。stdio 服务器就是个命令行程序,每行读一条 JSON-RPC 请求、写一条响应。我们写了个十几行的 rpc.py,把 filesystem 服务器拉起来,只允许它访问 demo/ 目录:
npm install @modelcontextprotocol/server-filesystem@2.0.0
# 服务器参数就是允许访问的目录
node_modules/.bin/mcp-server-filesystem ./demo
按新协议,第一条请求不再是 initialize,而是 server/discover;之后每个请求都在 _meta 里带上协议版本和客户端能力:
{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{
  "_meta":{"io.modelcontextprotocol/protocolVersion":"2026-07-28",
           "io.modelcontextprotocol/clientCapabilities":{}},
  "name":"read_text_file","arguments":{"path":"/abs/path/demo/note.txt"}}}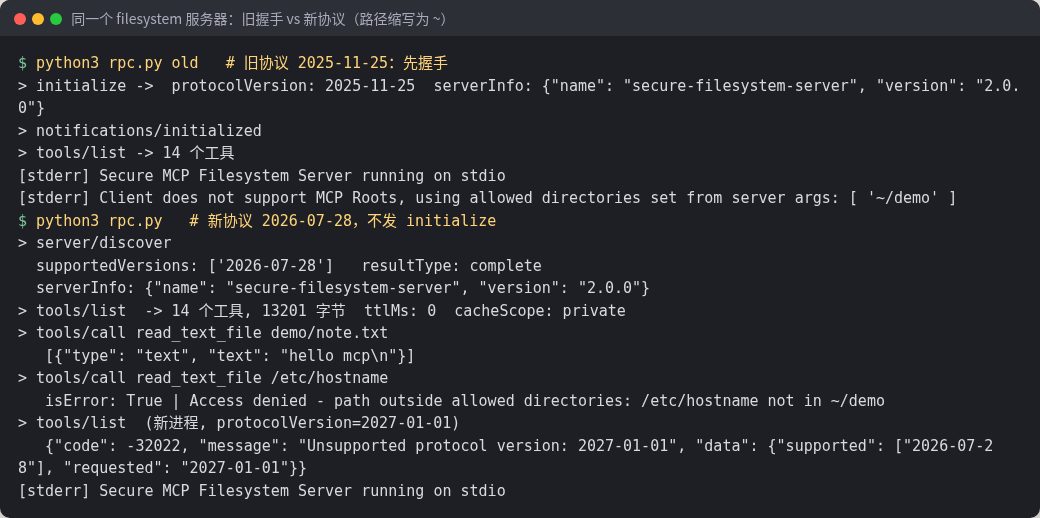
输出里有几处要留意。server/discover 报告只支持 2026-07-28,结果里多了必填的 resultType: complete;tools/list 带上了新加的 ttlMs 和 cacheScope 缓存字段。服务器同时还认旧客户端:发 2025-11-25 版的 initialize,它照样回 protocolVersion: 2025-11-25,只是在 stderr 里提示客户端不支持 Roots,改用启动参数里的目录。把版本号写成不存在的 2027-01-01,它回错误码 -32022,并附上支持的版本列表。
新规范还改了这些:Mcp-Session-Id 和协议级会话被删掉,ping、logging/setLevel 被移除,Tasks 挪进了官方扩展,Roots、Sampling、Logging 三个功能进入弃用期(规范承诺至少 12 个月)。Claude Code 文档写明,它的 v2 运行时基于 TypeScript SDK 2.0,会先问服务器支不支持新版本,支持就用新协议,不支持就退回旧握手。
第二步:接进 Claude Code,先选对作用域
Claude Code 用 claude mcp add 加服务器,-- 后面是启动命令,环境变量用 --env 传:
claude mcp add fs -- npx -y @modelcontextprotocol/server-filesystem@2.0.0 /path/to/demo
claude mcp add memory --env MEMORY_FILE_PATH=/path/to/memory.jsonl \
  -- npx -y @modelcontextprotocol/server-memory@2.0.0
claude mcp add fetch -- uvx mcp-server-fetch==2026.10.19
claude mcp list
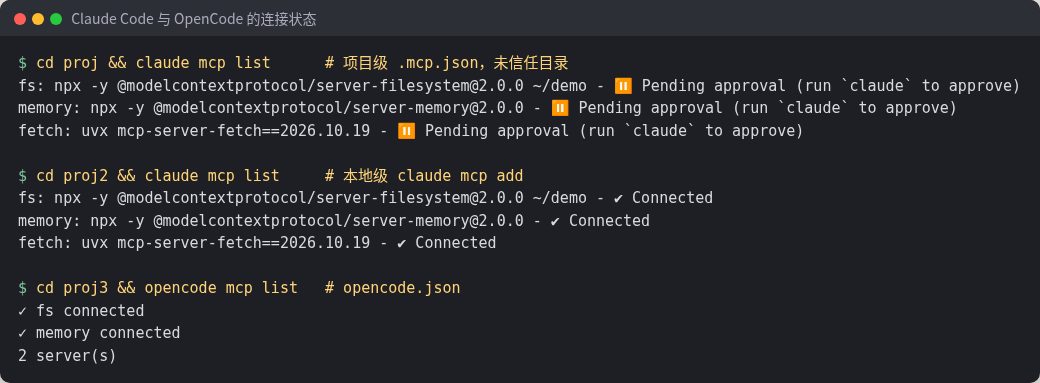
不加 --scope 时默认是 local。三个作用域和 OpenCode 的写法对比如下:
| 写在哪 | 谁能用 | 适合 | 我们实测 |
|---|---|---|---|
Claude Code local(默认),~/.claude.json 里当前项目下 | 只有你,只在这个项目 | 带密钥的、试验性的服务器 | 3 个服务器全部 ✔ Connected |
Claude Code project,项目根目录 .mcp.json | 提交进仓库,全队共享 | 团队统一工具 | 3 个都显示 ⏸ Pending approval |
Claude Code user,~/.claude.json 顶层 | 只有你,所有项目 | 个人常用工具 | 未测 |
OpenCode,opencode.json 的 mcp 段 | 看文件放在项目还是全局 | OpenCode 用户 | 2 个服务器 ✓ connected |
同名服务器在多个作用域都定义时,Claude Code 按 local、project、user 的顺序取第一个,整条配置覆盖,不做字段合并。
第三步:OpenCode 的写法
OpenCode 没有 add 命令,直接改配置。本地服务器 type 写 local,command 是数组,环境变量放在 environment 里:
{
  "$schema": "https://opencode.ai/config.json",
  "mcp": {
    "fs": {
      "type": "local",
      "command": ["npx", "-y", "@modelcontextprotocol/server-filesystem@2.0.0", "/path/to/demo"],
      "enabled": true
    },
    "memory": {
      "type": "local",
      "command": ["npx", "-y", "@modelcontextprotocol/server-memory@2.0.0"],
      "environment": { "MEMORY_FILE_PATH": "/path/to/memory.jsonl" },
      "enabled": true
    }
  }
}
远程服务器写 "type": "remote" 加 url,需要 OAuth 时用 opencode mcp auth 名字 登录。暂时不想用某个服务器,把 enabled 改成 false 就行,不用删配置。
第四步:让模型真的去调用
连上了只说明进程起得来,模型会不会用得另外看。我们用 claude -p 非交互模式接本地 Qwen3.5-4B,传一个只含 fs 和 memory 的配置文件,让它读 note.txt,再在 memory 里建一个实体:
claude -p "读 note.txt,再用 memory 的 create_entities 建实体 demo-note" \
  --model qwen35-4b-r --mcp-config mcp.json --strict-mcp-config \
  --allowedTools "mcp__fs mcp__memory"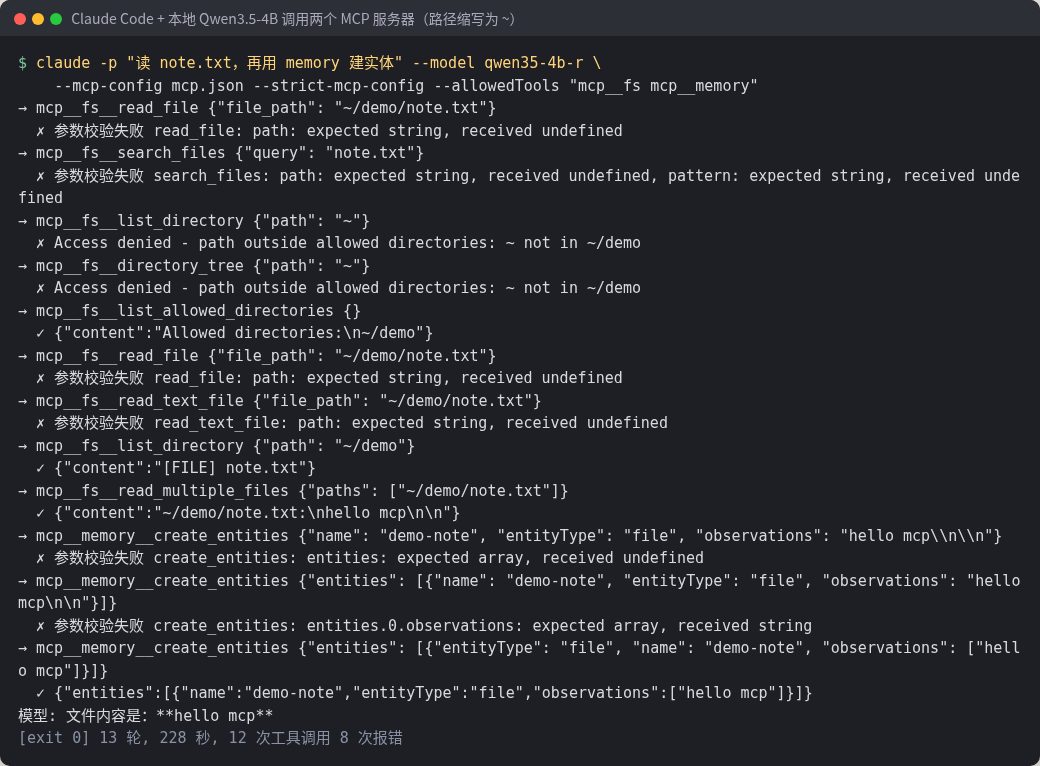
最后结果是对的:模型答出「hello mcp」,memory.jsonl 里也写进了 demo-note 实体。中间绕了不少弯:参数名填成 file_path(服务器要的是 path),去读允许目录之外的路径,把数组写成字符串。每次出错服务器都回了具体的校验信息,模型照着一点点改对。换成更强的模型,这种来回会少很多,我们这次没测。
常见坑
坑 1:项目级 .mcp.json 一直「待批准」。我们在 .claude/settings.local.json 里先后写了 enabledMcpjsonServers 和 enableAllProjectMcpServers: true,claude mcp list 仍是 ⏸ Pending approval。Claude Code 文档给了原因:在没信任过的目录里,Claude Code 要先弹信任对话框才会读这个文件里的批准,仓库里自带的批准也不算数。解决办法是在项目里交互式运行一次 claude,接受信任并批准;或者把批准写进用户级 ~/.claude/settings.json。文档还写了,claude -p 非交互运行会不经询问直接加载项目级服务器,不想加载的要写进 disabledMcpjsonServers。
坑 2:权限规则只写单个工具名,模型偏偏调别的。第一次我们只放行了 mcp__fs__read_text_file 和 mcp__memory__create_entities。模型连着三次去调已标记弃用的 read_file,三次都被拒,最后回了一句「需要您的权限」就结束了(5 轮、241 秒)。改成 mcp__fs mcp__memory,按服务器整体放行,第二次就跑通了。整台服务器放行等于把写文件、移动文件也交了出去,要配合服务器自己的允许目录一起用。
filesystem 服务器的允许目录是最后一道墙:模型两次想列上层目录,都被 Access denied 挡了回来。
坑 3:工具清单会吃上下文。filesystem 服务器一共 14 个工具,tools/list 的 JSON 有 13201 字节;memory 有 9 个工具、11529 字节。挂上这两个服务器后,Claude Code 首轮请求是 11123 个 token,本地 CPU 光读这一轮就要 90 秒上下。我们又用一句「回复 ok」单独测了三次:不挂 MCP 是 10857 个 input token;挂上这两个服务器、用 ENABLE_TOOL_SEARCH=false 关掉 tool search 后是 21300;默认开着 tool search 是 11070,工具定义被推迟到用的时候再加载,只多了两百来个。OpenCode 文档也提醒,GitHub 这类工具多的服务器很容易把上下文撑爆,用不上的服务器就关掉。
坑 4:密钥别直接写进 .mcp.json。这个文件是要提交进仓库的。Claude Code 支持在里面写 ${API_KEY} 或 ${VAR:-默认值},从环境变量展开;文档还说明,ANTHROPIC_API_KEY 这类凭据变量在远程服务器的 url 和 headers 里会被读成空,防止项目配置把你的凭据发给第三方。
完成标准
claude mcp list或opencode mcp list里,你加的服务器显示已连接,没有 Pending approval。- 让模型做一件只能靠这个服务器完成的事(比如读允许目录里的文件),它能给出正确结果。
- 故意让它碰允许目录以外的路径,能看到被拒。
- 仓库里的
.mcp.json没有明文密钥。
最后
先从 filesystem 这种本地服务器起步,用 local 作用域加上、跑通一次真实调用,再考虑把它写进 .mcp.json 分给团队。远程服务器、OAuth 和自己写服务器,可以接着看我们之前那篇40 行写 MCP 服务器接进 OpenCode 实测。