Copilot Fusion 正式可用:按请求自动挑模型
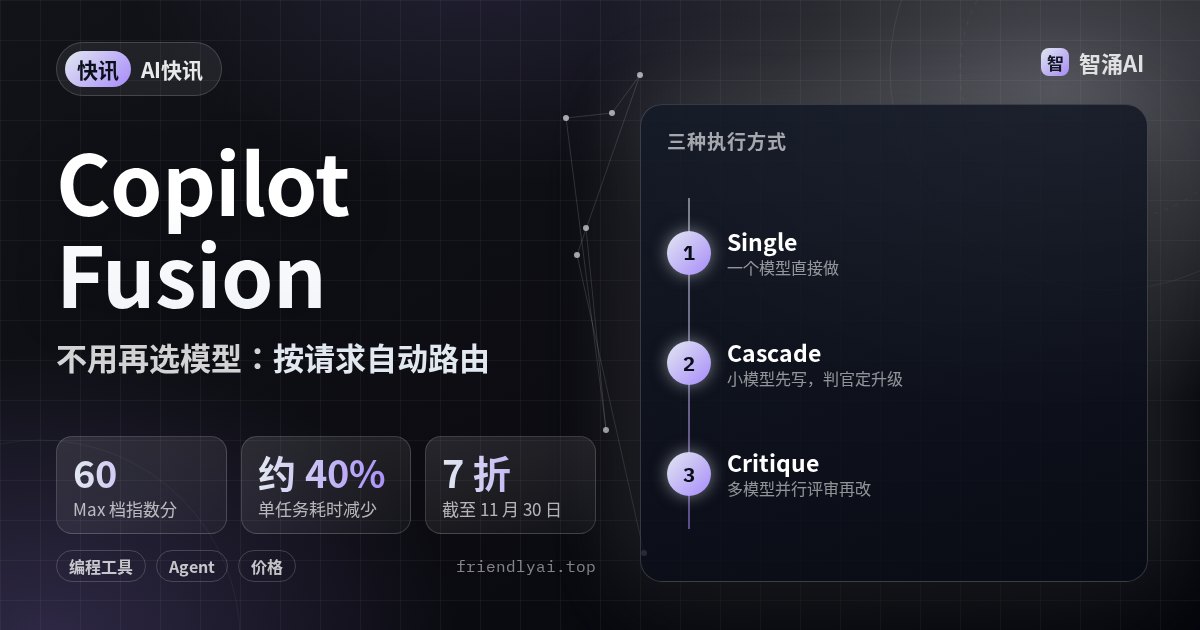
GitHub 在 10 月 28 日(美国时间)宣布 Copilot Fusion 正式可用:在模型选择器里选它,Copilot 会按每条请求自己挑模型,必要时让几个模型接力或互审,你只选一个档位。用 Copilot 写代码、又总在大小模型之间来回切的人,这项改动直接影响账单和响应时间。
选模型交给 Fusion,你只选档位
官方文档的定义是「运行时的模型路由与编排器」。每条请求进来,Fusion 根据推理、代码生成、调试、工具调用几类能力信号,挑一个刚好达到所选档位质量线的执行方式。同一个会话里,第一条用 Single,下一条可以换成 Critique。简单任务不会额外调用评审模型,也就不多花 AI 额度;Cascade 和 Critique 因为多了评审调用,会慢一些。
这次正式版合并了两条此前的线:研究预览期的 Project HydraFusion(多模型编排)和 Copilot 原来的自动选模型。之前开过 auto、HydraFusion 或 HydraFusion Max 的用户,会被自动迁到对应的 Fusion 档位。
三个档位怎么选
| 档位 | 官方定位 | 适合 |
|---|---|---|
| Fusion Standard | 平衡成本、质量和延迟,每个任务选一个模型 | 日常编码 |
| Fusion High | 适度编排,适度省 token | 修复杂 bug、跨多个文件的改动 |
| Fusion Max | 追求前沿能力,同时兼顾 token 效率 | 需要最深推理、最彻底分析的任务 |
| Fusion Fast | 只在需要快速模型的场景使用 | 用户不可选,仅用于 VS Code 行内聊天 |
文档还提到,Fusion 会尽量让主对话停留在同一个模型上,以便继续吃到缓存;评审模型只拿到它需要的那部分上下文。本地装了 MAI Code 1.1 Flash 或 Qwen3.8 Flash Next 的话,Standard 档可以把任务派给本地模型,不消耗 GitHub AI 额度。
Fusion 选模型按请求算,账单也按请求里实际用到的每个模型算。
拿分数和 Claude Code 比,要看清口径
60 分这个数字来自 GitHub 的更新日志,成本减半、耗时少 40% 同样是 GitHub 自己的对比。站内 Coding Agent Index v2.0 那篇写过,公开榜上 Claude Code 配 Opus 5.5(max)是 61.7 分。两边差距不大,但成本和速度这两项目前只有 GitHub 一方的数据。
谁该关心、怎么试
所有 Copilot 套餐都能用,客户端包括 VS Code、GitHub Copilot app、Copilot CLI 和 JetBrains IDE,其他客户端官方说后续支持。升级客户端后打开模型选择器,选 Copilot Fusion 再选档位。命令行写法是:
copilot --model fusion --fusion-tier standard -p "你的提示词"企业管理员可以限定 Fusion 能用哪些模型:它只会用企业和组织策略里已启用的模型,也能单独把某个模型从 Fusion 里拿掉而不影响其他人直接选用;还可以通过企业托管设置把任一档位设为默认。
注意:官方文档列了三条限制。Fusion 不会启动子 Agent;被丢弃的草稿如果已经改了工作区里的文件,这些改动不会自动撤销,提交前要自己检查 diff;执行方式和模型池会随时间调整。Fusion 本身没有独立的上下文窗口,显示的上限取它所用模型里最小的那个。
最后
团队里 Copilot 用量大的,先在一个仓库把默认改成 Fusion Standard 跑两周,对比切换前后的 AI 额度消耗,再决定要不要全组织设为默认。