Vera Rubin 首测 MLPerf:单卡快 2 倍
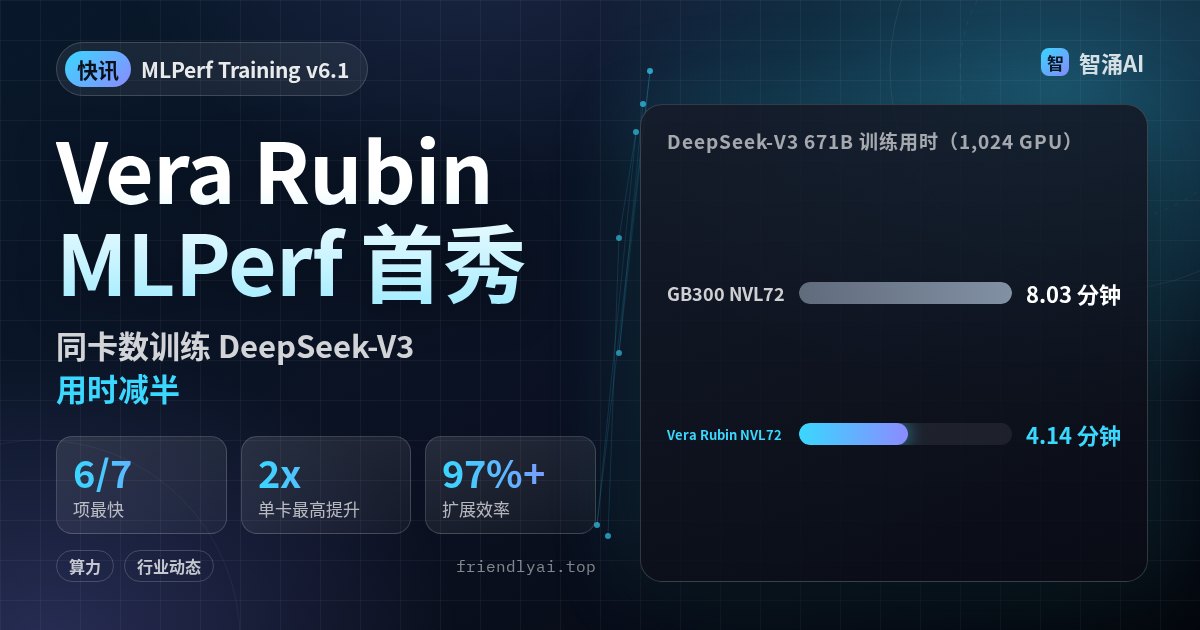
MLCommons 在 11 月 16 日公布 MLPerf Training v6.1 结果,英伟达新一代 Vera Rubin NVL72 第一次参赛。按英伟达的解读,它在七项基准里六项拿到最快训练时间。
差距最大的是通信最重的 MoE 大模型 DeepSeek-V3,接近 2 倍;gpt-oss 20B、Llama 3.1 8B 约 1.6 倍,Llama 2 70B LoRA 和 FLUX.1 约 1.5 倍,DLRMv4 和 GRPO 约 1.4 倍。第七项 DeepSeek-V3 的全场最快成绩仍是 GB300:10,240 卡跑出 1.38 分钟。Vera Rubin 从 256 卡扩到 1,024 卡,扩展效率保持在 97% 以上。
新加的 GRPO 基准测的是 Agent 模型常用的强化学习后训练:生成轨迹、打分、更新权重循环进行。英伟达说一个 Vera CPU 机架能同时跑 22,500 多个 RL 环境,用来喂 GPU。英伟达称本轮闭卷组 80% 的提交跑在它的平台上,来自 20 家合作方。
注意:倍数是英伟达按 MLCommons 提交结果自己换算的;博客里另提到用新软件栈的复跑成绩,那部分未经 MLCommons 审核。