OpenAI 发布 LifeVal:用日常生活任务测 AI
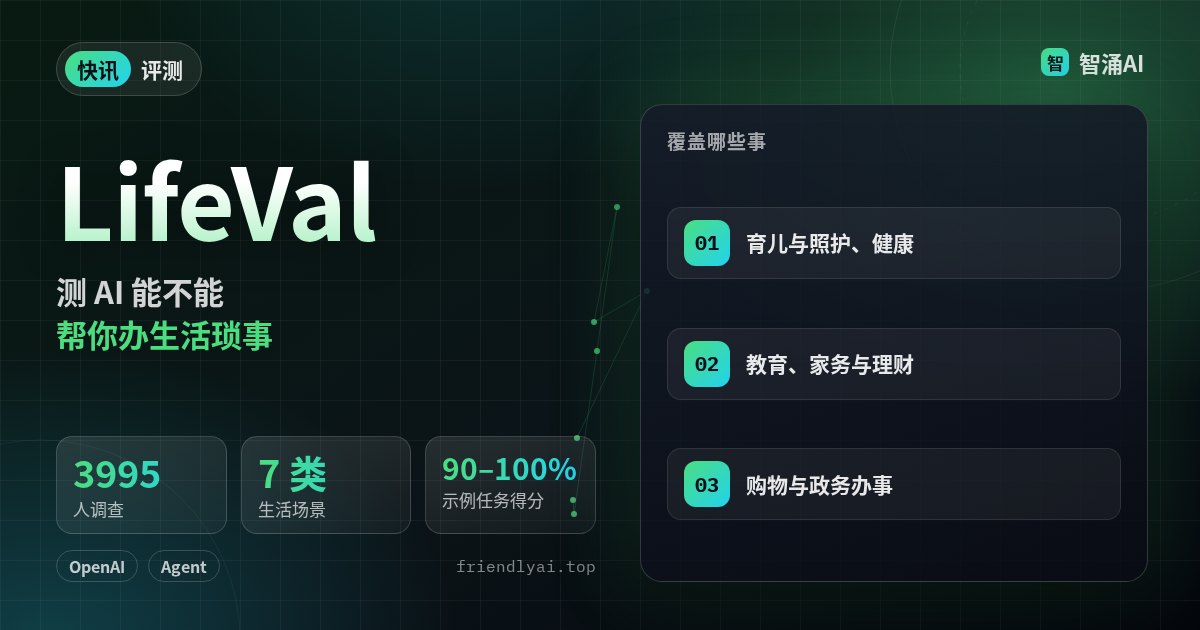
OpenAI 在 11 月 2 日公布了一个叫 LifeVal 的评测,用来衡量模型在日常生活任务上的表现,比如找托育、办政务、做预算、改菜谱、买菜、排健身计划。OpenAI 说过去一年一直在用它跟踪和推动模型改进。
LifeVal 想补的是学术基准的空白:知识题考得再好,不代表 AI 能真把事办完。示例任务大多要求模型动手,比如按预算和通勤条件找房,再把房契加进购物车待用户确认。OpenAI 说这一年重点训练了浏览器操作、电脑操作和连接器任务,ChatGPT 正在从聊天工具往个人代理走。
对做 Agent 的团队,这套「先调查真实需求、再定任务」的思路可以借鉴:评测集贴近用户真正想交出去的事,比刷通用基准更能说明产品价值。
注意:LifeVal 是 OpenAI 的内部评测,目前没有公开完整任务集、评分细则和其他厂商模型的对比,示例分数只代表官方挑选的几个任务。
信息来源