OpenAI 自研 Git 后端 Pando:推送延迟降约 80%
OpenAI 在 2026-11-02 发工程长文,介绍内部 Git 后端 Pando:为扛住 Codex 带来的并发推送与拉取,在不改工程师 / Agent 的 Git 用法前提下重做 monorepo 服务端。站内短讯已概括要点;下面按官方长文把数字、设计取舍和「谁该关心」写全。
发生了什么
过去一年 OpenAI monorepo 的体量和并发被 Codex 放大:更多分支与推送、更多合并、更多开发环境 / 研究任务 / CI 的 fetch 与 clone。一个工程师可以同时推进多条改动,每次推送又会拉起多组作业去拉同一提交。文中写:大约从去年底起,支撑 monorepo 的系统开始跟不上,出现慢推送、慢拉取和失败的合并,可靠性一度跌到 90% 以下。
团队没有换一套新的源码工作流,而是自研后端 Pando:对外仍是 Git,对内把「全仓库一致快照」和「为每个客户端单独打 pack」这两条常见假设拿掉,换因果一致的按分支写入,以及可跨客户端复用的 pack 存储。部署先以读写穿透代理接到旧系统,再逐步切流量;开发机和 ChatGPT 桌面端开始带上他们的公开 Git 发行版,并用内部 Git CLI 包装分阶段迁移。Codex 还配了迁移用 Skill,让开发者可以直接让 Agent 改本地环境。
为什么重要
Agent 让「一个人并行开很多分支」变成常态,源码系统的瓶颈会从「磁盘上的对象多」变成「同一秒有多少人在推不同的 ref、又有多少人在拉同一段历史」。若 monorepo 服务端仍用「所有分支更新排成一条队」或「每次 fetch 现场算 pack」的模型,CI 和 Agent 会一起把可靠性打穿。对正在把 Coding Agent 铺进 monorepo 的团队,文中的生产数字更有用:在保留 Git 协议的前提下,仍可能把写和读水平扩上去。
并行的是分支和 Agent,不是「再买一台更贵的 Git 服务器却沿用全仓锁」。
可核实数字
| 指标 | 官方长文表述 | 备注 |
|---|---|---|
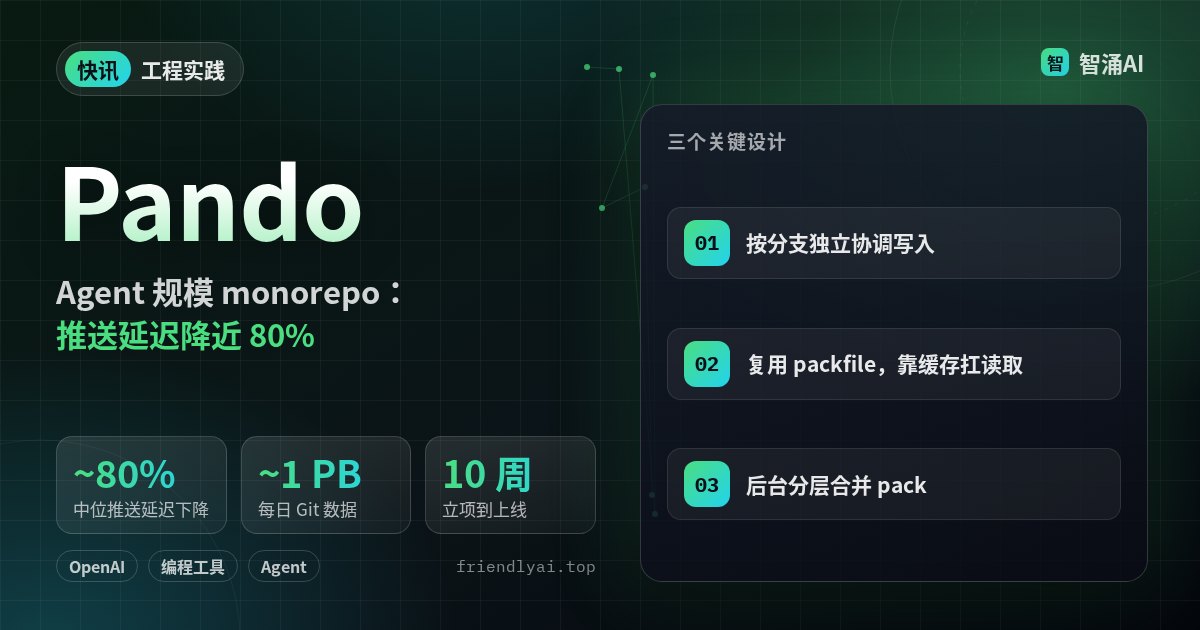
| 中位推送延迟 | 降低近 80% / nearly 5× | 切换到 Pando 后;厂商自报 |
| 日分发量 | 近 1 PB Git 数据 | 厂商自报 |
| 峰值 | 单小时 >57 TB pack | >99% 字节来自本地盘缓存 |
| 缓存命中 | 区域缓存命中率 >99% | Express 等本地缓存 |
| 网络验证 | 普通云主机跑满 10 Gbps | clone/fetch 验证口径 |
| 工期 | 10 周立项到生产;约 4 月接流量 | Rust 从零实现;形式化与仿真测试 |
| 可靠性(改造前) | 有时 <90% | 慢推送 / 失败合并等 |
| 广告的 trunk 场景 pack | 中位 <20 KiB;P99 <3 MiB | 默认只广告 trunk 作基线时的推送 pack |
文中对比 3PC、对象存储 WAL 与 Pando 的动画是教学用合成模型,不是生产基准;性能数字均为 OpenAI 自报。Pando 目前只在内部使用,文末写在探索如何对外提供。
一个主对比
| 常见扩缩(文中建模的 3PC / WAL) | Pando | |
|---|---|---|
| 写入协调 | 全仓排序或共享 manifest,不相关分支也会互相等待 | 按分支独立协调;只有同分支并发推送才冲突 |
| 一致性 | 追求全仓瞬时一致视图 | 单 ref 可串行化;跨分支读到的是因果切片,不保证同一瞬间的全仓快照 |
| 读取 | 常为每个客户端算一份 pack,CPU/磁盘易打满 | 复用推送入库的 pack,经 packfile-uri 走区域缓存 |
| 扩容方式 | 副本磁盘与协调延迟绑在推送路径上 | 加 Pando 节点、元数据与对象存储;协商与传数可分开扩 |
| 客户端 | 往往要改工具链或换系统 | 保持 Git 协议;上游已合入部分 packfile-uri / 并发下载等改进 |
谁该关心 / 怎么试
跑大型 monorepo、已经让 Agent 批量开分支 / 推送、CI 频繁 clone 同一历史的团队,建议把文中的两个问题拿来对照现状:推不相关分支时是否互相阻塞;fetch 是否每次都在服务端重算 pack。Pando 本身还不能注册使用;能立刻做的是:
- 读完官方长文里的「因果一致 + pack 复用」两段,评估自建 Git 托管或云厂商方案是否卡在全仓锁上。
- 关注上游 Git 与 OpenAI 公开 Git 分支里已合入的
packfile-uri、并发下载与显式 haves 等改动,升级客户端后再测 clone/fetch。 - 内部若在做「多 Agent 共仓」,优先压测「多分支并发推 + 多读者拉同一 trunk」,而不是只看单线程 git push 延迟。
最后
打开 Scaling Git at OpenAI,对照自己 monorepo 的推送队列和 fetch CPU;若 Agent 已经把并发写上去了,先改协调粒度与 pack 复用策略,通常比只加机器更接近文中的结论。