Ripple-65B 开源:单机可跑的编程模型
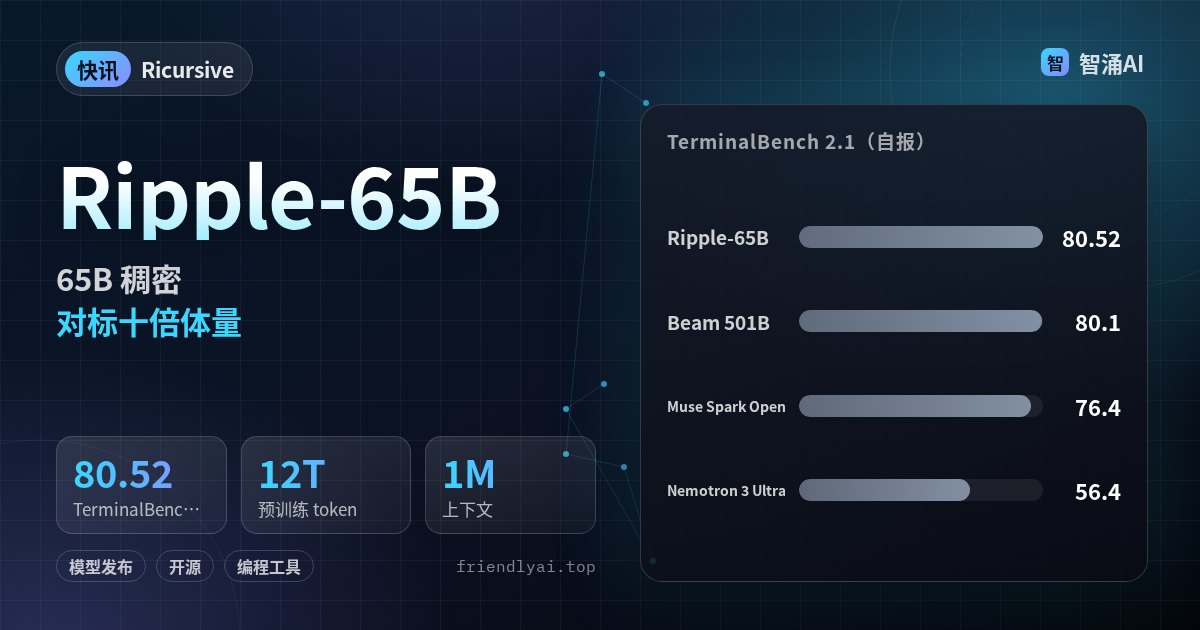
做芯片设计 AI 的 Ricursive Intelligence 本周在 Hugging Face 开源 Ripple-65B Preview:65B 稠密 Transformer,12T token 从头预训练,最长 1M 上下文,许可证 Apache 2.0。它是该公司芯片设计平台内部模型的通用版本。
架构上走「窄而深」:d_model 5120、80 层,从 Olmo 3 式结构换成接近 Gemma 3N 的设计,并加了门控注意力、FFN 激活裁剪等。官方称在 2 张 B200、batch 8、未量化时生成速度约 250 tok/s。对想在本地或单机跑编程 Agent 的团队,65B 稠密比数百 B 的 MoE 好部署得多。官方还提供了 NVFP4 权重和 Colab 示例,社区已经放出 GGUF、MLX 等量化版本。
Apache 2.0 没有营收或月活门槛,可商用和再分发,需保留许可与版权声明。对比本周开源的 Kimi K3.1 Pro,Ripple 体量小一个数量级,定位是单机可跑。
注意:分数是厂商自报;官方说明 Preview 版后训练较轻、重点在 Agent 编程,通用对话能力还要看后续版本。