SPU 基准:Agent 预测湿实验最高 0.478
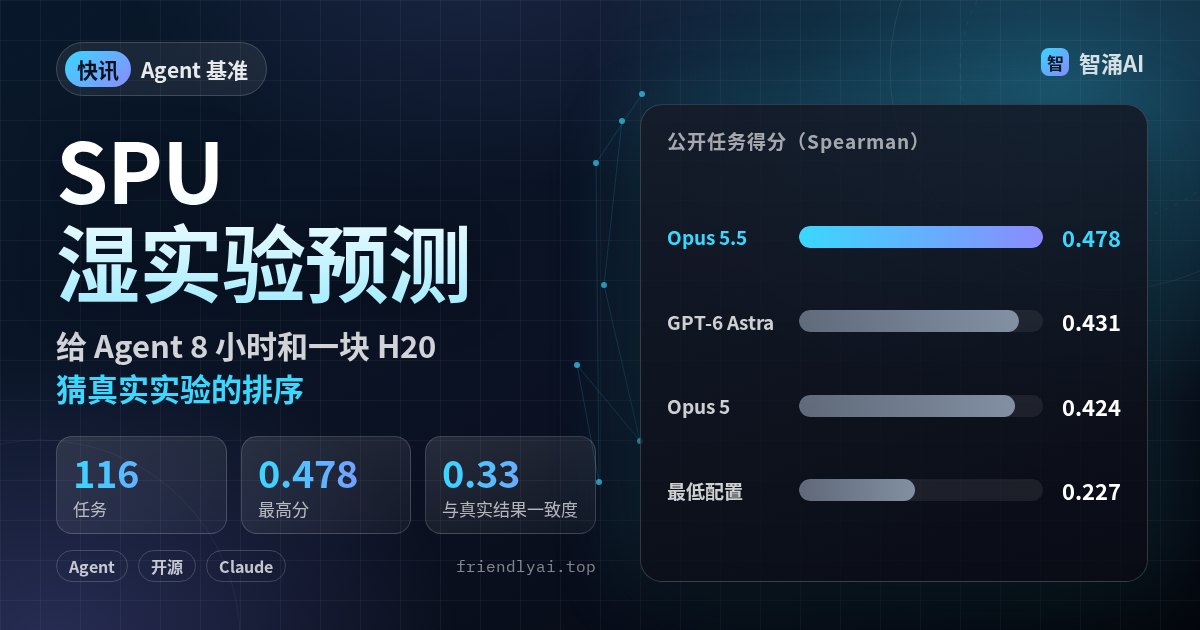
AI 研究机构 UniPat AI 在 11 月 12 日发布基准 Science Prediction Universe(SPU):给 Agent 一组真实湿实验的条件和候选方案,让它在看不到结果的情况下,按实测指标给候选排序。
每个 Agent 有 8 小时、8 核 CPU、16 GiB 内存和一块 H20 GPU,可以检索文献、跑科学计算软件;结果交给一个断网的独立容器打分,不用模型当裁判。一共测了 12 个模型、13 种配置:GPT-6 Astra 和 GPT-6.1 Sol 跑在 Codex 里,其余跑在 Claude Code 里。第二名是 Codex 里的 GPT-6 Astra(medium),0.431。
论文分析了 1,155 条公开任务轨迹、227,103 次工具调用,认为瓶颈在科学判断,工具用得并不差:各个 Agent 给出的排序彼此更像(0.52),和真实实验的一致度只有 0.33。另一个发现是 max 推理档的运行时间中位数长了 4.8 倍,分数却没有可检测的提升。
注意:Opus 5.5 和 Fable 5.1 有大量运行因安全拒答中断,只在 44 个和 30 个公开任务上计分,平均分主要来自材料科学任务,排名要打折看。公开任务的答案已经公开,以后可能进入训练数据,官方建议报告成绩时注明。