billion-context 是什么:长会话可解压的上下文压缩代理
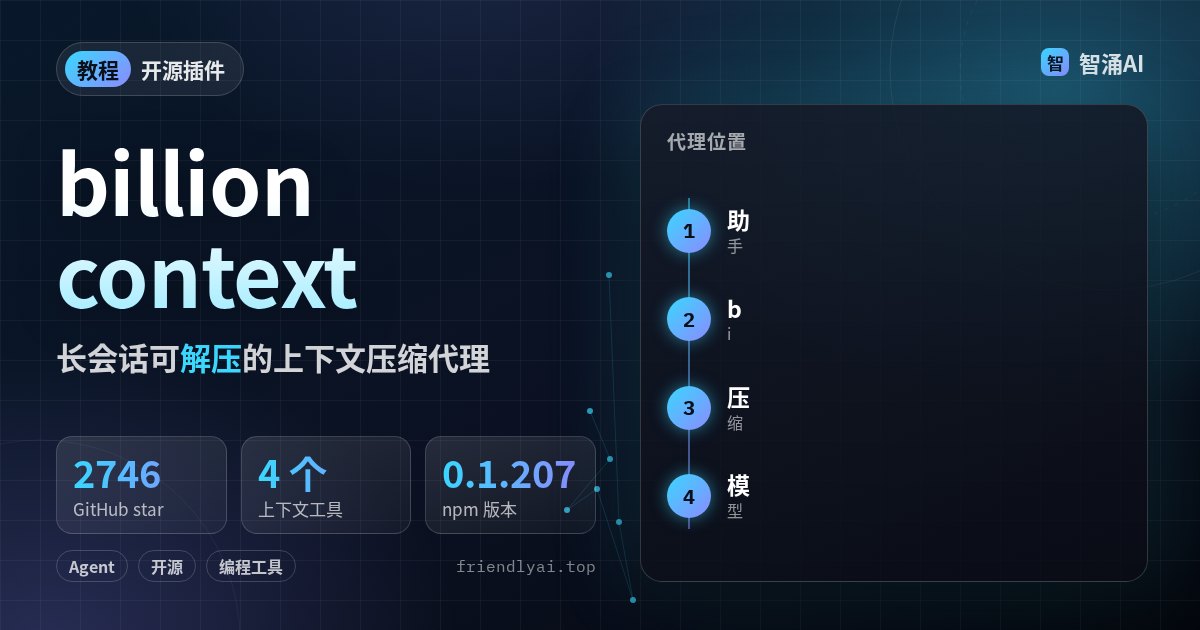
编程 Agent 开长会话,上下文窗口会先被撑满。开源插件 billion-context(MIT,npm 包名同名)架在助手和模型 API 之间:用 acp-kernel 做增量压缩,并注入 compress / decompress / search_context / acp_status,由模型自己决定何时折叠、何时展开。截至 2026-10-25,GitHub 约 2746 star,npm 最新版 0.1.207。本文按仓库 README 整理原理与接入方式,安装与长会话我们未在本机跑通,标「未实测」。
说明:星标、版本、命令与论文数字均核自 GitHub / npm / README(核验日 2026-10-25)。省 token 倍数、缓存命中率、纵向研究体量均为项目方自报,不是本文实测。
它是什么
README 的结构图很清楚:Claude Code、Codex、OpenCode 等助手把流量指到 billion-context 代理;代理解析 Anthropic 或 OpenAI 形态请求,跑压缩,注入上下文工具,再转发到真实模型 API,并重写流式响应。压缩内核是独立的 acp-kernel;本仓库许可证正文为 MIT,并附加「产品界面需署名」条款——商用嵌入前先读 LICENSE。
和站内写过的 Headroom 不同:Headroom 侧重进模型前压缩工具输出;billion-context 管的是整段会话历史的分层折叠,并强调压缩块可按需 decompress,不是一次性扔掉细节。
| 仓库 | ranxianglei/billion-context |
|---|---|
| 许可证 | MIT + 产品界面署名附加条款(以仓库 LICENSE 为准) |
| npm | billion-context 0.1.207(2026-10-25 核) |
| GitHub star | 约 2746(2026-10-25 API) |
| 定位 | 编程 Agent 会话代理 / 插件:模型驱动的上下文压缩 |
硬截断是丢书;这里的目标是把读过的章节折成可展开的目录,必要时再翻回原文。
四个工具:谁决定压什么
compress:把一段消息范围折成详细摘要;代理在服务端执行,历史里保留折叠态直到恢复。decompress:需要精确细节时展开某段。search_context:在摘要与可见消息里做关键词检索。acp_status:用量概览,以及哪些区间还能压。
README 强调:何时压、压什么由模型调工具决定,而不是固定字符阈值一刀切。健康会话的前缀缓存命中率,项目方写在约 95–97%,压缩本身代价宣称 ≤2%;持续偏低时用他们的 /acp / /acp-cache 查归因——这些是官方自述,我们未复测。
怎么接(命令来自 README)
全局安装示例:
npm install -g billion-context --prefix=~/.local之后按客户端二选一(细节以仓库 CLIENTS.md 为准):
- 原生插件:
bili plugin install pi|opencode|claude|…——装进客户端配置,日常启动方式不变。OpenCode 还要关掉原生 auto-compaction,避免双重压缩。 - 启动器:
bili claude、bili codex、bili opencode等——拉起独立端口代理再改写客户端指向。Codex 等没有完整插件接缝的客户端,README 更推荐启动器做全功能姿势。
支持列表很长(pi、OpenCode、Claude Code、Codex、Gemini CLI、Kimi、Qwen Code 等),以当前 README 表格为准;桌面版 Claude Code 标签页等已知限制也写在仓库 issue 说明里,接入前扫一眼。
仓库论文里的自报规模
paper/ 下有开源的活文档(英文题为 Model-Driven Incremental Hierarchical Compression…)。README 摘要的纵向研究数字:约 4.5 个月、三台宿主、174,327 次模型调用、累计约 187.6 亿输入 token(三宿主合计约 247 亿)、在 204,800 token 窗口上宣称零越界,马拉松会话约 8,584–12,049 次调用。这些一律视为项目方自报;我们没有复现实验环境,也不据此承诺你的账单会省多少。
常见坑(读 README 就能避开的)
- 和宿主摘要叠加。OpenCode 等需关 auto-compaction,否则双重压缩。
- 只装 MCP、不起代理。部分客户端(如 Codex 的插件形态)不能单独完成流量改写,需先按文档起 bili。
- 把星标和论文数字当成自己的收益。省 5× token、月级会话是项目宣传口径;换模型、换 TTL、换工作流后结果会变。
- 忽略附加署名条款。MIT 之外要求产品可见处注明使用了 billion-context / acp-kernel。
完成标准
- 能用自己的话画出「助手 → billion-context → 模型 API」。
- 能说出四个工具的分工,以及「可 decompress」和一次性摘要的差别。
- 能根据自己用的客户端,从 README 表里选出插件或启动器,并知道要核对 LICENSE。
最后
若你只是工具输出太长,先看 Headroom 实测;若痛点是「同一会话要撑很多天」,再评估 billion-context,并在本机用小项目试挂代理。装之前先读仓库 LICENSE 与 CLIENTS 里你的客户端一节。