graphify 实测:1.3 秒把代码库变成知识图谱,0 token
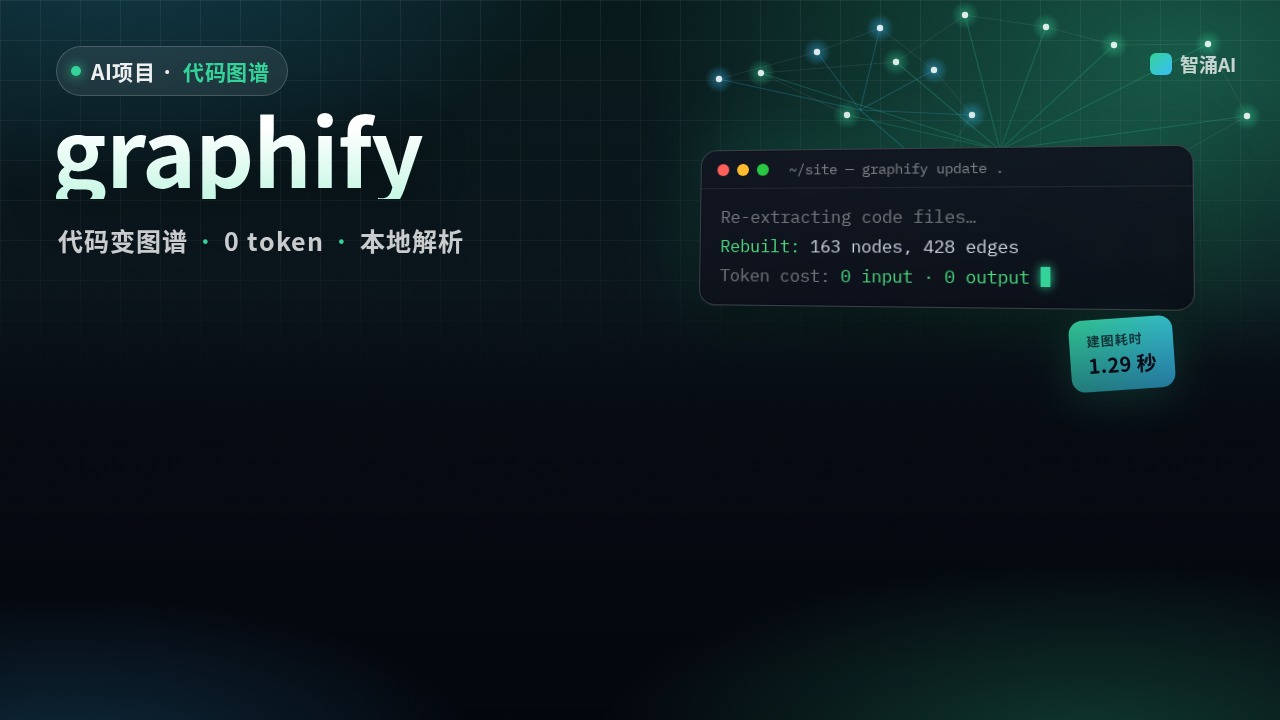
让编程 Agent 读一个陌生项目,它通常先 grep,再一个个文件打开看,token 大多花在「找东西」上。graphify 先把代码解析成一张图,函数、文件、调用和引用都是节点和边,Agent 之后直接查这张图。我们 10 月 21 日拿本站自己的 17 个构建脚本试了一下:1.3 秒建完图,没有调用任何大模型。
它是什么
一句话:把代码库(也可以加上文档、PDF)变成一张可以查询的知识图谱,同时以 Skill 的形式装进 Claude Code、Cursor、Codex、OpenCode 等 Agent,在 Agent 里输入 /graphify 就能用。
| 仓库 | github.com/Graphify-Labs/graphify(PyPI 包名 graphifyy,两个 y) |
|---|---|
| 作者 | Graphify Labs(作者 Safi Shamsi 及贡献者) |
| 许可证 | Apache-2.0(改许可证之前贡献的代码仍按 MIT,见仓库 NOTICE) |
| 热度 | GitHub 130,349 星;PyPI 近 30 天下载约 163 万次(pypistats,截至 2026-10-21) |
| 语言 | Python ≥ 3.10 |
| 最新版本 | 0.9.93(PyPI 发布于 2026-10-21 00:30,北京时间) |
解决什么问题
向量检索擅长回答「哪段代码跟这句话像」,回答不了「A 怎么一路调到 B」。graphify 选的是图:每条边都标明来源,EXTRACTED 表示代码里明写着,INFERRED 表示工具推断出来的,看结果的人能分清哪些是事实、哪些是推测。适合的人:接手老项目的开发者,以及想给 Agent 省掉反复读文件那部分 token 的人。
怎么用
uv tool install graphifyy            # 或 pipx install graphifyy
cd 你的项目
graphify update .                    # 只解析代码,本地完成,不需要 Key
graphify explain "check_tags"        # 某个节点的上下游
graphify path "batch-news.py" "check_tags"
graphify query "how are tags validated"
graphify install --platform opencode # 把 Skill 装给 Agent,之后在 Agent 里用 /graphify .
输出在 graphify-out/:graph.json(完整的图)、graph.html(浏览器里可以点开的可视化)、GRAPH_REPORT.md(核心节点、意外连接、建议问的问题)。
实测:本站 17 个脚本,1.3 秒出图
环境:2026-10-21,Debian 13,Python 3.13.5,graphify 0.9.93。对象是本站 scripts/ 下的 17 个文件,约 9,200 词。
- 建图:
graphify update .用了 1.29 秒,得到 163 个节点、428 条边、8 个社区。98% 的边是 EXTRACTED,推断出来的只有 7 条(平均置信度 0.85)。报告写着Token cost: 0 input · 0 output。 - 查询准不准:
explain "check_tags"返回 11 条连接,带文件名和行号:被 new-article.py、add-card.py、batch-news.py、apply-tags.py 引用,内部调用by_name()。我们对照源码核过,都对得上。 - 坑 1:社区名没有意义。不配模型时,8 个社区叫
re、json、sys……,用的是标准库模块名。想要能看懂的名字,得配模型重新跑命名。 - 坑 2:重名节点。
path "main" ...提示'main' matches 15 nodes,要改用它给的完整 ID。 - 坑 3:结果比预算大。
query返回 41 个节点、129 条边,约 4,953 token,超出默认 2,000 的预算。它会提示你缩小范围,但不会自动截断。 - 装给 Agent:
graphify install --platform opencode写入~/.config/opencode/skills/graphify/,包括 SKILL.md 和 8 份参考文档。opencode debug skill能看到它。SKILL.md 有 46,991 字节,上下文小的本地模型带它会比较吃力。 - 未实测:在 Agent 里跑
/graphify,以及对文档、PDF 做语义抽取。这两项要用大模型(Agent 自己的模型或 Gemini、Claude 等的 Key),我们没开付费账号。README 说查询会记录到~/.cache/graphify-queries.log,我们跑完 explain、path、query 后没找到这个文件,只看到graphify-out/cache/last_query_stamp。
只建代码图的话,这个工具完全离线、不花钱。要调用模型的是文档、PDF 这类内容的语义抽取。
适合谁,不适合谁
| graphify | grep / 让 Agent 直接读文件 | 向量检索(RAG) | |
|---|---|---|---|
| 擅长 | 调用链、影响范围、模块划分 | 小项目、精确查字符串 | 按意思找相似段落 |
| 成本 | 代码部分 0 token | 每次都要读原文件 | 要算 embedding、要部署向量库 |
| 不适合 | 几个文件的小脚本,建图不值得 | 大仓库 | 需要说清依赖关系的问题 |
README 里有不少推广 Graphify Cloud(14 天试用)的内容,基准测试数据也是官方自己测的。本地用开源版就够了,不用注册。
最后
在你最常改的那个仓库里跑一次 graphify update .,打开 GRAPH_REPORT.md,看「God Nodes」里排前几位的函数是不是你心里认为最核心的那几个。
- GitHub Graphify-Labs/graphify:README(安装、命令、隐私、Graph Cloud 说明)
- graphify NOTICE:Apache-2.0 与 MIT 说明
- PyPI graphifyy:0.9.93 版本与发布时间
- pypistats:graphifyy 下载量
- Graphify 官方文档
- 本文实测:graphify 0.9.93,Python 3.13.5,OpenCode 1.19.3,Debian 13,2026-10-21