Headroom 实测:日志压 97%,真实 JSON 只压 2%
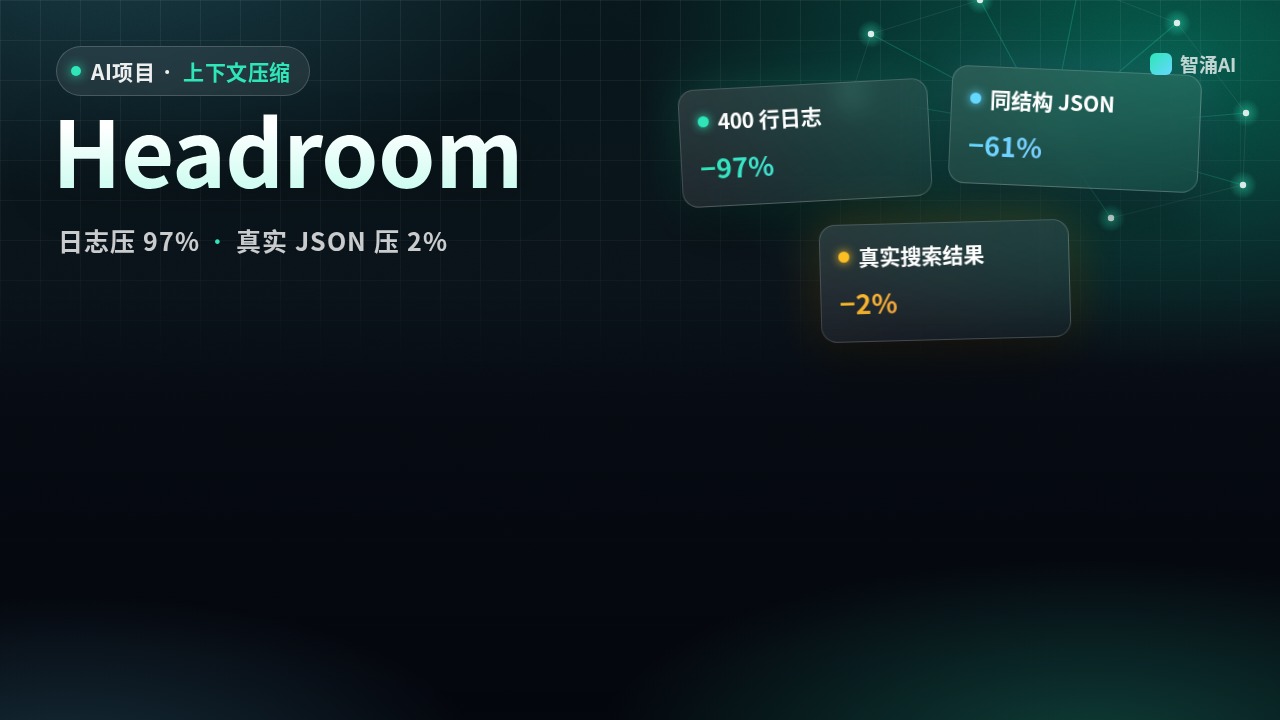
编程 Agent 的 token 很多花在工具输出上:一次搜索返回 100 条 JSON,一份几百行的日志,模型真正要看的可能只有其中一行。Headroom 在内容发给模型之前先压缩一遍,压缩在本机完成。我们 10 月 21 日拿三份数据测了它的 Python 库:日志压掉 97%,真实的 GitHub 搜索结果只压掉 2%。
它是什么
一句话:放在 Agent 和大模型之间的上下文压缩层。可以当 Python/TypeScript 库调用,可以当本地代理(headroom proxy),也可以用 headroom wrap claude 这类命令直接包住一个编程 Agent,另外还提供 MCP 服务器。
| 仓库 | github.com/headroomlabs-ai/headroom(PyPI / npm 包名 headroom-ai) |
|---|---|
| 作者 | Headroom Labs |
| 许可证 | Apache-2.0 |
| 热度 | GitHub 76,801 星;PyPI 近 30 天下载约 29 万次(pypistats,截至 2026-10-21) |
| 语言 | Python ≥ 3.10(核心部分有 Rust),另有 TypeScript SDK |
| 最新版本 | 0.41.0(GitHub Release 2026-10-15,北京时间) |
解决什么问题
上下文越长,调用越贵、越慢,模型也更容易漏看关键信息。Headroom 先判断内容是什么类型,再选压缩方法:JSON 用 SmartCrusher 改写成「表头 + 行」,代码按语法树压,普通文字用它自己的小模型压。原文缓存在本地,模型需要时可以调 headroom_retrieve 取回。适合的人:工具调用多、日志多的 Agent 开发者,以及按 token 付费、想压成本的团队。
怎么用
pip install headroom-ai              # 只要库;要全部功能装 "headroom-ai[all]"
export HEADROOM_BEACON=off           # 关匿名统计上报(默认开)

from headroom import compress
r = compress(messages, model="gpt-4o")   # messages 用 OpenAI 格式
print(r.tokens_before, r.tokens_after, r.compression_ratio)
# r.messages 直接交给你的模型客户端

headroom proxy --port 8787           # 或者起本地代理,不改代码
headroom wrap claude                 # 或者直接包住 Claude Code / Codex / OpenCode 等
实测:三份数据,结果差别很大
环境:2026-10-21,Debian 13,Python 3.13 虚拟环境,headroom-ai 0.41.0(基础包,没装 [all],装完 326 MB)。每份数据都按「工具调用返回结果」的格式交给 compress()。
| 数据 | 压缩前 | 压缩后 | 省下 | 关键信息 |
|---|---|---|---|---|
| GitHub 搜索 mcp-server 前 100 个仓库(真实接口返回,51 KB) | 14,141 | 13,788 | 2% | 排第一的 n8n 还在 |
| 400 行访问日志,第 288 行是 FATAL(我们用脚本生成) | 10,040 | 约 255 | 97% | FATAL 那一行原样保留 |
| 300 行同结构 JSON,其中 1 行 timeout(脚本生成) | 10,230 | 3,949 | 61% | timeout 那一行保留 |
- 压缩后长什么样:日志只留下 FATAL 前后几行,加一个标记
[394 lines omitted: 1 ERROR, 399 INFO]和一个可以取回原文的 hash。标记里的计数有点怪:明明是 FATAL,写成了 ERROR,总数也对不上 400 行。真要排查问题,还是取回原文看。 - 速度:第一次调用 1.2 秒(要加载组件),之后的日志那次只要 45 毫秒。启动时会提示没有 ONNX Runtime 1.24+,改用纯 Python 检测,不影响结果。
- 统计上报:
headroom telemetry显示「Upload beacon: ON (opt-out)」,上报地址是一个 workers.dev 域名,--show能看到具体发哪些字段。 - 未实测:
proxy/wrap接真实 Agent 和付费模型(需要 API Key)、headroom learn、文字压缩模型 Kompress(要装[all])。README 里的节省比例(21%–57%)是官方自己测的,我们没有复现。
先想清楚你的 Agent 读的主要是什么。重复多的日志、列表很适合它,每条都不一样的数据基本省不了多少。
适合谁,不适合谁
适合:Agent 经常读日志、测试输出、长列表 JSON;按 token 付费并且量大。不适合:主要读源码和文档这类信息密度高的内容;或者服务器不允许任何对外上报,又没法确认统计已经关掉。
替代办法:在工具这一侧控制输出大小,比如加 head/jq 过滤,或者用 Claude Code 等 Agent 自带的输出上限设置。上下文太长时靠 Agent 自己的压缩(compaction)。查代码结构可以先建代码图,参考本栏的 graphify 实测。
最后
从你的 Agent 日志里挑一份最长的工具输出,用上面 5 行 Python 跑一次 compress(),看 compression_ratio 有多少,再决定要不要接代理。
- GitHub headroomlabs-ai/headroom:README(功能、安装、官方基准、兼容 Agent 列表)
- headroom Release v0.41.0
- PyPI headroom-ai
- pypistats:headroom-ai 下载量
- Headroom 官方文档
- 本文实测:headroom-ai 0.41.0,Python 3.13,Debian 13,2026-10-21;GitHub 搜索数据取自 GitHub REST API