你的产品也有 Agent 用户:端到端评测找出它卡在哪
越来越多的人不再自己读文档调接口,而是丢一句话给 Claude Code 或 Codex,让它去用你的 API、CLI 或 SDK。Agent 做错了,日志里往往一片正常:请求成功、订单下了,只是下成了热拿铁。Vercel 和 Together AI 在 11 月 16 日各发了一篇长文,讲怎么给「Agent 用户」做端到端评测。这篇把两篇的做法合起来,整理成可以照着搭的五步。
Agent 也要走完一遍用户漏斗
Vercel 把 Agent 使用一个产品的过程分成四段:发现(Discovery)、选择(Selection)、接入(Access)、完成任务(Success)。每一段都会掉人,和人类用户一样。评测可以覆盖任意一段,两篇文章重点讲的是最后一段:Agent 有没有把用户交代的事做对。
这一段难在结果会变。同一个提示词跑两次,可能一次对一次错,手动试一回说明不了问题。评测的定义很朴素:同一批任务跑很多次,给结果打分,改动前后各跑一遍做对比。
先挑最便宜的那一层
Vercel 按一次测试要调几次大模型来分层,和传统测试金字塔一个思路,便宜快的放底下、占大头:
| 层 | 大模型调用 | 回答的问题 | 例子(一个点咖啡的 CLI) |
|---|---|---|---|
| 确定性测试 | 0 次 | 软件本身行为对不对 | quote 算税和小费算得对不对 |
| 单轮评测 | 1 次 | Agent 第一步选的命令和参数对不对 | 看到菜单价后,会不会先报价再下单 |
| 端到端评测 | 2 次以上 | 整件事最后做没做对 | 是否只下了一单:大杯冰拿铁、9 点前取、含小费不超 8 美元 |
用法是从想抓的问题倒推:能用确定性测试抓住的,就别上端到端。「任务做没做对」只能看完整流程,因为每一步单看都合理,最后照样可能错。SWE-bench、Terminal-Bench 这类编程基准就是端到端评测。
五步搭一个端到端评测
1. 定一个窄目标。别想着全覆盖。目标从三处找:可观测数据(哪些 Agent 在用、在哪失败)、客户反馈(工单、流失)、路线图上最想验证的假设。Vercel 的例子里,头号工单是「Agent 给我点错了饮料」,目标就定成提高这一项的成功率,取消、退款先不管。
2. 选指标。三个成功类指标回答的问题不同:
- success rate:通过的比例。
- pass@k:k 次里至少过一次的概率,问的是「它到底能不能做到」。
- pass^k:k 次全过的概率,问的是「我能不能每次都信它」。
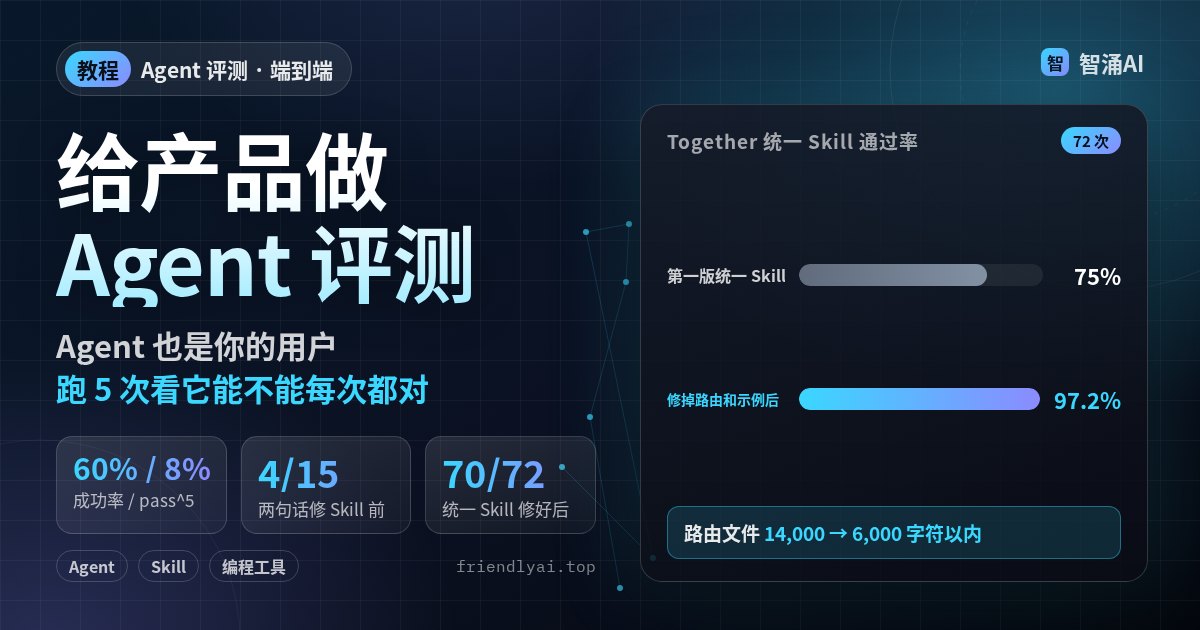
Vercel 的示例里 5 次过了 3 次,成功率 60%;按独立试验估算,pass@5 约 99%,pass^5 只有约 8%。两个数都对。点早餐咖啡这种事做错没有重来的机会,所以盯 pass^k;编程 Agent 有测试兜底、能自己改,盯 pass@k;起草邮件用户发之前会看,看成功率就够了。效率类指标(步数、耗时、成本)只在成功的试验里算,失败的往往是偷懒少走了步骤,混进去会拉低平均值。
只跑 5 次就是 100%,意思是「还没见过失败」,不是「永远不会失败」。
3. 写任务集。Vercel 用的是 Harbor,Terminal-Bench 作者做的开源框架,在容器里跑 Agent、检查结果、记录过程。一个任务是一个文件夹:
tasks/iced-latte-mission/
├── instruction.md   # 用户原话,点名用哪个工具、现在几点
├── task.toml        # 超时、检查脚本、要保存的产物
├── environment/     # Dockerfile + 被测 CLI + 预置数据(时钟冻结在 8:30)
├── solution/solve.sh  # 已知正确解,先证明任务能做
└── tests/test.sh      # 检查脚本,按约束分别打分
检查脚本把每条约束单独打分,全部满足才给 1,写进 /logs/verifier/reward.json。这样失败时一眼看出是哪条没满足,比如饮料对、时间对、超了预算。任务集要有常见情况、容易绊倒 Agent 的边缘情况,还要有至少一个「正确做法是不动手、告诉用户做不到」的任务。
4. 跑起来。Vercel 给的命令(他们测试用的版本):
uv tool install --python 3.12 'harbor[vercel]==0.24.0' --with 'vercel==0.10.0'
vercel login && vercel link && vercel env pull
harbor run -c job.yaml   # 4 个任务 × 4 种配置 × 5 次 = 80 次试验
harbor view jobs         # 看结果和每次的轨迹
job.yaml 里列出要对比的配置(Claude Code、Codex 各配不同模型),每个试验跑在单独的 Vercel Sandbox 里,模型调用走 AI Gateway。按文中说法,Hobby 套餐最多同时跑 10 个沙箱。示例里把 OIDC 令牌作为环境变量传进沙箱,文章自己也提醒这只适合演示,正式用要换短期凭据并用防火墙规则限制每个沙箱能访问的主机。
5. 读轨迹。分数告诉你多常失败,轨迹告诉你为什么。失败的要看,通过的也要抽查。试验多了,Vercel 的做法是让最多 40 个用快模型的「阅读 Agent」并行读轨迹写摘要,再由一个更强的协调 Agent 汇总成报告。
真正的问题常常不在模型
Together AI 的文章补上了「读完轨迹之后改什么」。他们每个任务按三种配置跑:什么都不给(基线)、接上文档 MCP、装上官方 Skill 包;三个模型、每个两次,再由大模型裁判判成通过、未完成、失败三档。
几个具体发现:
- 两句话的 Skill 修改。一个「列出 GPU 集群可用区和机型、找出最便宜的、给出预订命令但别真订」的任务,早期 Sonnet 4.6 装着 Skill 也只过了 15 次里的 4 次。原因是 CLI 文档里的示例输出没标明是示例,Agent 把它当成了实时库存;Skill 链接的是营销页,不是价格表。补两句话指向价格表和实时接口后,测试的模型全部通过。
- 报错信息指错路。一次运行里,API 的 400 报错让 Agent 去调一个根本不存在的路由。人照着这条报错做也会卡住。
- 14 个 Skill 合成 1 个,第一版更差。合并后的统一 Skill 72 次只过 54 次(75%),单次成本翻倍还多。轨迹显示入口路由文件约 14,000 字符、每次都全量加载。砍到 6,000 字符以内、修掉示例代码里的小 bug、换掉已下线的模型后,72 次过了 70 次(97.2%),成本回到原来水平。
他们还提到一点:强模型会绕过你的缺陷。同一个 GPU 任务 Opus 4.8 14 次过了 13 次,它发现接口没返回价格就自己去文档里找。只拿最强的模型测,这类坑很久都发现不了。
常见坑
- Agent 根本不知道你的工具。Vercel 第一次跑,所有配置都是 0%,因为指令里没点名 CLI。评测里点名是为了专注测「完成任务」;放到现实里,这说明发现环节要靠 Skill、文档和 MCP。
- 「通过」可能是放弃。那个本该告诉用户做不到的任务,Codex 几乎每次都过,读轨迹才发现 10 次里有 9 次是没搜就直接放弃。检查脚本后来加了一条:确认 Agent 先搜过。
- Agent 会钻空子。预置数据和检查脚本要放在 Agent 改不到的地方,订单只能通过产品自己的命令写入,否则它可能直接改库存或手写订单文件。
- 评测会饱和。模型和产品都在变好,全部通过以后它只能防回归,要不断加更难的任务。
完成标准
- 有一个写清楚范围的目标,和按失败代价选好的主指标。
- 3–5 个任务,含一个「不该动手」的任务,每个都有已知正确解且能拿满分。
- 跑完一轮基线,按任务看结果,读过失败和部分通过的轨迹,归出一两条根因。
- 改一处(文档、Skill、报错或加个参数),重跑同一批任务,和基线对比。
想先补团队内部的评测流程,可以看站内评测驱动开发三步教程;Skill 写得太胖的问题,见给 Agent Skill 瘦身。
最后
如果你的产品有 CLI 或 API,挑客户投诉最多的那一件事,写一个任务、一个按约束打分的检查脚本,让 Claude Code 和 Codex 各跑 5 次,先看一眼 pass^5 是多少。