Agent 复盘 Skill 有用吗:12 项改动只有 2 项见效
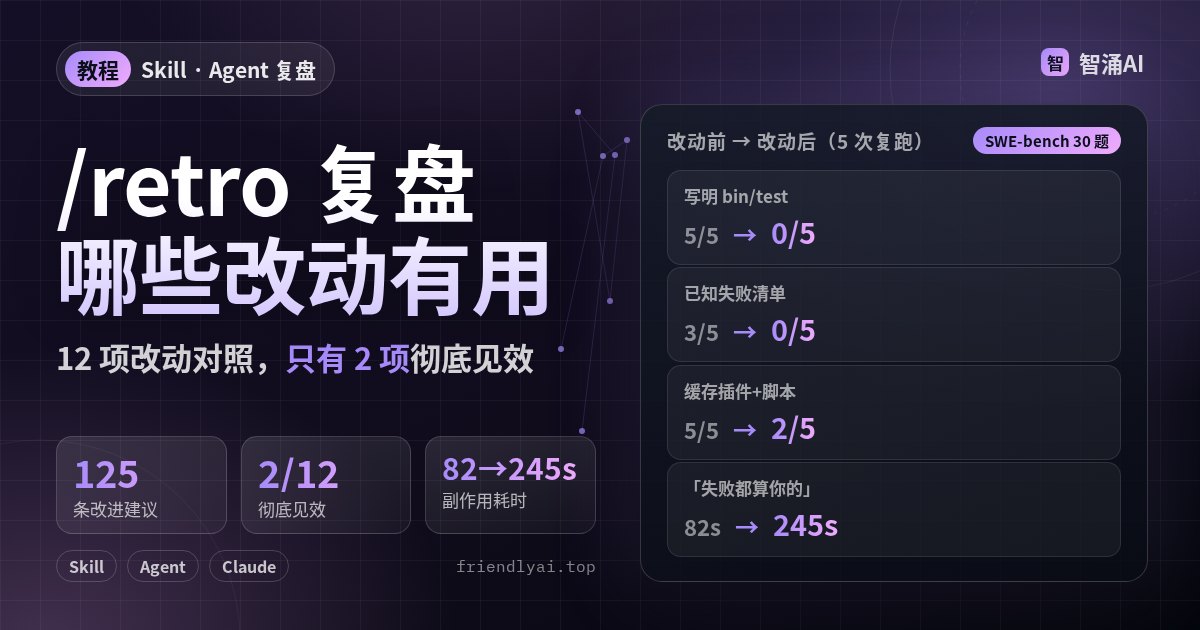
让 Agent 做完任务后复盘一遍,把踩过的坑写进 CLAUDE.md、加个检查脚本,下次就不再犯,这是很多人给编程 Agent「调教环境」的做法。2026-10-26 挂上 arXiv 的一篇实证论文,专门测了这件事:用开源的 /retro 复盘 Skill 跑 30 个真实修 bug 任务,得到 125 条改进建议,挑 12 条做了前后对照,结果只有 2 条把目标问题彻底消掉。下面按论文和 Skill 官方仓库(2026-11-04 北京时间查阅),讲清 /retro 怎么用,以及哪类改动值得留。
/retro 是什么:只提建议,不自己动手
/retro 是 mattpocock/skills 仓库(MIT 协议)里的一个工程类 Skill。它在一次会话结束后读整段对话,找出 Agent 绕远路、反复试错、违反规范的地方,再按类别提改进建议:导航指针、自动检查、编码规范、全局 AGENTS.md、工具用法、无需改动、信息获取。
SKILL.md 开头写着 disable-model-invocation: true,意思是模型不会自己触发它,只能人手动敲 /retro。它也只出建议清单,改哪条由人挑。仓库文档给的分工很明确:CLAUDE.md / AGENTS.md 只放「去哪找」的导航指针,规范交给评审环节的 CODING_STANDARDS.md,能机械判断的违规改成确定性检查(lint、测试、pre-commit)。
安装两种方式任选(来自仓库 README):
# Claude Code 插件市场
claude plugin install mattpocock-skills@claude-plugins-official

# 或用 skills CLI 装到 Cursor、OpenCode 等其他 Agent
npx skills@latest add mattpocock/skills -a cursor
装好后,在一次干完活的会话里输入 /retro,它会列出建议和对应类别。仓库文档自己也写了:这个 Skill 不负责回头审计、清理以前加的检查。
论文怎么测的
论文题为 How Do Coding-Agent Harnesses Self-Evolve?,作者是新加坡管理大学的 Christoph Treude 和海德堡大学的 Sebastian Baltes。实验环境是 Claude Code 2.1.295 加 Opus 5.5,/retro 固定在 commit b0618bc,任务取自 SWE-bench Verified 的 30 个 issue。
流程分三段:先让 Agent 修 bug,再跑 /retro 收建议,最后把其中 24 条落地,挑 12 条在同一类任务上各跑 5 次,对比改动前后目标行为出现的次数。建议总数 125 条,其中 101 条有会话里的具体经历支撑,19 条是凭通用经验提的,5 条依据很弱。凭经验提的那 19 条里,有 18 条属于 lint 类,lint 类建议一共 43 条。
| 建议机制 | 条数 |
|---|---|
| 可执行检查(lint、测试、脚本) | 38 |
| 导航指针(告诉 Agent 去哪找) | 24 |
| 文字指令 | 21 |
| 信息获取 | 20 |
| 工具或配置 | 12 |
| 无需改动 | 10 |
12 条改动,2 条见效
彻底消掉目标行为的两条都很朴素。一条是在 SymPy 仓库的 CLAUDE.md 里写明「测试用 bin/test,环境里没装 pytest」,Agent 先去试 pytest 的情况从 5/5 降到 0/5。另一条是给 Astropy 加了一个「已知失败测试」文件,列出 3 个本来就挂的测试,Agent 为它们白查原因的情况从 3/5 降到 0/5。
另有一条只减轻了问题:Astropy 的缓存插件加脚本,让目标行为从 5/5 降到 2/5。剩下 4 条看不出减少。作者自己写的 pre-commit 配置,5 次会话里 Agent 一次都没读过。
改动有没有用,先看 Agent 到底读没读到它。
副作用也要算进去。论文在 Sphinx 上放了一个对照任务,加了一条「没列进已知清单的失败,都当成你自己弄坏的」。结果 Agent 在 5 次里有 4 次额外跑了基线对比(原来是 0 次),中位耗时从 82 秒涨到 245 秒。SymPy 那份 CLAUDE.md 里顺手捎上的一行 lint 要求,也把中位耗时从 88 秒拉到 156 秒。各组的任务成功数最多只差 1 个,复盘改动基本没换来更高的通过率。
哪些改动该留,哪些该删
| 改动类型 | 论文里的表现 | 建议 |
|---|---|---|
| 仓库级事实:测试命令、缺什么工具 | 5/5 → 0/5 | 优先写,长期留 |
| 环境相关清单:已知失败测试 | 3/5 → 0/5,但会过期 | 写上日期,环境变了就删 |
| 泛化规则:「所有失败都当成自己的」 | 耗时 82 秒 → 245 秒 | 别加,或限定到具体场景 |
| 捎带的 lint 要求 | 耗时 88 秒 → 156 秒 | 改成 lint 命令,别写成文字 |
| 没人读的配置 | 5 次会话 0 次读取 | 在 CLAUDE.md 里放指针,或直接删 |
这和 /retro 文档的分工一致:CLAUDE.md 越短越好,只放 Agent 每次都会用到的事实和指针。站内那篇 Agent 自我改进 讲的是另一条路,可以对照着看。
按论文结论用 /retro 的四步
- 只在真踩过坑的会话后跑。没遇到问题就跑,拿到的多是「建议加 lint」这类凭经验的建议,论文里这类占了凭经验建议的大多数。
- 每条建议先问「有会话证据吗」。能指出对话里哪一步绕了路的留下,说不出来的跳过。
- 落地后看三件事。同类任务再跑几次:问题还出现吗?Agent 读到改动了吗(看它有没有打开那个文件)?行为和耗时变了吗?
- 定期删。给环境类条目写上添加日期,依赖升级或环境修好后回头清理。
/retro不会替你做这一步。
常见坑
- 把一次复盘当成定论。论文每组只跑 5 次,issue 是特意挑能复现问题的,也只测了一个 Agent,作者自己也把这些列为局限。你的仓库要用自己的任务复核。
- 只加不删。每条看着都合理,叠起来就是一份越来越长、互相打架的 CLAUDE.md,耗时变长,通过率却没涨。
- 文字规则代替检查。能用命令判断对错的,写成 lint 或测试,别指望 Agent 读一段话就照做。
完成标准
- CLAUDE.md 里每条都能说出是哪次会话、哪个问题催生的。
- 新增的改动在同类任务上复跑过,问题出现次数确实下降,耗时没明显上涨。
- 环境类条目带日期,有人定期清。
最后
下次觉得 Agent 又在同一个地方绕路,先跑一次 /retro,只挑一条有证据的「仓库级事实」写进 CLAUDE.md,再用同类任务复跑看效果。想先理清 CLAUDE.md 该写什么,看本站的 grill-me 需求盘问 Skill 和 CLAUDE.md 教程。