Agent 记忆 Dreaming 是什么:离线整理、纠错与下次会话怎么用
Agent 跨会话记得住东西,不等于记得对。Anthropic 工程团队 2026-11-06 发的 The components of agent memory,把「记下来」和「离线整理」拆开讲:会话里写笔记,空闲时再对照 transcript 纠错、建索引、把该常驻的内容顶到下一轮上下文——这套离线整理就叫 dreaming。Claude Managed Agents 的 Dreams API(研究预览)把同一思路做成异步任务。本文按研究文与官方文档做综述;站内未调 Dreams 端点,标未实测。
会话里写笔记,空闲时再整理
研究文借用海马体「在线编码、离线巩固」的类比:Agent 把工作写进日志或 transcript;空闲时再回放,把经验蒸馏成可复用的笔记与结构。Letta 与 UC Berkeley 提过的 sleep-time compute,同一思路用在记忆整理上。
文中「agent memory」特指:从用户交互与任务中获得、跨会话保留、之后可读回的知识。明确排除:训练权重变化、单次对话内的 in-context learning,以及 compaction(用摘要顶掉旧轮次、腾上下文)。
笔记可以是文件夹里的 memory notes。难点是:当下很难知道「以后还会不会用到」。记忆经常是一种预测——写下一条规则,等于押注未来会话还需要它。
Dreaming 让 Claude 有机会往后看:用算力整理记忆、纠正错误,并维护以后更容易取用的表示。
显著性判断:少记比乱记更值钱
Continual Learning Bench(CL-Bench)1.0 里有一类任务:每题新开会话,只能靠持久 memory 目录跨题学习;答完后告知正确答案,再写记忆帮后面的题。不同模型写记忆的成熟度差很多:弱一些的只堆未验证猜测;更强的会合并成参考文档、标已核验/未确认,并写出「规则 + 依据 + 陷阱警告」。有记忆时,较新的 Opus/Sonnet 5.x 系模型能接近把学习闭环跑通;具体分数以研究文图表为准,本文不另造数。
玩《口袋妖怪红》的对照更直观(各约 1 万步时的一次运行):
| 模型 | 记忆规模(约) | 进度 | 记什么 |
|---|---|---|---|
| Claude Sonnet 3.7 | 413 个文件 / 225 个文件夹 | 1 枚徽章 | 几乎什么都存,战报/道具/NPC 分文件;游戏态一直变,档案很快过时 |
| Claude Fable 5 | 9 个文件 / 2 个文件夹 + 顶层 global.md | 4 枚徽章 | 目标、路线计划、试出来的规则;屏幕上每回合能读到的状态不存 |
Sonnet 3.7 曾连续十几步只在整理「master」记忆、零游戏操作。Fable 5(以及文中提到的 Opus 5.5)把记忆留给「游戏不直接告诉你」的东西——例如连续 7 个精灵球没抓到 Magikarp 后,写下「连失败 3+ 次就改按键时机」这类规则。更强模型上,研究文倾向:只告诉它有 memory 可用、何时值得记,把显著性判断留给模型;过死的「只记失败」等规则,反而会削弱记忆带来的增益。
Dreaming 能纠错、建表示、抬层级
会话里写错的笔记,下一轮可能被当真。Dreaming 用原始 transcript 当 ground truth 校对。研究文举了 Mt. Moon:Claude 误记 Pokémon Center 在东侧,以为「山已过」结果掉下单向崖;dreaming 对照 transcript 改笔记后,同一设置下能回到洞口并到达下一城,未纠正与无记忆的运行则卡在山前循环。
Dreaming 也能建wiki:主题页 + 互链,当记忆地图。Stainless 内部语料约 35 万文件、约 4.2 亿 token;25 道问答评测里,dreaming 从 2 轮扩到 128 轮会话时,按评分标准从约 13% 升到约 48%。wiki 配搜索时,聚合分从约 54% 升到约 61%(仅搜索约 53%;仅 wiki 最好约 48%),且每题大约少花 2 万 token。Harvey LAB 并购材料题上,需跨多文档综合的条目:查 wiki 约 87%,仅搜索约 73%。也有任务几乎单文档可搜到,wiki 无明显增益;还有 wiki 长过原文、抽象掉了重点的反例。
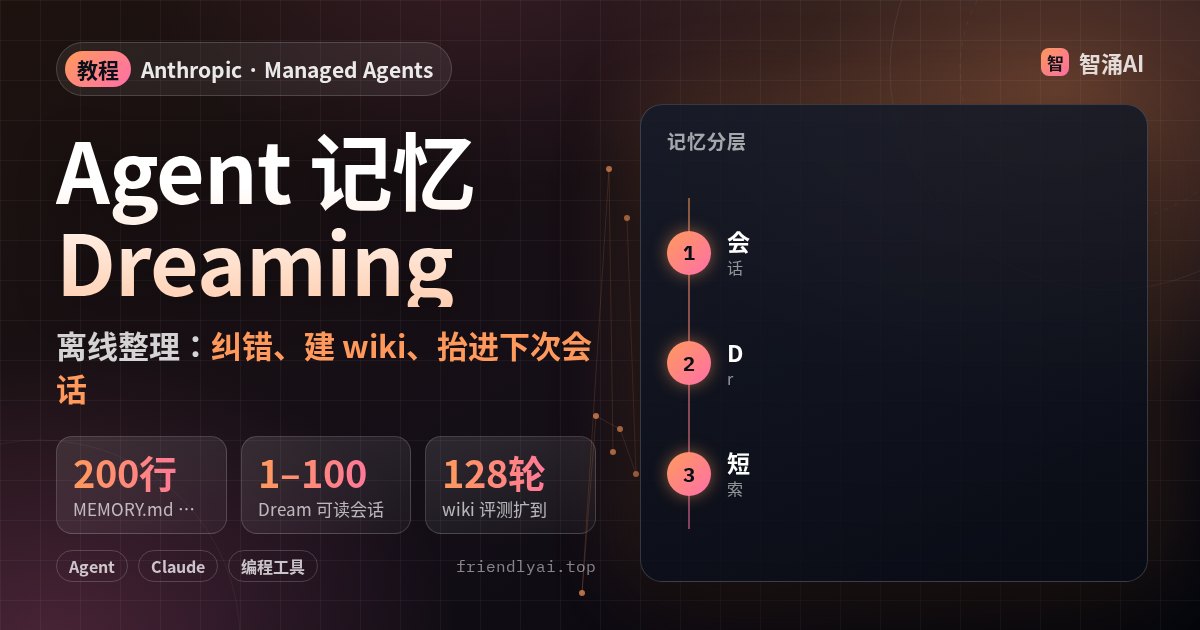
第三件事是把少数笔记抬到记忆层级顶部,由 harness 在每会话开头注入。注入占 token,错了还会污染每一轮;Claude Code 文档也提醒,指令文件越长,遵守度越差。所以顶层要短。Claude Code 自动记忆做法:不把全部 auto memory 塞进上下文,只加载 MEMORY.md 的前 200 行或 25 KB,当作「知道什么、去哪找」的索引头。
Dreaming 还可按目标塑形(例如个人助手围绕用户组织记忆),以及第二遍 dreaming 补断链、补索引页。研究文也点了开放问题:在线写记忆会分心主任务,纯离线则当下用不上;全量持续校对不现实,需要按变更频率与访问热度调 cadence。
Dreams API:异步产出新 memory store
官方文档把 Dreams 标为研究预览(需申请访问)。动机:会话内写入是局部、增量的,久了会重复、矛盾、过期。一次 dream 读取「已有 memory store + 过去 session transcript」,产出另一个整理后的 store:合并重复、用最新值替换过期/矛盾项、抽出新洞见。输入 store 永不被修改,不满意可以直接丢掉输出。
创建时至少提供:一个 memory_store 输入,以及 1–100 个 session;指定跑管线的模型(仅部分模型支持);可选 instructions 做高层合成指引(聚焦领域、保留约定等)。文档强调:这是合成遍,不是按句改写器——「把第 X 句改成 Y」这类指令通常无效;定点改要用 Memory Stores API 直接改输出 store。没有现成 store 时,先建空 store 再传入。
# 概念示例(需 Managed Agents + dreaming beta;未在本站实测)
# POST /v1/dreams
# headers: anthropic-beta: managed-agents-2026-04-01,dreaming-2026-04-21
{
  "inputs": [
    {"type": "memory_store", "memory_store_id": "memstore_…"},
    {"type": "sessions", "session_ids": ["sesn_…", "sesn_…"]}
  ],
  "model": "claude-opus-5-5",
  "instructions": "Focus on coding-style preferences; ignore one-off debugging notes."
}生命周期:pending → running(通常数分钟到数小时,随 transcript 量变)→ completed / failed / canceled。跑起来后 session_id 指向管线会话,可流式观察读写;结束后该会话归档保留 transcript。完成后把输出 store 挂到后续 session 的 resources,或删除/归档丢掉。failed/canceled 时输出 store 仍可能有部分内容,便于排查。
计费按所选模型标准 token 价,usage 字段给精确用量;成本大致随输入 session 数量与长度线性涨。文档建议先小批量 session,满意再放大。错误类型包括超时、输入 store 过大、跑中途输入 store/session 被归档删除等。可用性表(文档):Claude API 上 Managed Agents,研究预览模型含 Fable 5.1/5、Opus 5.5/5、Sonnet 5.5/5、Opus 4.8/4.7、Sonnet 4.6 等;dream 端点需要 dreaming-2026-04-21 beta 头(仅有 managed-agents-2026-04-01 不够)。数据方面文档写明:不适用零保留与 HIPAA 资格(会话类有状态资源)。更细的自建管线见 Cookbook「Dreaming with a dynamic workflow」。
| 你想做的事 | 优先手段 |
|---|---|
| 会话内立刻记下规则/陷阱 | memory notes / Memory Stores API |
| 跨多会话去重、纠错、建 wiki | Dreams(离线) |
| 每会话自动带上短索引 | 顶层注入(如 MEMORY.md 头 200 行/25KB) |
| 项目约定、命令、结构 | 仍用 CLAUDE.md,与跨会话「经验记忆」分工 |
常见坑
- 把 transcript 搜索当成整理完了。搜索是底盘;wiki 等表示要维护,不然会积累错误或幻觉式链接。
- 顶层注入塞太满。错笔记进每个会话比「偶尔搜不到」更伤;Claude Code 明确截断 MEMORY.md 头,不是疏忽。
- 对 Dreams 下逐句改写指令。文档说管线是合成,不是编辑器;定点改走 Memory Stores API。
- dream 跑着时删输入 store/session。会导致
input_memory_store_unavailable/input_session_unavailable。 - 研究数字当产品 SLA。Pokémon、Stainless、LAB 都是评测场景;你的业务语料要自己设验收。
完成标准
- 能用一句话说清:在线笔记 vs dreaming 离线整理 vs 顶层注入,各自解决什么。
- 能指出 Claude Code
MEMORY.md注入上限(200 行或 25 KB)。 - 能列出 Dreams 的最小输入(store + sessions)、输出是新 store、输入不被改。
- 若申请到预览:用一小批 session 跑通 create → poll → 审阅输出 → 挂到新 session 或丢弃(本站未实测该路径)。
最后
先把「跨会话该留下什么」写清楚,再决定要不要上 Dreams 做离线整理;顶层只留短索引。动手前打开下方 Anthropic 研究文与 Dreams 文档核对模型名单与 beta 头。