公司级 Agent 怎么搭:LangChain 内部 Agent 的 5 个底座
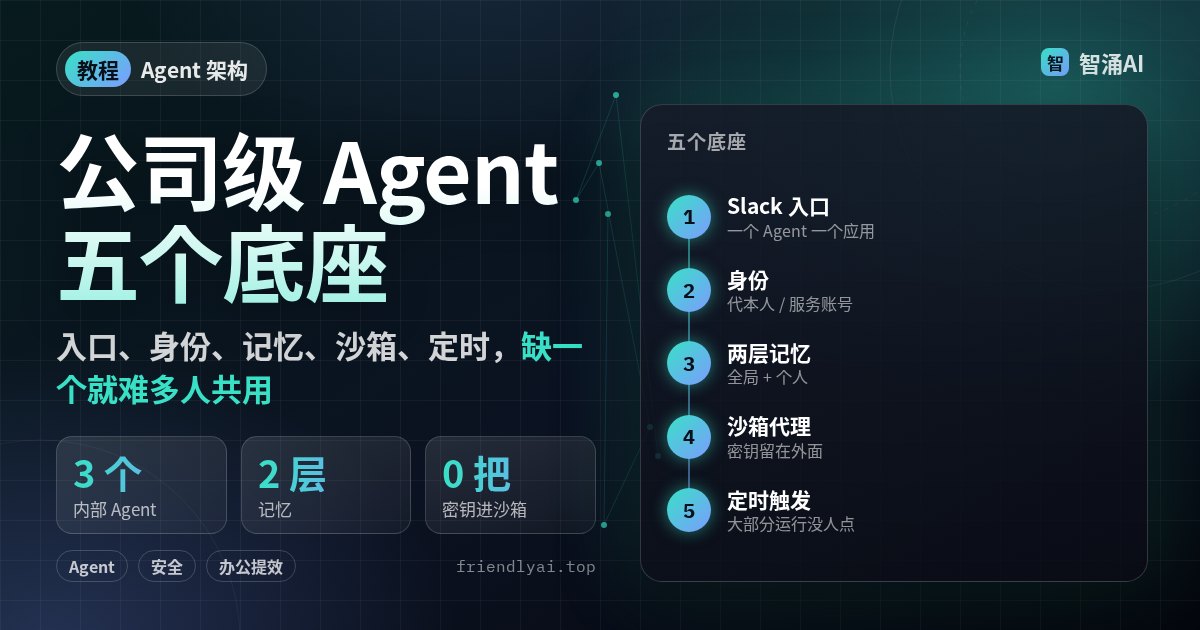
一个人用的 Agent 和一个团队共用的 Agent,难点完全不同。LangChain 在 2026 年 10 月 24 日的官方博客里,把自家营销、销售、工程三套内部 Agent 的做法摊开讲:三个团队各自踩坑,最后收敛到同一组五个底座。这篇按那篇文章和 LangSmith 官方文档整理成一份搭建清单,方便你给自己团队做「公司级 harness」时对照。我们没有部署 Managed Deep Agents,涉及产品行为的部分标「未实测」。
说明:三套 Agent 的分工、身份策略、两层记忆、定时运行的比例描述,全部来自 LangChain 官方博客原文;沙箱代理和身份配置的写法来自 LangSmith 文档。Managed Deep Agents 目前在 LangSmith Cloud 上是公开测试版,下面的代码片段我们没有实际部署,标「未实测」。
先看他们拿什么练手
文章用三套在跑的内部 Agent 当例子:
- GTM Agent:一直在线的增长助手,盯邮件和新的合格线索、发每日简报、回答客户账户问题、执行外联。
- OpenSWE:工程 Agent,能改代码、起草 PR,也对所有 PR 跑代码审查。
- Content Studio:营销 Agent,按公司口吻和定位起草博客、图片、PPT、视频。
三者都建在 Managed Deep Agents 上,它叠在开源的 Deep Agents harness 之上,负责频道、定时任务、沙箱、记忆、身份这些基础设施。你用不用 LangChain 都行,这五个问题换什么框架都得回答。
底座一:住在大家已经在用的地方
他们的 Agent 都住在 Slack,每个 Agent 一个 Slack 应用,可以私聊,也可以在频道里 @。放在频道里有个副作用:别人能看到同事怎么用它,用法会自己传开。
有两个细节可以直接抄。一是「分出去」:人在讨论时想拉 Agent 进来,又不想让它的长输出淹掉人的对话,就让 Agent 在频道里另开一个线程干活。二是不硬塞:GTM Agent 起草的待发邮件一多,在 Slack 里一条条审很痛苦,他们最后还是做了一个专门的审阅界面。
底座二:身份,作者说这是最难的一块
Agent 动手时到底代表谁?业内两种做法:代调用者本人操作(on-behalf-of,OBO),或者不管谁叫都用一套固定凭证(服务账号)。LangChain 的做法是按工具分,同一个 Agent 里两种混用:
| Agent | 代本人(OBO) | 固定身份 |
|---|---|---|
| OpenSWE | 你私聊它时,用你的 GitHub 账号开 PR | 后台跑代码审查时,用自己的 GitHub App |
| GTM Agent | 邮件类工具,只在私聊里可用,公共频道不开放 | Salesforce 等,大家不必各自登录 |
| Content Studio | Notion 等 | 公司社交账号;只有白名单用户能执行发布,其他人只能读或起草 |
落到自己团队,可以按一个问题给每个工具归类:这个动作出了事,该记在谁头上?要记在个人头上的(发邮件、用个人账号提交),走 OBO,并且只在私聊里开;记在团队头上、又不想每人登录一遍的(查 CRM),走服务账号;会对外发声的,再叠一层白名单。
LangSmith 文档里还有一条容易忽略的提醒:默认用 LangSmith API key 鉴权时,拿到 key 的人都能用同一个部署,可能看到同样的会话;要让每个终端用户有私有会话,得换成 Supabase、其他 JWT 提供方或自家后端来认人。另外,有 LangSmith 工作区访问权限的人能读和搜索部署里的全部会话,私有只是对终端用户而言(未实测)。
给每个工具归类时只问一句:出了事算谁的。算个人的走代本人授权,并且只在私聊里开放。
底座三:两层记忆
三个 Agent 都有两层记忆:全局记忆对所有人生效,用户记忆只对某个人生效,由 Agent 自己判断一条事实该记到哪一层。作者坦白这是目前探索最少的一块。实操上建议先定规矩:涉及个人偏好、私聊内容的只进用户层;团队口径、产品定位才进全局层,而且全局层最好有人能查看和删改。
底座四:代码在沙箱里跑,密钥留在沙箱外
三个 Agent 都要写代码、跑代码。模式是一样的:Agent 本身跑在沙箱外,连进沙箱执行;不同 Agent 用不同的基础镜像,OpenSWE 还会按频道和用户挑镜像。
关键在鉴权。LangSmith 沙箱的 Auth Proxy 挡在出站网络路径上:沙箱里的代码照常请求 API,代理按规则匹配目标域名,替它加上鉴权头,密钥本身从不进入沙箱。官方文档的示例(未实测):
from managed_deepagents import define_sandbox

sandbox = define_sandbox(
    proxy_config={
        "rules": [
            {
                "name": "openai-api",
                "match_hosts": ["api.openai.com"],
                "headers": [
                    {
                        "name": "Authorization",
                        "type": "workspace_secret",
                        "value": "Bearer {OPENAI_API_KEY}",
                    },
                ],
            },
        ],
    },
)
按 LangChain 介绍 Auth Proxy 的博客,这样做有三个好处:提示词注入、恶意依赖、日志误打印都拿不到密钥;Agent 能连哪些域名写进基础设施策略,不靠模型自觉;短期 OAuth 令牌可以走回调动态签发,回调失败时代理直接拒绝请求(fail closed)。不用 LangSmith 也能照这个思路做:出站走自家代理,白名单域名,密钥只在代理上。
底座五:大部分运行没人点
文章说很大比例的运行是定时或事件触发的,不是有人手动叫它。来源分两种:开发者预设的,比如 OpenSWE 监听新 PR,一开就审;用户自己让 Agent 建的,比如作者让 GTM Agent 每天发简报,它就给自己建了一个定时任务。
后一种很方便,也最容易失控。建议给 Agent 自建的定时任务加三条约束:能列出来、能一键停、每次运行留日志。
常见坑
- 公共频道里开放个人授权的工具。GTM Agent 的邮件工具只在私聊可用,就是为了防这个:在频道里谁都能 @ 它,不能让任何人借你的邮箱发信。
- 以为 API key 鉴权就有隔离。同一把 key 的调用方会共享会话;要按人隔离,得接用户身份。
- 把密钥写进沙箱环境变量。Agent 会装包、会读文件、会打日志,每一步都可能把密钥带出去。
- 定时任务没人管。用户随口一句「每天提醒我」就多一个 cron,半年后没人知道哪些还在跑。
完成标准
- 你的团队 Agent 有一个明确入口(Slack、飞书或企业微信),长输出不会刷屏。
- 每个工具都标了 OBO 还是服务账号,个人授权的工具只在私聊开放。
- 记忆分了全局和个人两层,并且有人能查看、删除全局层。
- 代码执行在沙箱里,沙箱内没有长期密钥,出站有域名白名单。
- 所有定时和事件触发的任务能列出、能停、有日志。
最后
如果你还在单人阶段,先把权限和护栏配好再谈多人共用。可以对照站内 Claude Code 权限配置详解,把 allow/deny 和沙箱边界先在自己机器上理顺。