Vital Skills 上手:本机克隆 13 条 HLS Agent Skills
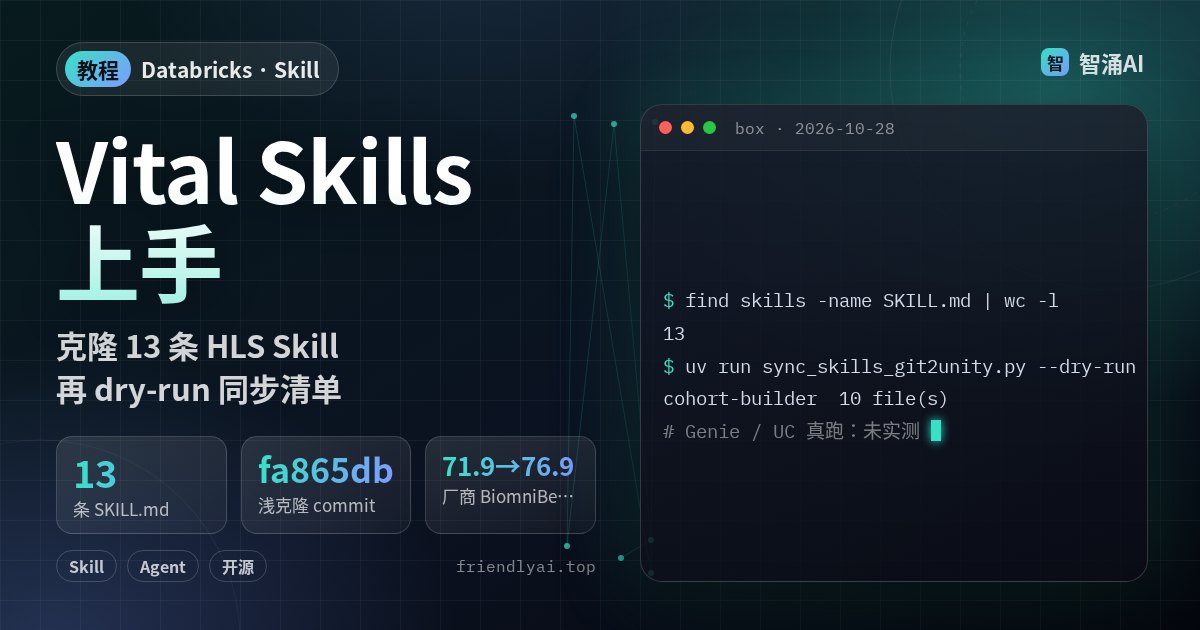
2026 年 10 月 27 日,Databricks 发布 Vital Skills:一套面向医疗与生命科学(HLS)的开源 Agent Skills,给绑定 Unity Catalog 的 Genie Code 用得最多。站内快讯《Databricks 开源 Vital Skills》写过分数;这篇在本机浅克隆仓库 databricks-industry-solutions/vital-skills(commit fa865db),核对 13 条 SKILL.md 的 frontmatter,并跑了 sync_skills_git2unity.py --dry-run。Genie Code 内联调试、Unity Catalog 真同步、BiomniBench 复跑,本文标「未实测」。
若已经读过 写第一条 Agent Skill 和 Skill 与 MCP 怎么分工,可以直接跟步骤。没有 Databricks 工作区也能先把仓库结构摸清,把「先问阈值再跑验证过的脚本」抄进自己的 Skill。
前置条件
- 能访问 GitHub;本机有
git、python3;可选 uv(跑 sync 脚本会自动装databricks-sdk)。 - 测试日期北京时间 2026-10-28。仓库浅克隆 commit fa865db(PR #40:report-builder)。
- 完成「克隆 + 校验 frontmatter + dry-run」不需要 Databricks 账号。Genie Code 会话、Unity Gateway 发布、HLS 数据上的端到端跑通未实测。
它解决什么:通用 Agent 会默默选阈值
Databricks 博文写得很直:通用编码 Agent 能解析文档、画图,但 HLS 场景里常默默选定临床阈值,或拿通用统计顶替领域常规做法。Vital Skills 把「该问什么、哪几步不能省、优先跑哪些已验证工具」收成可加载的 playbook,少靠再塞一长段系统提示。
官方在 BiomniBench 上对比 Genie Code 有无技能:技能覆盖范围内的 5 项任务,均分从 71.9 提到 76.9(0–100,每任务 3 次);范围外 18 项大致持平(69.1→71.2)。这些分数出自厂商博文,本站未复跑。
阈值该用户拍板时先问;敏感步骤跑仓库里验证过的入口,别让 Agent 每轮重写 SQL。
第 1 步:浅克隆并数清 13 条 Skill
git clone --depth 1 \
  https://github.com/databricks-industry-solutions/vital-skills.git
cd vital-skills
git rev-parse --short HEAD   # 本文:fa865db
find skills -name SKILL.md | wc -l   # 13
ls skills/
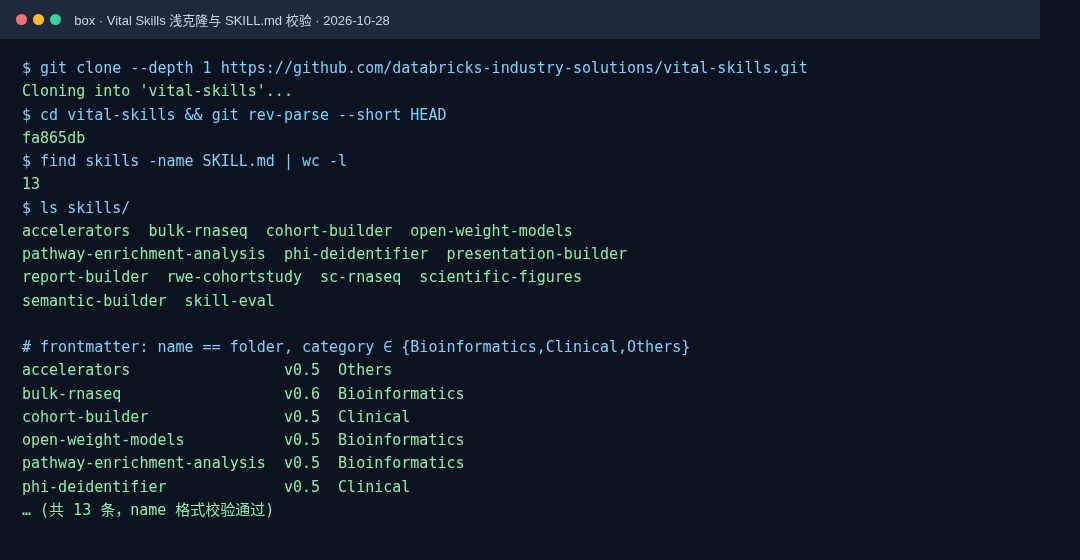
目录按 Agent Skills 习惯摆:skills/<name>/SKILL.md 必有;旁边可有 scripts/(可执行入口)、references/(按需加载的长文档)。仓库顶层还有 AGENTS.md(写作规范)、templates/、sync_skills_git2unity.py。
| Skill | 分类 | 它干什么(README 摘要) |
|---|---|---|
| bulk-rnaseq | Bioinformatics | 从 bulk RNA-seq counts 找差异表达基因 |
| sc-rnaseq | Bioinformatics | 分析 .h5ad 单细胞 RNA-seq |
| pathway-enrichment-analysis | Bioinformatics | 通路富集(ORA / GSEA) |
| open-weight-models | Bioinformatics | 在 Databricks 上架/校验开源 HLS 模型(如 TEDDY、Geneformer) |
| cohort-builder | Clinical | 从编码 + 自由文本建可复现、先看可行性 N 的队列 |
| rwe-cohortstudy | Clinical | 比较效果研究(倾向性匹配 / IPW) |
| semantic-builder | Clinical | 把常见 EHR/理赔指标落到 Metric View |
| phi-deidentifier | Clinical | HIPAA Safe Harbor 去标识(含 k-匿名与受管视图) |
| presentation-builder / report-builder / scientific-figures | Others | 幻灯片、LaTeX 报告、科研作图 |
| accelerators / skill-eval | Others | 路由到 HLS 加速器;成对评测有无技能 |
本机解析 frontmatter:13 条的 name 都等于文件夹名,且匹配 [a-z0-9-]+、长度 ≤64;version 多为 0.5(bulk-rnaseq 为 0.6,presentation-builder 为 0.1)。
第 2 步:拆开一条 Clinical Skill 看执行模型
以 cohort-builder(version 0.5)为例。YAML 里的 description 写得很满:自然语言描述人群 → 在真实编码表里 grounding(不幻觉 ICD/LOINC)→ 阈值与「编码/笔记怎么合并」先展示选项 → 先报可行性 N → 再物化队列;强调调用 scripts/cohort_run.py 的入口,而不是手写队列 SQL。
# skills/cohort-builder/ 里本机看到的关键文件
SKILL.md
scripts/cohort_run.py
scripts/criteria.py
scripts/interactions.py
scripts/literature.py
references/clinical_thresholds.md
references/freetext_notes.md
…
SKILL.md 正文还写明:需要 Python 计算环境(serverless 或集群),不能只靠 SQL warehouse;鉴权在工作区内是 ambient,本地可用 Databricks CLI profile。笔记路径才会要 ai_query 端点。这条「执行模型」——Agent 读 playbook、跑仓库脚本、关键抉择留给人——是整仓多数 Clinical / Bioinformatics 技能的共性,别的 harness 也能照着抄。
第 3 步:无凭证跑 sync dry-run
# 在仓库根目录;无需 DATABRICKS_*
uv run sync_skills_git2unity.py --dry-run
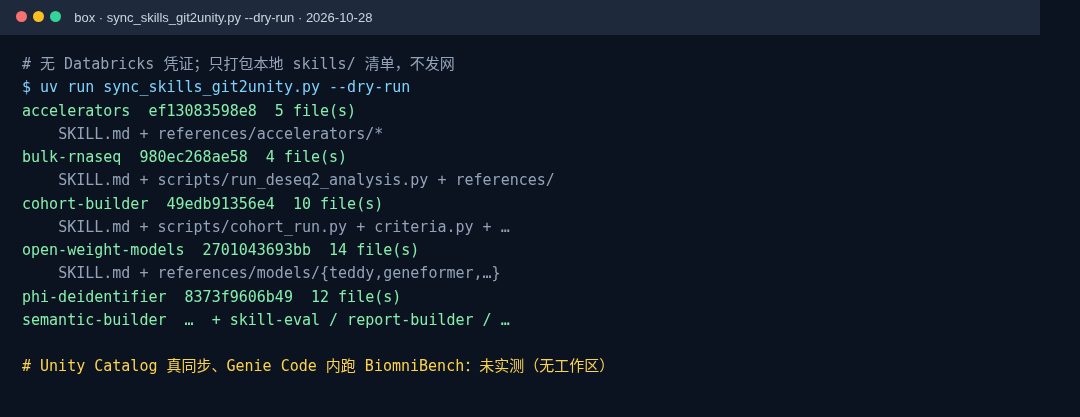
脚本用 inline metadata 拉 databricks-sdk,dry-run 只读本地 git 可知文件(忽略未跟踪缓存),打印每条技能的内容哈希与文件列表。真发布要:
uv run sync_skills_git2unity.py \
  --catalog <catalog> --schema <schema> \
  --warehouse-id <sql_warehouse_id>
官方 README:在 Databricks 终端跑;需要 UC Skills 能力、对 catalog/schema 的相应权限,以及 SQL warehouse 的 CAN USE。脏工作树默认拒绝,除非 --allow-dirty。本站未实测真同步。
第 4 步:挂到 Genie Code(文档步骤,未实测)
- 把仓库加成 Databricks Git folder,或克隆到工作区。
- 打开 Genie Code → Settings / Customizations,把包含各技能子目录的父文件夹(即仓库里的
skills/)登记为额外 skills 路径。官方文档强调:登记的是父文件夹,不要直接登记带单个SKILL.md的叶子目录。 - 新开对话;需要时可用
@点名技能。改完技能后要新开聊天才会吃到更新。
也可用 Free Edition 试用(安装页说明)。团队共享可再走 Unity Gateway sync。上述步骤按 Extend Genie Code with agent skills 与安装页整理,本机无工作区,标未实测。
可抄的三条设计原则
博文把技能作者的纪律收成三条,本机读 cohort-builder / open-weight-models 的 SKILL.md 也能对上号:
- Ask before assuming:临床阈值、编码与笔记怎么合并、模型是实时端点还是批任务——先展示选项,再往下走。
- Trust-tested tools:敏感路径优先调用
scripts/里的入口(如cohort_run.py、run_deid.py),而不是每轮现场拼 SQL。 - Prove it:仓内有
skill-eval,用成对「有技能 / 无技能」跑分;官方 BiomniBench 数字是厂商证据,你自己的数据仍要重测。
开源权重模型那条技能还要求:钉住依赖与制品、注册进 Unity Catalog、用真实科学输入做冒烟测试后再交接。博文举例 TEDDY 部署任务:无技能完成 19/27 项检查,有技能 27/27——同样是厂商自测,适合当验收清单模板,别直接当你工作区的成绩。
非 Databricks 的 Coding Agent(Claude Code、Codex、OpenCode 等)只要支持 Agent Skills 目录,也可以把 skills/ 拷进去当领域手册;但脚本里的 Databricks SDK 调用在你机器上会失败,需要改成自己的执行层,或只复用 Markdown 流程与阈值提问清单。许可仍受 Databricks License 约束。
常见坑
- 许可不是 MIT:根目录
LICENSE.md是 Databricks License——材料须在你对 Databricks 服务的协议范围内使用;商用/分发前先读 LICENSE 与 NOTICE,别默认当宽松开源搬进任意产品。 - 合规仍归你:README Disclaimer 写明 HIPAA/GDPR 等义务在用户侧;技能本身不构成合规认证。PHI 相关技能(如 phi-deidentifier)要先确认工作区加密、审计与 BAA。
- 只挂叶子目录会找不到技能:Genie 文档要求父文件夹下每个子文件夹一份
SKILL.md;指错路径时技能列表是空的。 - SQL-only warehouse 跑不动 Clinical 入口:cohort-builder 写明入口是 Python(SDK 再去打 SQL)。选 serverless/Python 集群。
- 把 BiomniBench 分数当自己环境的 SLA:71.9→76.9 是厂商在特定任务子集上的结果;换数据、换模型、换 harness 都要自己评(仓内有 skill-eval)。
完成标准
- 本机
find skills -name SKILL.md | wc -l= 13,且抽查 2–3 条 frontmatter 的 name 等于文件夹名。 uv run sync_skills_git2unity.py --dry-run能列出每条技能的文件清单(即使没有 Databricks 凭证)。- 能向同事讲清:技能按 Agent Skills 标准加载;Genie Code 挂的是
skills/父目录;真跑 HLS 流水线还要工作区算力与治理。
最后
建议先在本机把 13 条 Skill 的目录和 dry-run 跑通,再考虑开 Databricks 工作区做第一条 @cohort-builder 演示。自己写领域 Skill 时,优先留下「先问阈值 + 跑仓库脚本」,少堆提示词。