GPT-6.2 提示词怎么写:Codex 里先给验收标准
OpenAI 给 GPT-6.2 写了一份 Codex 专用的提示词指南,适用于 Astra 和 Sol 两个型号。核心就两件事:交代任务时顺手说清你验收时看什么,再按排查的深浅选推理档位。这篇把 Codex 指南、子 Agent 文档和 API 迁移说明里能直接抄的做法整理到一起,最后给一份精简版 AGENTS.md 的写法。
前置条件
- 能在 Codex(CLI、桌面端或 Codex Cloud)里选到 GPT-6.2 Astra 或 Sol。
- 项目里已有或准备写一个
AGENTS.md,个人级的放在~/.codex/AGENTS.md。 - 如果你是在 API 里调用,准备好改
reasoning.effort和请求结构,见第五步。
第一步:像跟懂项目的同事说话,再补一句你会查什么
官方建议的写法很朴素:把需求描述成你会对一个熟悉项目的同事说的话,然后告诉 Codex 你审查时会看什么。指南里举的例子是图标:如果它要在 24 像素的工具栏里还认得出来,就直接写出来。Codex 会参考已有图标的风格,自己判断这个尺寸下能保留多少细节。
放到写代码的场景,一个可以照抄的模板:
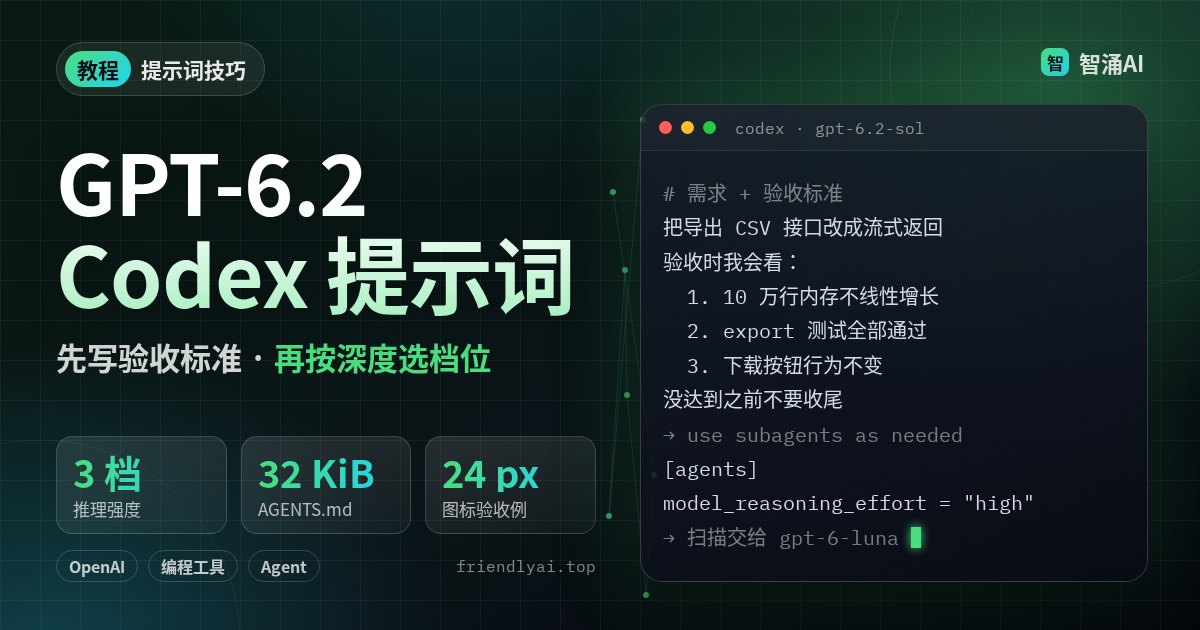
把导出 CSV 的接口改成流式返回。
验收时我会看:
1. 10 万行数据导出时内存不再随行数线性增长;
2. 现有 export 相关测试全部通过;
3. 前端下载按钮的行为不变。
没达到这三条之前不要收尾。
指南的说法是:告诉它什么算完成、哪里需要做到穷尽。团队要的是一个结论时,就得让它把一条有希望的线索追到能和其他解释对比的程度。
第二步:推理档位按排查深度选
档位越高,模型越能在长任务里坚持把最后的检查做完,哪怕最终答案只有几行。代价是更慢、更费 token,子 Agent 文档写得很直白。
| 任务形态 | 官方建议档位 |
|---|---|
| 快速摸底、看一圈现状 | Medium |
| 沿一个可疑原因跨好几个系统追查 | High |
| 几个原因可能相互影响,每个都要排查到 | Extra High |
| 开放式研究,能干净地拆成几个各需深挖的问题 | Ultra(Codex 自己决定何时开子 Agent) |
在 API 里新接入时,迁移说明建议从 medium 起步;原来用 none 或 minimal 的,改用 low。
档位决定它愿意查多深,验收标准决定它查到哪里停。两样只给一样,结果都会打折。
第三步:并行的活交给子 Agent
任务里有几块能各自推进时,在提示词里写一句 use subagents as needed,等于授权 Codex 自己判断什么时候拆、怎么拆。除 Ultra 以外的档位,想让它并行就得明说。
同类任务经常出现,就把这句话写进对应的 Skill 或 AGENTS.md,并注明适用条件,比如「请求里包含几个互相独立的问题时」。
子 Agent 的模型和档位默认继承主 Agent。想省钱或想更深,有三种改法:在提示词里点名模型或档位;在 config.toml 的 [agents] 里设默认值;或在自定义 Agent 文件里直接写 model 和 model_reasoning_effort。文档给的思路是:快速扫描交给 gpt-6-luna,难的子任务把 Sol 的档位调高;审查、安全类子 Agent 用 high。
第四步:视觉类任务给参考图,让它渲染后自己对照
心里有特定样子时,给一张参考图比写一段描述管用:形状怎么组合、哪个颜色突出、视线先落在哪,图里都有。可以从设计软件导出,也可以让 Codex 先用 GPT Image 生成一张。参考图定下来后,再让它做出成品、渲染出来、对照参考图改。
两条容易漏的要求:让它按用户实际看到的尺寸检查,大图里好看的细节缩小后可能就没了;成品能交互的话,让它亲手试一遍该支持的操作。
第五步:从旧模型迁过来,删掉一些老提示词
API 迁移说明里列了 GPT-6.2 Astra 的几处默认行为变化,对应要改的提示词:
- 默认更简洁直接。系统提示里原来那句「be concise」可以重新评估,可能已经多余。
- 意图不清时会停下来等确认。长任务里要给它空间做合理假设、继续干活。官方给了现成段落,大意是:可逆的假设直接做并说明,只有范围大变、真的卡住、需要用户拍板或不可逆操作前才停。
- 写代码更省。把项目约定写进去:优先复用已有逻辑、没要求就别加新测试、不要为少几行写成难读的单行、别加不必要的抽象层。
参数层面:工具调用要走 Responses API;Chat Completions 里去掉 temperature、top_p、logprobs、top_logprobs。顶层 instructions 现在会被追加到 input 之后,想让固定指令吃到提示缓存,就把它们挪成 input 第一条 developer 消息。中途改写对话前缀会让 Responses API 丢掉推理内容,所以换设置时尽量别动前面的消息。
第六步:AGENTS.md 只写 Codex 推断不出来的东西
指南的建议是精简:只放从代码、测试、文档里看不出来的项目要求和约定,项目依赖某个固定流程时把流程写上,怎么干活的日常决定留给 Codex。Codex 读 AGENTS.md 时,所有层级合并后默认上限是 32 KiB(project_doc_max_bytes),超了后面的就读不到。
多个 Agent 共用一台机器时,指南建议在 AGENTS.md 里加上资源礼让和收尾清理:
## 共享机器
- 同时跑构建或测试前,先想清楚需要几个并行进程,给其他任务留 CPU 和内存。
- 确实需要整机资源的重任务可以占满。
- 收尾时停掉自己启动的后台进程,删掉不再需要的临时文件。
你一边用电脑一边让 Codex 干活时,可以在个人级 ~/.codex/AGENTS.md 里引导它优先用连接器之类不抢前台的工具。Codex Cloud 每个任务独占一台虚拟机,不存在这个问题。
常见坑
- 只说做什么,不说验收看什么。模型会按自己的理解收尾,你再追问一轮,前面的上下文成本白付。
- 所有任务都开最高档。摸底类任务用 Extra High 只会更慢更贵;先 Medium,看到需要深追再升档。
- 子 Agent 没单独配档位。默认继承主 Agent,主 Agent 开着高档时,一批扫描型子 Agent 也跟着用高档。
- AGENTS.md 越写越长。把能从代码里看出来的规范删掉,超过 32 KiB 的部分直接被忽略。
完成标准
- 常用的三类任务(摸底、排错、开放研究)各有一个带验收标准的提示词模板,并标好档位。
config.toml的[agents]或自定义 Agent 文件里给扫描型子 Agent 配了更轻的模型或档位。AGENTS.md只剩推断不出的约定,加上了共享机器那一段。- API 侧固定指令已挪到第一条 developer 消息,不支持的采样参数已删掉。
Claude 那边也有一份同类指南,对照着看:Claude Fable 5.2 提示词怎么写。Codex 配置文件本身的写法见 Codex CLI config.toml 配置教程。
最后
下次给 Codex 派活时,先在需求后面补三行「验收时我会看」,再决定档位。