Skill Doctor 怎么用:用历史会话给 Skill 打分
Agent 回一句「完成了」,你看到的只是结果。中间它可能因为测试说明过时,绕了好几圈才跑通,这些弯路不会出现在汇报里,下一次还会再绕一遍。Warp 开源的 skill-doctor 专门翻这些旧账:读你本机 Claude Code、Codex 等工具的历史会话,按四条评分标准逐条打分,挑出不及格的会话,再据此给你的 Skill 起草修改 diff。本文按 SKILL.md、评分标准文件和 官方介绍页 整理它怎么装、怎么跑、分数怎么算,以及它给出的修改建议该怎么审。
弯路藏在过程里,汇报里看不到
Warp 工程师 Ben Holmes 在 10 月 15 日的博文《The road to self-improving software》里描述了这个问题:Agent 会在测试工具出 bug 时原地打转、反复绕过去,最后照样交差。单看结果没毛病,可每次都多花时间和 token,而且原因就在 Skill 定义里,改一行说明就能省掉。
他给的办法分四步:汇总团队过去的 Agent 会话(对话、工具调用、产出物);用你定义的评分标准给每个会话打分,可以用 LLM 当评审,也可以加静态分析;分数攒够以后,让一个 Agent 读所有低分会话、找共同原因;最后由它提议修改代码库、Skill 或 AGENTS.md。skill-doctor 就是这套流程的本机单次版,Warp Factories 则是在整个团队的会话上持续运行这套循环的版本(目前需申请早期体验)。
它改的是产出软件的流程,而不是软件本身:Skill 写得更准,下一次 Agent 就少绕一段路。
安装和支持范围
skill-doctor 放在 warpdotdev/common-skills 仓库(MIT 许可)的 .agents/skills/skill-doctor/ 目录。仓库 README 推荐用 skills CLI 安装:
# 先列出仓库里有哪些 Skill
npx skills@latest add warpdotdev/common-skills --list

# 只装 skill-doctor(CLI 会让你选目标 Agent)
npx skills@latest add warpdotdev/common-skills --skill skill-doctor

# README 里给 Warp 的写法
npx skills@latest add warpdotdev/common-skills --skill skill-doctor --agent warp --global
装好后在 Agent 里输入 /skill-doctor 启动。它先确认正在执行它的工具是否在支持名单里:Warp、Claude Code、Codex、Pi、Grok Build、ZCode、Hermes。识别不了就直接停下,不建报告目录、不读任何历史。各工具的会话来源分别是 Claude Code 的项目历史 JSONL、Codex 的 rollout JSONL、Warp 的本地会话数据库(只读)等。
隐私上,SKILL.md 写死了一条:全部在本地跑,不上传会话记录或其中任何片段,唯一可分享的是你自己决定发出去的那份报告页。产物都写进 mktemp 新建的临时目录,不往你的仓库里写文件。
一次运行分五步
启动后它会问两个问题:评哪些会话(当前仓库 / 全部 / 指定几个项目),评哪些 Skill(项目级加全局,或只看项目级)。接下来:
- 收集:
collect_sessions.py默认回看 45 天、最多抽 12 个会话,可用--days、--max-sessions调整,--include-subagents把子代理会话也算进来。项目级 Skill 从.agents/skills、.claude/skills、.codex/skills里找。 - 打分:每个会话按四份评分标准各给一个标签、一个分数和一到三句理由,理由要引用会话里的具体内容。超过 50 个会话时分批并行,但只能交给本机子代理。
- 汇总:算各项均值和总分,筛出「不及格会话」。
- 起草修改:只根据不及格会话,把改好的完整 SKILL.md 写到
proposed/目录,并生成diff -u。这一步不碰你真实的 Skill 文件。 - 出报告:
render_report.py生成一个自包含的report.html,评分卡、发现和建议 diff 都在一页里,可导出 1200×675 的分享图。最后它会问你要不要把建议应用到 Skill 上。
四个评分项和总分怎么算
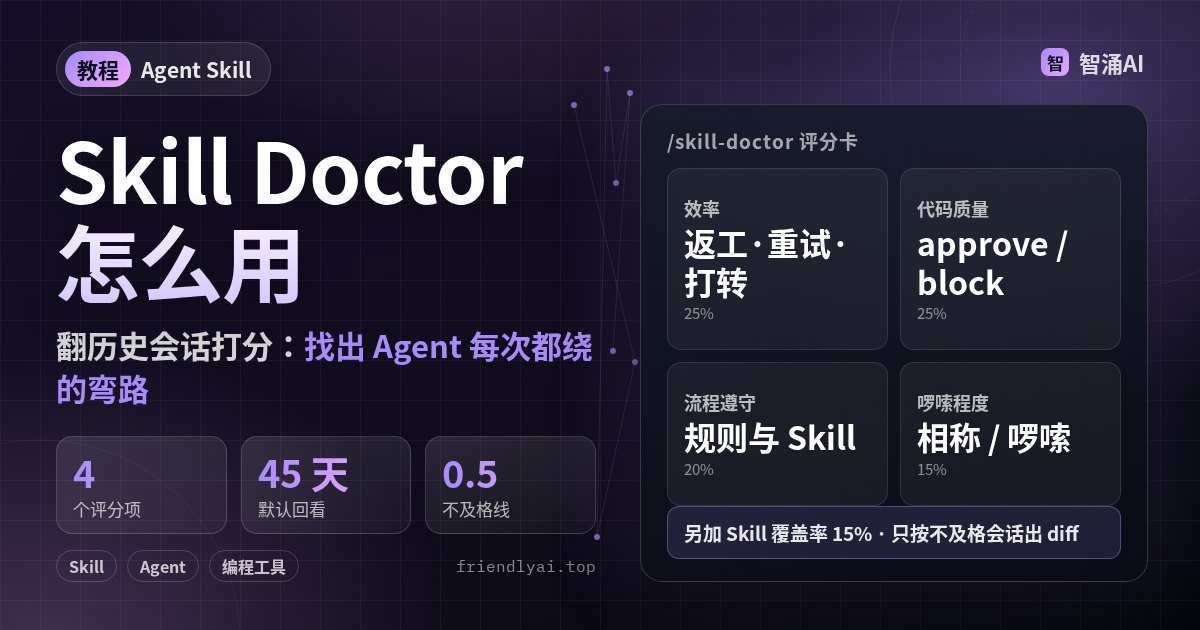
| 评分项 | 看什么 | 标签与分数 |
|---|---|---|
| 效率 | 是否直奔结果:返工、重复读文件、串行做本可并行的事、原样重试失败方案、检查做得太晚、反复要人纠正 | 1 / 0.8 / 0.4 / 0.2 四档 |
| 代码质量 | 按资深评审的标准看产出代码:设计、正确性、边界与并发、测试、是否混入无关改动 | approve 1,block 0.2;没有代码改动记「证据不足」,不计入均值 |
| 流程遵守 | 系统上下文里的规则(用户规则、仓库规则)和该触发的 Skill 有没有照做,有没有跳过必需的验证就报完成 | 1 / 0.8 / 0.2 三档 |
| 啰嗦程度 | 文字输出与工作量是否相称:复述需求、预告要做什么、重复总结算啰嗦;长时间不吭声、完成了不说改了什么算太简略 | 相称 1,啰嗦 0.2,太简略 0.1 |
四项均值先做一次曲线换算 0.5 + 0.5 × 原始分,换成报告里的字母等级分。再加上「Skill 覆盖率」,也就是抽样会话里至少用到一个已装 Skill 的比例。总分按权重合成:效率 25%、代码质量 25%、流程遵守 20%、啰嗦程度 15%、覆盖率 15%。
「不及格会话」只看曲线换算前的原始分:任意一项低于 0.5 就算。后面所有修改建议都必须追溯到这些会话里具体哪一次、哪个评分项、哪个时刻,不能拿通用最佳实践凑数。一个已经安装、却在不及格会话里没被触发的 Skill,通常是描述写得不对,单独值得一条建议。
它刻意少提建议
参考文件 skill-improvements.md 给提修改设了一道门槛,这部分可以直接照抄进你自己的复盘流程。先按根因把发现聚类,按「频率 × 严重度」排序,再拿当前仓库和配置核对一遍,核不上的丢掉。只有同时满足这些条件才提:失败确实源于某个具体位置(Skill、配置、仓库说明)缺了或写错了一条指令;你能说出那条可复用的规则;有这条规则并被遵守,失败就不会发生;同类问题出现在不止一个会话里,或者严重到一次就足以说明问题。
以下情况不提:原有指令已经要求了正确做法、是模型自己没照做;同样的提示和工具下模型偶尔选错;能做的改动只有重复强调、加免责、塞几个这次的例子;真正该修的是产品、基础设施或代码本身。改的时候优先替换旧说明,而不是再追加一段。文件原话是:什么都不改、逐条说明为什么不改,也算成功;一个凭猜测的改动比不改更糟。
官方介绍页的示例就很典型:报告给出 B 级、总分 82,效率 75、代码质量 93、覆盖率 74,建议删掉 test-desktop-app/SKILL.md 里一行过时的构建步骤,补一句「右键要用真实的鼠标事件,合成的 contextmenu 事件打不开菜单」。这类一句话的补丁,正是 Agent 靠试错才摸出来、每次都要重摸一遍的东西。
和其他复盘方式怎么配合
站内写过 /retro 复盘 Skill,它在单次会话结束时让 Agent 自己总结;skill-doctor 是隔一段时间翻一批历史,用固定标准横向比较,能看出「每次都在同一处绕路」这种单次复盘发现不了的模式。FlashRSI 走的是研究框架路线,自动化程度更高。三者可以叠用:日常 /retro,月底跑一次 skill-doctor 看趋势。博文也建议把分数随时间记下来,标出哪天合并了哪条 Skill 修改,之后分数变化才能当证据看。
最后
挑一个你装了好几个 Skill、最近用得最多的仓库,跑一次 /skill-doctor,只看报告里的三条发现和第一条 diff。改不改由你决定,先确认那条建议引用的会话你也认同。