AssemblyAI 发布 STT-3.7 三款语音模型
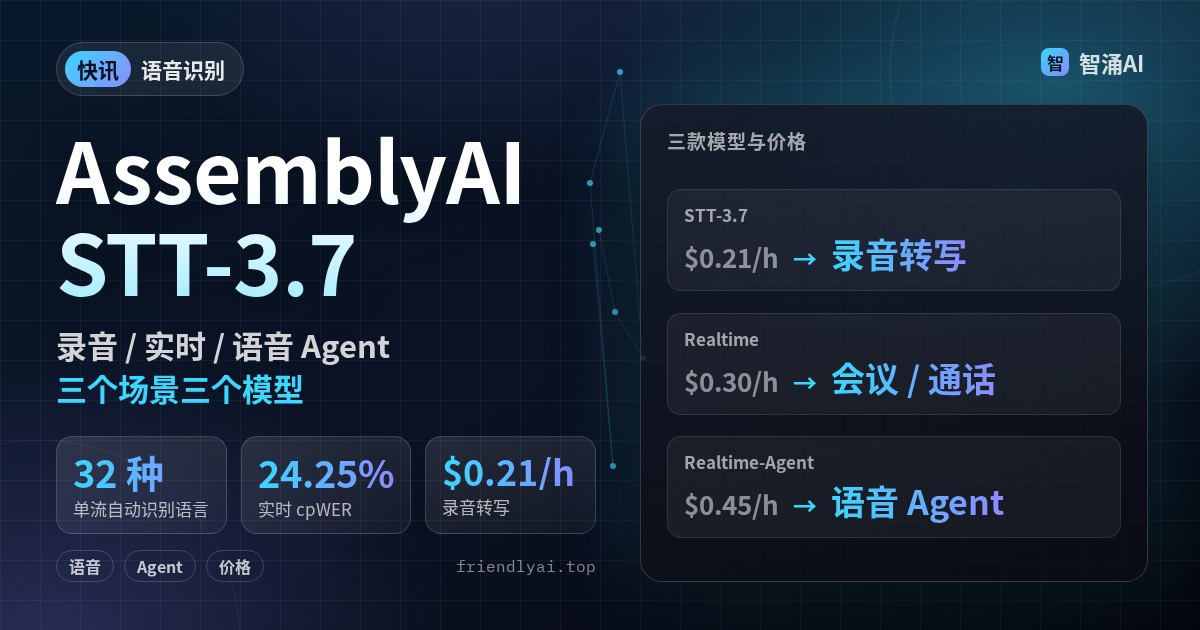
语音识别服务商 AssemblyAI 在 11 月 17 日发布 STT-3.7 系列,按场景拆成三个模型:STT-3.7 处理录音,STT-3.7-Realtime 处理会议、通话和字幕,STT-3.7-Realtime-Agent 专给语音 Agent 对话用。
Agent 版专门盯着和 Agent 对话的那个人,背景人声干扰大约减半,适合嘈杂环境里的客服和语音助手。录音版的说话人错误比 Universal-3.5 Pro 少约 29%。调用时在原有的实时或录音转写 API 里,把 speech_model 参数换成新模型名即可。
注意:准确率数字是 AssemblyAI 在自选数据集上公布的,中文场景的表现文中没有单列。