分类任务别再用大模型:Amazon 降本 98% 的换法
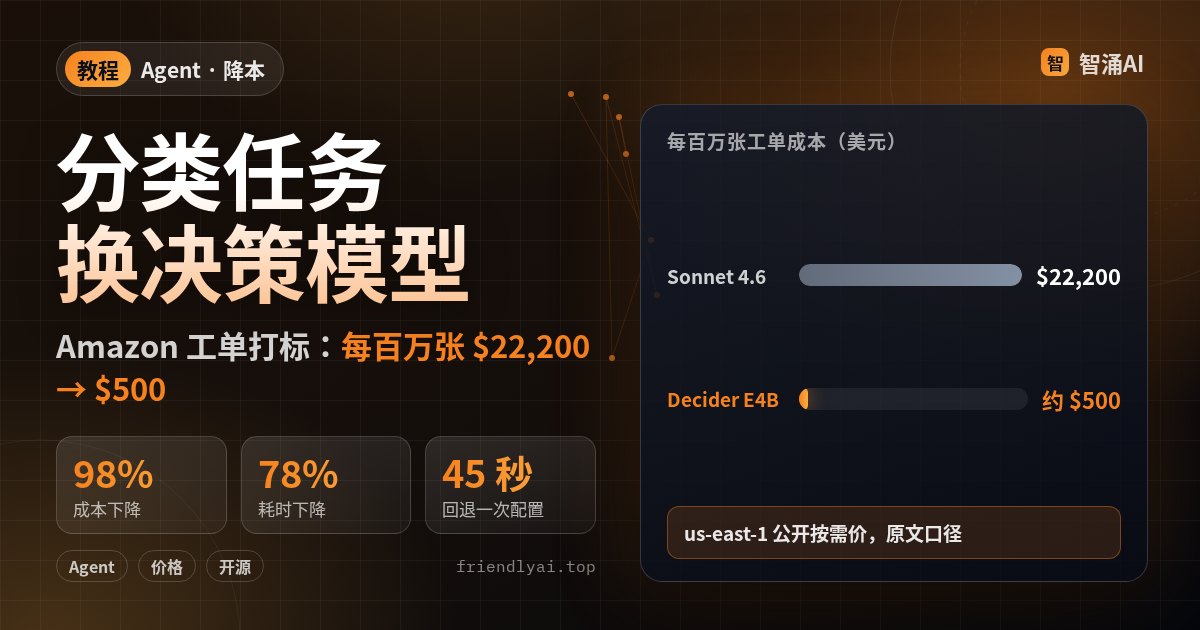
给几十个固定类别打标签,是很多团队最早上线的大模型任务:工单分派、告警归类、评论打标。它跑得稳,账单也稳步变大。Amazon 内部一个工单系统原来用 Claude Sonnet 4.6 给工单打 20 类标签,两位工程师在 2026-11-09 发文复盘,换成开源「决策模型」Strands Decider 之后,每百万张工单的成本从约 22,200 美元降到约 500 美元。这篇讲清这类任务什么时候能换、怎么换才不出事,以及他们踩到的一个怪坑。
决策模型和大模型差在哪
决策模型不生成文字。你给它一段状态(比如一张工单)和一个问题、一组选项,它返回每个选项的概率,外加一个置信度。Strands Decider 支持三种问法:从 N 个选项里选一个(choice)、是 / 否(noul,越接近 1 越偏「是」)、在有序刻度上打分(score)。按官方架构文档的说法,它拿一个预训练的解码器模型,去掉语言模型头,一次前向计算给所有选项打分,没有逐字生成的循环。
仓库 strands-labs/strands-decider 是 Apache-2.0 许可证,截至 2026-11-11 约 1,050 星。首个模型 2B 有 19 亿参数,README 写的是在 RTX 3090 上单个问题中位耗时 115 毫秒,也能在 Apple 芯片的 Mac 或 CPU 上跑。README 还说,在没见过的短分类任务上,置信度 0.9 及以上的回答约 95% 是对的,低于这个数就该复核或交给人。
先判断:你的任务能不能换
原文最后一节把适用范围讲得很直白。三个条件同时成立才值得试:
- 封闭选择:答案来自一份已知的类别清单。
- 量大:调用次数多到 token 费是一笔真钱。
- 延迟有意义:旧链路的耗时本身是个问题。
反过来,标签需要附解释文字、类别清单每周都在变、或者有用的上下文塞不进几千 token,原文的判断是决策模型大概率替代不了。
第一步:把标签说明改写成短选项
原来的做法是每张工单都带一份很长的系统提示词,让 Sonnet 输出 JSON 和推理过程。光是生产环境里的标签说明,就超过了 Strands Decider 4,096 token 的上下文窗口。他们把 20 个标签每个改写成一两句话的判定标准,作为一个选择题的选项发过去,再加一个「none」选项。工单内容和给 Sonnet 的一样,只是长工单会丢掉最早的评论来塞进窗口。
改写时可以照这个模板:每个选项写「什么样的工单算这一类」,避免写成产品名或部门名。「都不是」这个选项一定要有,否则模型只能在不合适的类别里硬选一个。
第二步:本地先问几条
README 给的入门方式是命令行。注意 Gemma 4 系列(Amazon 用的 E4B 就是其中之一)目前要从 GitHub 主分支安装,PyPI 上的包还不带:
pip install "strands-decider @ git+https://github.com/strands-labs/strands-decider"
strands-decider ask StrandsAgents/strands-decider-E4B-gemma4-v1-2610 \
  --state "Help! My payouts have been failing for 3 days! " \
  --choice "Which team should handle this?=billing,sales,retail" \
  --noul "Does this convey urgency?"
同一段状态可以一次问多个问题,状态只读一遍,比分开问省。要给别的服务调用,就起成 HTTP 服务:
strands-decider serve StrandsAgents/strands-decider-2B-qwen3.5-v1-2610 --port 8000
curl -s localhost:8000/v1/systemone -H 'content-type: application/json' \
  -d '{"state": "Help! My payouts have been failing for 3 days!",
       "questions": {"is_urgent": {"type": "noul", "instructions": "Does this convey urgency?"}}}'
README 里的示例返回带 usage 字段,输出 token 是 1。拿自己的几十张历史工单试,看置信度分布,再定一个阈值:高于阈值自动打标,低于阈值走旧模型或人工。
第三步:三档开关,在真实流量上换
原文说这是不管换不换模型都值得照抄的部分。打标签的 Lambda 每处理一条消息,都从 AWS AppConfig 读一个三档设置:
| 档位 | 谁打标签 | 用途 |
|---|---|---|
BEDROCK | 只有 Sonnet,不调用新模型 | 原状 |
DUAL | 两个模型并行调用,结果以 Sonnet 为准,和新模型逐条比对 | 在真实流量上攒分歧样本 |
DECIDER | 只有 Strands Decider,不再调用 Bedrock | 切换完成 |
他们先用 2B 模型,在测试集上发现 E4B 明显更好,就换了 E4B,又调了「多高置信度才打标签」的阈值,结果在另一批工单上 E4B 超过了生产环境里的 Sonnet。
在真实流量上双跑、逐条判每一处分歧,比任何离线评测告诉他们的都多;想退回去,改一下配置,45 秒。
换完的账
| 指标 | Claude Sonnet 4.6 | Strands Decider E4B |
|---|---|---|
| 单次平均耗时 | 4,215 ms | 897 ms(降 78%) |
| 每张工单 token(输入 + 输出) | 6,554 + 170 | 2,009 + 1(总量降 70%) |
| 每张工单成本 | $0.0222 | 约 $0.0005 |
| 每百万张工单 | 约 $22,200 | 约 $500 |
口径:us-east-1 公开按需价。Sonnet 按 Bedrock 全球端点每百万输入 3 美元、输出 15 美元算;E4B 跑在 SageMaker ml.g5.xlarge(一张 A10G,24 GB)上,每实例小时 1.408 美元,模型占约 19 GiB,单请求约 640 毫秒。满负荷一台每小时约 5,600 张,合每百万张 250 美元;留出突发余量后实际约 500 美元,约便宜 44 倍。Lambda 本身的费用没算进去,它的平均执行时长在关掉 Sonnet 那天降了 74%。这些都是原文按公开价算的数,你的流量形态不同,结果会不同。
整条链路都是标准 AWS 服务:工单事件进 SQS,触发 Lambda,Lambda 调 SageMaker 端点,AppConfig 放开关,CloudWatch 管日志和告警,CDK 定义 Beta、Gamma、Prod 三个部署阶段。端点网络隔离,容器不能出网,启动时从 S3 拷入权重。
常见坑
- JSON 键的顺序会改答案:同样的内容,键换个顺序,输出概率最多差 0.19。他们现在每个请求都按键排序再发。比较两次运行之前先统一这一点。
- 选项写成长段说明:4,096 token 的窗口装不下原来的标签文档,必须压成一两句判定标准。
- 没有「都不是」:不属于任何类的工单会被硬塞进某一类。
- 直接切到新模型:跳过双跑,就没有分歧样本可看,出问题时也不知道是哪一类坏了。
- 低置信度也照单全收:先按自己的数据定阈值,低于阈值的走旧路径或人工。
完成标准
- 类别清单已压成短选项,含「都不是」,单次请求在 4,096 token 内。
- 本地在几十条历史样本上跑过,定下了置信度阈值。
- 线上有三档开关,
DUAL档跑过一段真实流量,分歧样本逐条看过。 - 切到新模型后,耗时、成本、标签分布都有对比数据,回退路径验证过。
最后
翻一下你账单里调用最多的那条大模型链路,如果它只是在固定选项里挑一个,就按上面三个条件对一遍。外壳和规则放在哪会怎么影响成本,可以接着看 同模型换 Agent 外壳:成本差一倍;双跑之后怎么评估,见 Agent 评测驱动开发。