字节 Seed 开源 Cola2:用连续潜变量生成文本
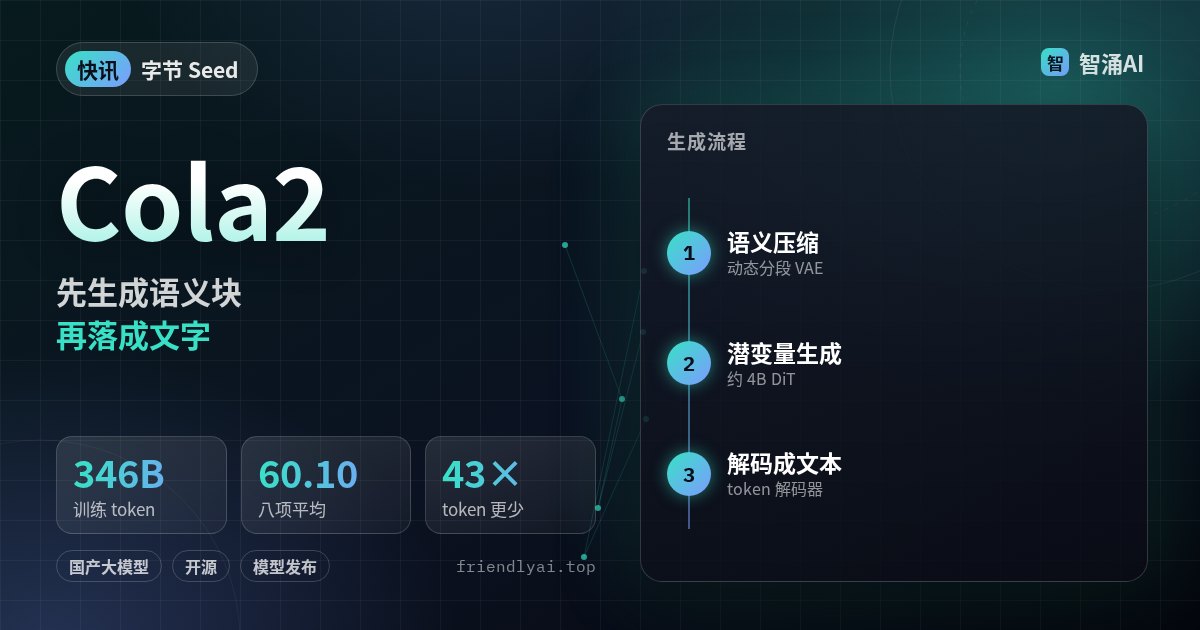
字节跳动 Seed 团队北京时间 11 月 6 日在 GitHub 和 Hugging Face 开源 Cola2。它的生成方式是:先把文本动态切成语义片段、压成连续潜变量,用扩散 Transformer 生成潜变量块,再解码成具体文字。代码许可证为 Apache 2.0。
论文在同等规模、数据下对比了自回归、LLaDA 和几种 Cola 变体:带压缩的 Cola2 收敛更慢,但在约 150B token 后持续缩小与 LLaDA 的差距,到约 210B token 时仍未饱和。团队强调这个检查点的潜变量 DiT 还没训到收敛。
对做扩散语言模型、非自回归生成的研究者,这是一套可直接跑的开源基线,离生产使用还远。
注意:分数为论文报告值;潜变量生成带随机性,单次运行结果可能不同。