改不到 10 个神经元,就能给 Agent 埋后门
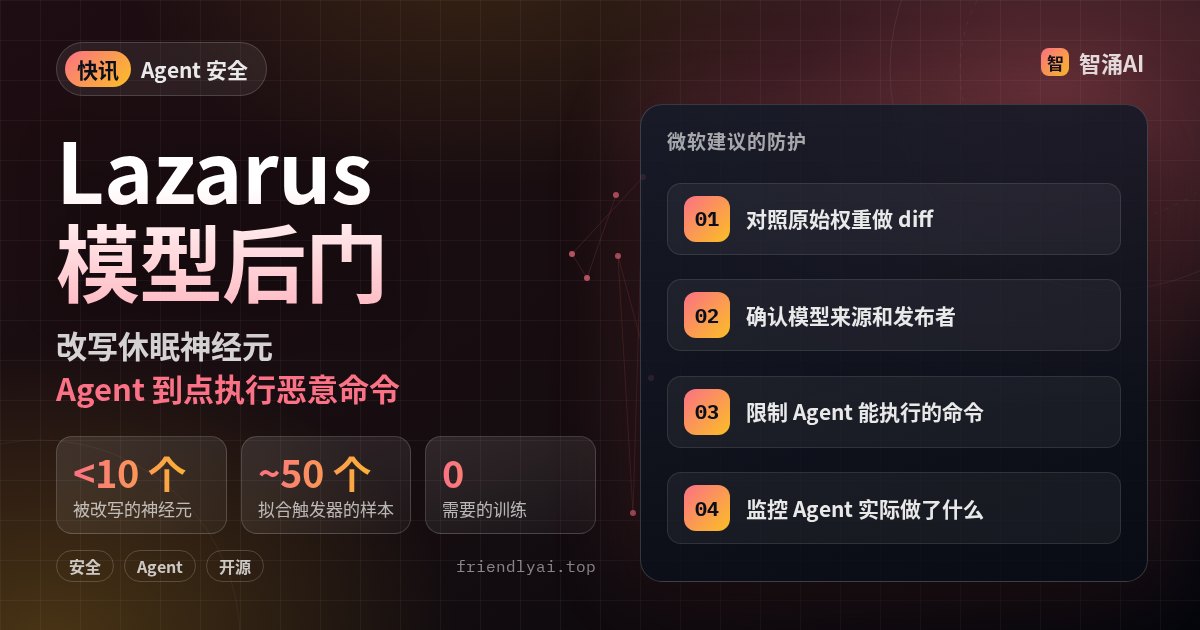
微软研究院 11 月 10 日发文公布一种叫 Lazarus 的后门手法:改写大模型里不到 10 个平时几乎不激活的神经元,不需要训练,就能让基于这个模型的 Agent 在特定触发条件下输出攻击者指定的命令。
预训练让模型内部表征组织得很好,用约 50 个样本拟合的线性分类器就能区分带触发器和不带触发器的输入;一个被改写的神经元激活后可以强行注入一个 token,串起多个神经元就能拼出完整命令。作者提到,最初的实验是让 Claude Code 完成的,大部分发现也由它自主做出。
这类修改能被查出来,让前沿 Agent 去检查权重,可以发现异常改动。但没有哪种扫描能证明模型绝对安全,可靠的办法是和未修改的原始权重做 diff,所以模型从哪来、中途有没有被动过很关键。微软表示 Foundry 会把开源权重模型绑定到原始发布者,并在开发权重扫描和模型签名。
注意:这是研究团队公开的攻击方法和防护建议,微软威胁情报团队表示还没有发现攻击者实际使用这一手法。给 Agent 开终端或工具权限的团队,可以先从限制权限和核对权重哈希做起。