常驻 Agent 怎么防:OpenAI 内部的五道安全线
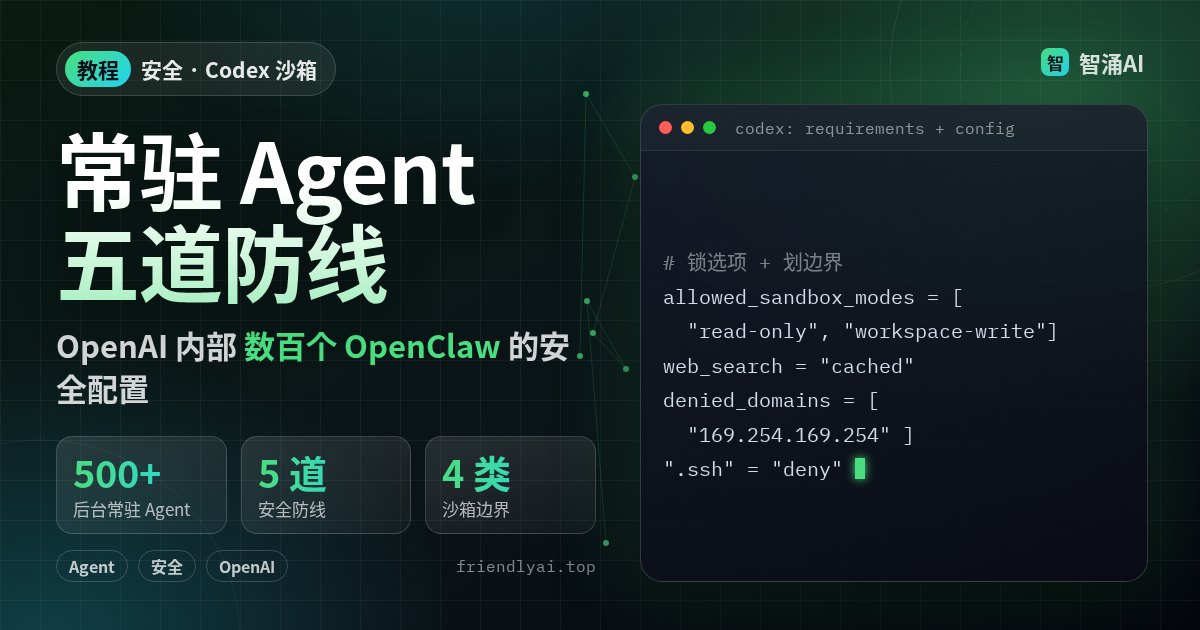
普通的 Codex 会话有固定目标、有人盯着;常驻 Agent 一天 24 小时在跑,范围宽,还会主动动手,可以改自己的配置、写任意代码。OpenAI 内部现在有 500 多个 Agent 在后台主动干活,其中数百个是 OpenClaw,它在开发者博客上公开了这批部署用的安全控制,并贴出了 Codex 沙箱的配置片段。这篇把它拆成五道防线,每道给出能照着改的配置和检查点,适合正在给团队上线常驻 Agent 的人。
威胁从内部来,所以先拆开可信和不可信
传统软件的假设是:配置和代码行为确定,威胁主要来自外部攻击者。博客指出常驻 Agent 打破了这两点,Agent 会自己改配置、写代码,风险来自它做出偏离目标的操作。
OpenAI 的第一步是分层。网络、身份、沙箱这些属于可信逻辑,是传统的静态代码;Agent、它运行的环境、它写出的代码一律视为不可信。为此他们在 OpenClaw 开源项目里实现了远程 harness 执行,让负责配置 Agent 的 OpenClaw Gateway 跑在单独的容器里(OpenAI 自己是放在另一个集群),和 Agent harness 分开。这样 Gateway 可以当成可信代码管,沙箱只需要盯住 Agent 的工作负载。
| 防线 | 管什么 | OpenAI 的做法 |
|---|---|---|
| 分层 | 谁可信 | Gateway 与 Agent harness 分容器、分集群 |
| 沙箱 | 网络 / 文件 / 进程 / 密钥 | 组织白名单、只写工作目录、Codex Linux 沙箱、凭据代理 |
| 模型审查 | 每个操作 | 所有 Agent 操作强制 Auto-review |
| 身份 | 谁做的 | 每个 Agent 独立身份,关联 ChatGPT 服务账号 |
| 可观测 | 做了什么 | 控制面配置变更 + Agent 每一轮全记录 |
第一步:用 requirements.toml 锁住能选的选项
Codex 的配置分两层:requirements.toml 限制配置里允许出现哪些选项,config.toml 是实际生效的配置。前者相当于管理员上的锁,用户级配置放不宽它。博客里的片段(注释为原文含义):
# 去掉不受限的 danger-full-access 沙箱模式
allowed_sandbox_modes = ["read-only", "workspace-write"]

# 只允许缓存搜索,不允许实时联网搜索
allowed_web_search_modes = ["cached"]

# 强制走受管网络代理,且用户配置不能扩大域名白名单
experimental_network.enabled = true
experimental_network.managed_allowed_domains_only = true

experimental_network.allowed_domains = [
  "github.com", "api.github.com", "codeload.github.com",
]

# 显式拉黑,包括云厂商元数据地址
experimental_network.denied_domains = [
  "pastebin.com", "*.pastebin.com", "webhook.site",
  "metadata.google.internal", "169.254.169.254",
]
白名单要换成你的工作负载真正需要的主机。黑名单里那两个元数据地址值得每家都加:Agent 一旦能访问云主机的元数据接口,就可能拿到实例凭据。缓存搜索的意思是,搜索请求走 OpenAI 自己的索引,Agent 不直接去访问实时网页。config.toml 的一般写法可以先看站内的 Codex config.toml 教程。
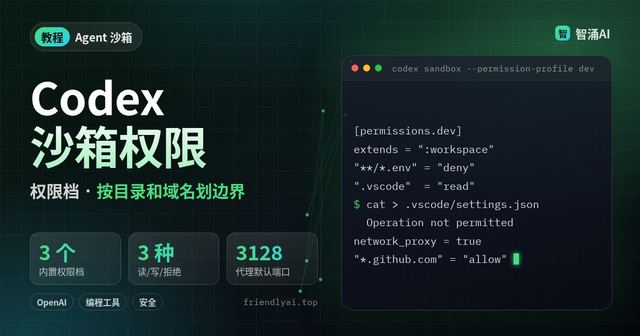
第二步:用 config.toml 划文件、网络和环境变量
博客用一个名为 openclaw 的权限配置,关键几段:
default_permissions = "openclaw"
web_search = "cached"

[permissions.openclaw.filesystem]
":minimal" = "read"                               # 最小运行环境只读
"/home/dev-user/openclaw-workspaces" = "write"    # 只有工作目录可写
"/home/dev-user/read-only" = "read"               # 受管资源只读
"/home/dev-user/.ssh" = "deny"                    # SSH 凭据不可访问

[permissions.openclaw.network]
enabled = true
allow_upstream_proxy = false
allow_local_binding = false        # 保留本地/私网地址防护
enable_socks5 = false
enable_socks5_udp = false
dangerously_allow_non_loopback_proxy = false
dangerously_allow_all_unix_sockets = false

[shell_environment_policy]
ignore_default_excludes = false    # 保留默认的敏感变量过滤
exclude = ["GH_TOKEN", "GITHUB_TOKEN",
  "OPENCLAW_GITHUB_BASIC_AUTH", "OPENCLAW_GITHUB_READONLY_BASIC_AUTH"]

[apps._default]
enabled = false                    # 应用默认关闭,逐个开
destructive_enabled = false
open_world_enabled = false
注意原文的一句提醒:从环境变量里去掉 GitHub 令牌,挡不住写在 Agent 能读到的文件里的凭据。所以文件权限那段 .ssh = "deny" 和环境变量过滤要一起上。密钥本身,OpenAI 是交给凭据代理(credential broker)管的,Agent 看不到明文;进程隔离用的是 Codex 的 Linux 沙箱。
环境变量删掉令牌只是一半,令牌要是躺在 Agent 读得到的文件里,照样会被拿到。
第三步:让另一个 Agent 先审,人只看要紧的
静态规则靠确定性代码,模型越来越强,防线也要跟着算力涨。OpenAI 的办法是 Auto-review:第二个 Agent 监看并批准主 Agent 的操作。理由很实际,每个操作都要人点确认,人会被训练成看都不看就点「允许」。用模型审查做一层过滤,人的注意力留给高价值的审批。博客说这个功能 OpenClaw 和 Codex 都原生支持,OpenAI 的部署对所有 Agent 操作都强制开启。
第四步:Agent 身份和用户身份分开
出了事要能查清是 Agent 做的还是人做的,还要能单独给 Agent 授权。博客提到两类新规范:WAG 给 Agent 自己的资源访问权,XAA 让 Agent 通过 OAuth 委托代表用户行事。它也强调 Agent 身份不等于服务账号,两者要配合用:Agent 用自己的身份行动,通过与该身份关联的服务账号访问第三方服务。
OpenAI 的落地方式是每个 Agent 一个唯一身份,关联一个 ChatGPT 服务账号。这样每个 Agent 有和用户分开的推理凭据,团队能给它接自定义插件,审计时能追到具体 Agent,必要时可以直接停掉它的推理。
第五步:全部记录,日志也要上锁
OpenAI 记录两类东西:控制面上的每一次配置变更,和 Agent 的每一轮对话。因为对话里可能有敏感信息,这些日志锁死,只开放给安全团队的少数几个人。
常见坑
- 只写 config.toml 不写 requirements.toml:用户或 Agent 改一行配置就能放宽沙箱。限制要放在 requirements 那一层。
- 白名单照抄示例:示例只放了 GitHub 三个域名,你的 Agent 要访问的包仓库、内部 API 得自己列,也别图省事放通配。
- 以为过滤环境变量就安全了:文件里的凭据另算,配合文件 deny 和凭据代理。
- 审批全丢给人:确认弹窗多到麻木,等于没有审批。先让模型审查过滤一遍。
- Agent 共用人的账号:日志里分不清是谁干的,出问题也没法只停 Agent。
完成标准
- Agent 的运行环境里,
danger-full-access不可选,访问白名单外的域名和169.254.169.254都被拒。 - Agent 只能写自己的工作目录,读不到
~/.ssh,环境变量里没有 GitHub 令牌。 - 每个常驻 Agent 有独立身份,能在日志里按 Agent 查到配置变更和每一轮操作。
- 写操作先过模型审查,真正送到人手里的确认只剩少数高风险项。
最后
手上已经有常驻 Agent 在跑的话,先补第一步:写一份 requirements.toml,去掉 danger-full-access,把网络收进白名单并拉黑元数据地址。这一步改动小,挡住的风险最大。想直接用现成的控制面,可以看 OpenAI 开源的 OpenClaw Enterprise,博客说它用标准 Codex 预设启动时自带上面多项防护,目前还在试点阶段,计划年底前出 1.0。