OpenAI BioBasicsBench 湿实验评测
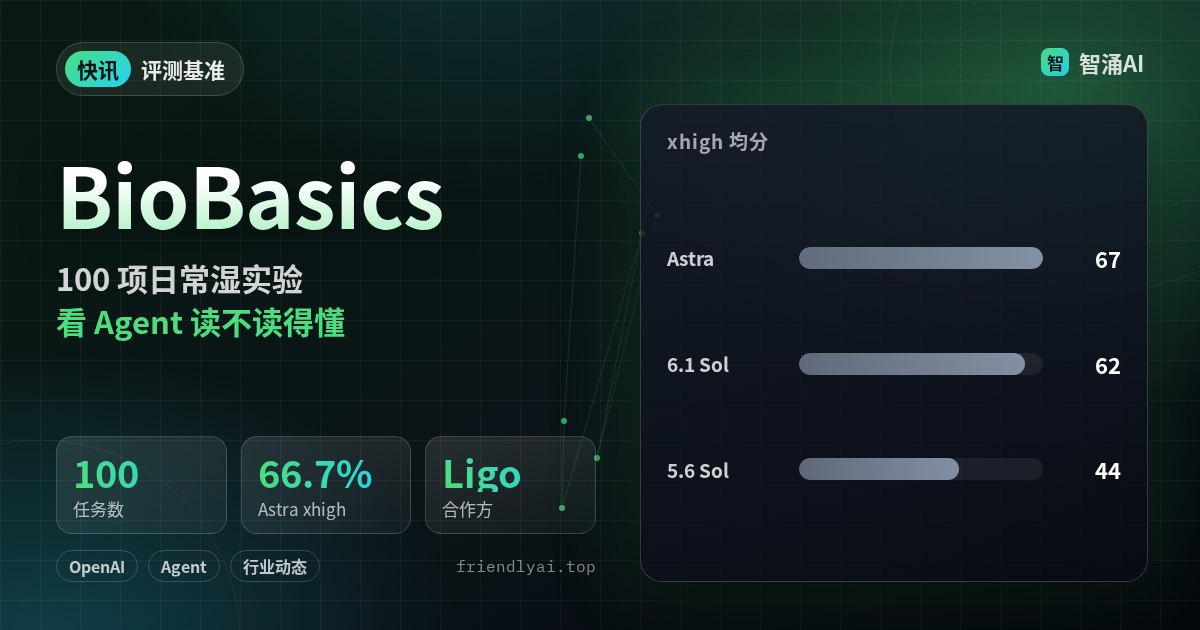
OpenAI 11 月 6 日推出 BioBasicsBench:与酶设计公司 Ligo 合作,用 100 道日常湿实验任务测 Agent 能否解读原始实验证据——胶图、菌落板、显微、仪器导出,而不是论文里挑好的图。xhigh 设置下 GPT-6 Astra 均分约 66.7%,GPT-5.6 Sol 约 43.8%。
现有生物基准常围绕论文精选图表,日常实验却充满失败对照、模糊图像和互相打架的观察。BioBasicsBench 把「读原始数据、查对照、知道何时不能下结论」单独拎出来。对想做实验室助手的团队,这比刷论文 QA 更贴工位;对 biosafety 讨论,日常判读能力也是评估面之一。
分数仍远谈不上「能独立下可靠实验判断」。官方自己列了假设压过对照、忽略矛盾区域、菌落多计约 12% 等失败模式。站内写过 LifeVal 等日常任务评测,这条专攻湿实验多模态读数。
注意:分数与任务设计来自 OpenAI 官方博文;基准面向评测与改进,不代表可直接替代实验室人员。