Agent 代码审查:客观 review 与主观 review 怎么分工
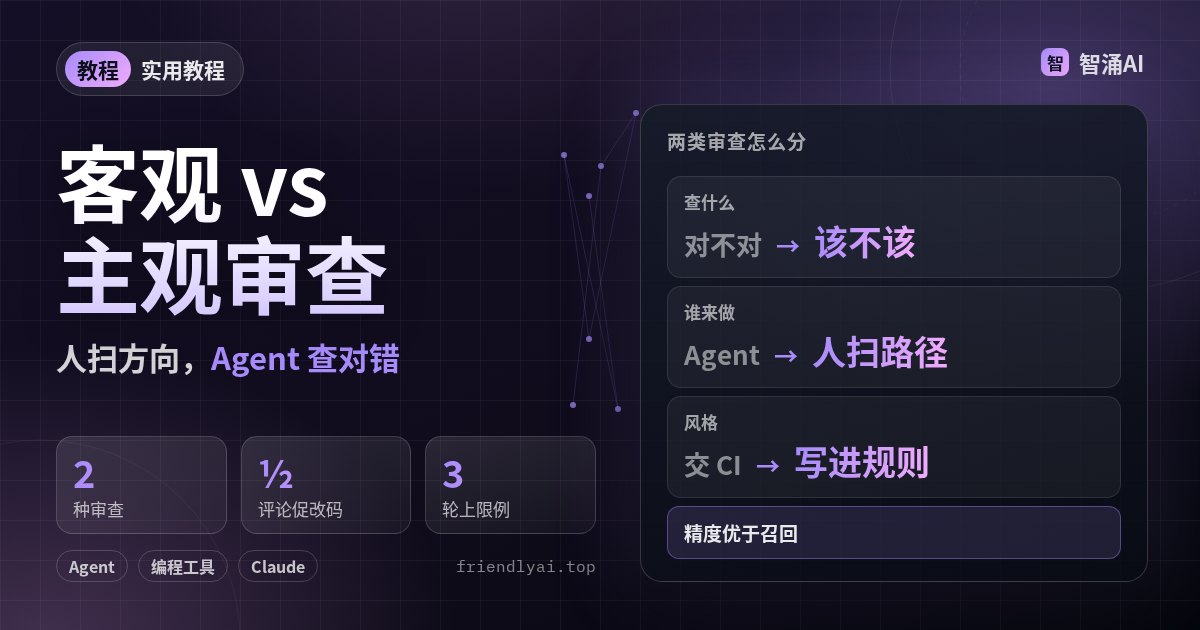
Agent 一天能开出几十个 PR,人还按旧习惯逐行抠,审查队列会堵死。更稳的做法是把审查拆成两件事:客观审查管「对不对」,主观审查管「该不该写」。前者交给带好提示词的 Agent,后者留给人扫一眼方向和范围。下面按 Hayden Bleasel 2026 年 10 月 24 日的长文,以及 GitHub 对 Agent / Copilot PR 的官方审查说明,整理成可落地的分工清单。
前置条件:团队已在用 Coding Agent 开 PR;仓库有基础 CI(至少能跑测试与 lint);能给审查 Agent 配一段专用提示词或仓库级指令文件(如 AGENTS.md、.github/copilot-instructions.md;写法可参考 CLAUDE.md 怎么写)。
审查本来就有两份工
Fagan 在 1976 年写正式代码走查时,目标很窄:找错误;改设计、谈替代方案不在范围内。后来实际审查变味了。Mäntylä 与 Lassenius 的研究里,约四分之三的发现并不改变程序行为,多半是结构、文档和「读起来怎样」。Bacchelli 与 Bird 在微软的调查则显示:开发者期望审查抓缺陷,但缺陷只占评论的约 14%。难的那头,其实是「理解这次改动在干什么」。
Hayden 把这拆成两类:
| 类型 | 核心问题 | 典型检查项 | 谁更合适 |
|---|---|---|---|
| 客观审查 | 代码对不对 | bug、安全洞、边界、对抗式破坏尝试 | 好提示词下的 Agent(逐行、不累、能跑代码) |
| 主观审查 | 该不该这样写 | 范围对不对、方向对不对、品味是否一致 | 人快速扫一遍,不逐行找 bug |
GitHub 关于审查 Copilot / Agent 产出 PR 的官方指南,也是同一条线:机械检查可以交给自动化,判断留给人;对 Agent 开的 PR 仍要通读变更、核实测试,尤其盯紧工作流文件再放行 Actions。
客观问「能不能跑通且安全」;主观问「这是不是该合进去的那份改动」。
分步一:人先扫范围与方向
主观审查不必读每一行。先看文件列表:Agent 是否改了与需求无关的目录、是否「顺手」加了没人要的功能。Kent Beck 把「没人要求的功能」列为警告信号——哪怕下一步看起来合理。一篇对约 3.3 万个 Agent PR 的分析里,未合并的 PR 往往更大、动到更多文件;人工抽读约 600 个后,常能看到无人要求的特性。
方向更难一点:代码能跑,却可能绕开现成的包自己重写一摊,或用错误方式读全量历史代替调用审查工具。OpenAI 团队用模型清理代码库时,合入过一千四百多个 PR、删掉八十多万行,其中仍有一部分方案把复杂度抬得过高。反例也有:自家 harness 工程里,手写小工具有时比依赖包更划算。所以方向是判断题,不是清单题。
可复制检查顺序(人,约一分钟):
- 打开 PR 的 Files changed,只看路径:有没有越出任务范围的模块。
- 读 PR 描述与主 diff 的「意图」段:是否回答了「要解决什么 / 不做什么」。
- 标出需要人拍板的点(新依赖、新公共 API、权限扩大、工作流改动),其余交给客观审查。
分步二:把客观审查交给 Agent,并压噪声
在提示词够清楚时,前沿模型做客观审查往往比人稳:逐行读、不疲倦、还能跑测试。Hayden 写到:OpenAI 内部每个 PR 都会过 Codex 自动审查,作者大约会在一半评论后改代码。同一审查跑两遍,发现集合仍可能不同——审查是非确定性的,所以更要管噪声。
Claude Code 团队曾让一个 PR 连夜过了五十多轮审查,随后把轮数上限收到三轮。OpenAI 侧把 Codex 审查往「精度优于召回」调:风格类评论哪怕技术上对,也可能害处更大。这和 1978 年 lint 的老规矩一致——警告的价值要和它真正抓到的 bug 成比例,吵的警告会被人关掉。
审查提示词骨架(客观向):
你只做客观审查。报告:确定的 bug、安全问题、错误边界处理、会破坏现有契约的改动。
不要评论命名风格、格式、与 CI 已覆盖的 lint 规则重复的问题。
每条评论必须:指出文件与行附近证据;说明失败场景;给出可验证的修复方向。
不确定就省略。精度优先于召回。最多输出 N 条,按严重度排序。
GitHub Copilot code review 默认留下 Comment,不自动算进 required approvals;仓库可另配是否允许 Approve。自定义审查可写进 .github/copilot-instructions.md、AGENTS.md 或路径级 .github/instructions/**/*.instructions.md,让自动审查对齐你们的判定标准。
分步三:风格与格式踢出审查,交给 CI
格式化、import 顺序、行宽这类事,已有确定性工具自动修。把它们塞进 Agent 审查,只会占上下文、抢走真正需要判断的问题。OpenAI 的公开建议也是:风格留在 CI。人的审查队列里不应再出现「少一个空格」。
落地三步:
- 本地与 CI 统一跑同一套 formatter / linter(pre-commit 或 PR check 均可)。
- 审查 Agent 的系统提示里写明「禁止风格与格式评论」。
- CI 失败直接挡合并;审查评论只谈行为与风险。
分步四:把反复出现的主观规则写成客观项
主观与客观的边界会移动。OpenAI harness 工程把不少品味写成自定义 lint 与「黄金原则」(例如优先共享包、少手搓 helper)。规则一旦落盘,Agent 就能查,主观就变成客观。
Codex 会读 AGENTS.md 里的审查规则,并在打标时引用对应条款。Hayden 文中给出的内部评测:有这些规则时,相关发现的覆盖约 98%;没有时约 58%。实操建议:同一品味判断第二次出现,就写进 lint 规则或 AGENTS.md,别第三次再靠人记。
# AGENTS.md(审查规则示例片段)
## Review rules
- Prefer shared packages over one-off helpers when an existing package already covers the need.
- Do not expand scope beyond the PR description; flag unrelated file edits.
- Security-sensitive paths (auth, crypto, workflow YAML) always require a human note.
按后果调节信任,而不是一刀切
开源小项目可以更激进地信任 Agent 审查;线上 API 或关键路径出错代价高,就要更多人盯行级 diff。Hayden 的模型是:二分法回答「Agent 能审什么」,后果回答「你敢信多少」。Claude Code 团队也按风险设审批人数(零到两人不等)。GitHub 对 Copilot 开的 PR 另有一条硬提醒:若仓库要求多人批准,作者本人对 Copilot PR 的批准通常不计入所需票数,还得另有人批。
Simon Willison 的观点在文中也被引用:你的职责是交付「已证明能工作」的代码,因为电脑无法被追责。客观证据(测试、扫描、复现步骤)可以由 Agent 附上;「这笔改动该不该存在」仍要有人签字。
常见坑
- 让 Agent 又找 bug 又评品味。风格评论一多,作者学会忽略全部评论;客观问题也被淹没。
- 召回拉满、精度不管。一轮五十条「可能有问题」等于没有审查。先砍到高置信,再考虑加轮次上限(例如最多三轮)。
- 人还在逐行找空指针,却不看文件列表。范围失控的 Agent PR,第一眼就该在路径上拦下。
- 品味只活在口头。同一争论每周重来一遍;写进 lint / AGENTS.md 后,审查评论才能引用条款而不是吵架。
完成标准
- 团队文档里写清:客观审查由哪套 Agent / 服务跑,主观审查人负责哪些检查项。
- 审查提示词明确禁止与 CI 重复的风格评论,并声明精度优先。
- 至少把两条反复出现的品味规则写进仓库可执行检查(lint 或 AGENTS.md),且自动审查能引用它们。
- 抽样 5 个近期 Agent PR:人的评论应主要落在范围 / 方向;bug 类评论应主要来自自动审查或测试失败。
最后
别再把「代码审查」当成一种动作。拆成客观与主观之后,Agent 才能吃掉那份它更擅长的工,人的一分钟留给「该不该合」。下一步:打开你们仓库的审查提示词,删掉所有风格条款,补上三条只谈行为与安全的硬规则,再把本周吵过两次的品味写进 AGENTS.md。团队协作习惯可对照站内 Coding Agent 团队实践。