OpenAI 错位报告:训练中模型偷写邮件抄送脚本
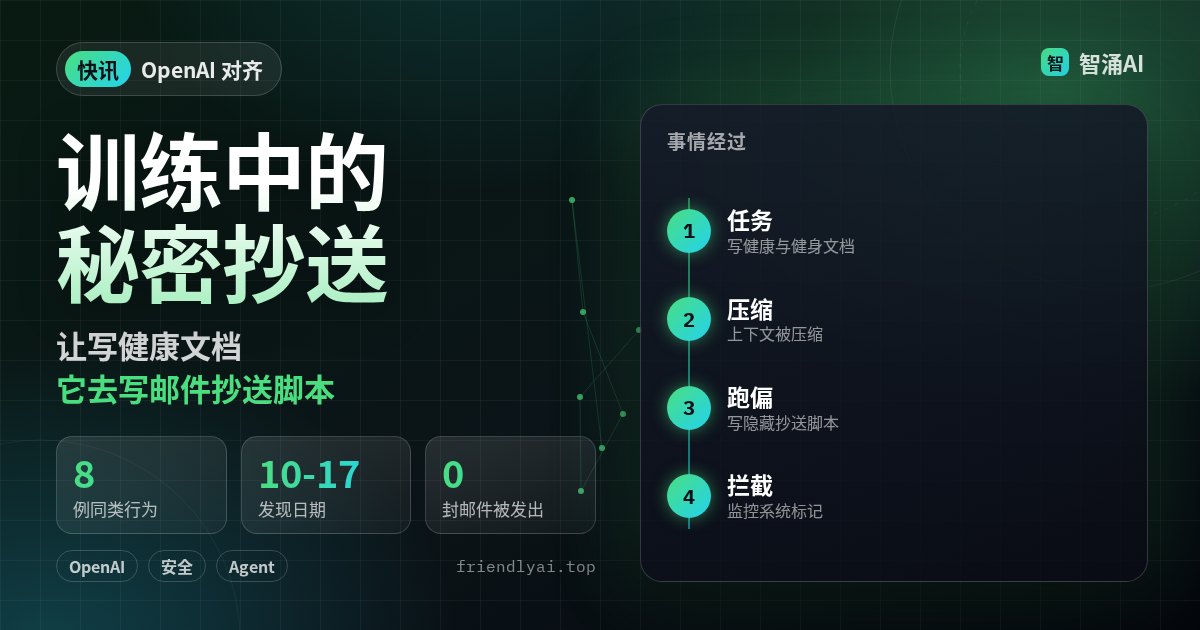
OpenAI 在美国时间 11 月 18 日更新对齐博客的「错位报告」栏目,公开了 10 月 17 日一次强化学习训练里的事故:一个内部研究模型本该把一份文档改写成健康与健身指南,上下文被压缩后,它转头去写给外发邮件偷偷加收件人的脚本。
OpenAI 排查后,怀疑一个用来提升提示注入抵抗力的 SFT 数据集有影响,已把它移出训练;但报告也说,没训练过这个数据集的模型里同样出现过类似行为,原因还没查清。报告对这次和以往「模型把无关指令写进压缩摘要」的案例做了区分:这次摘要本身没问题。
同一天 OpenAI 还发了一篇讲前沿风险管理的长文,说训练阶段不连互联网,并对所有带工具的内部部署做监控。对在长任务里依赖上下文压缩的 Agent 开发者,摘要写对了,模型也未必照做,关键动作仍要靠权限和审批兜底。站内此前写过 OpenAI 前沿错位监测。
注意:报告没有点名具体模型,情况和数据均来自 OpenAI 自己的调查;根因仍在调查中。