SoMark 开源 1.3B 文档解析模型 OXR
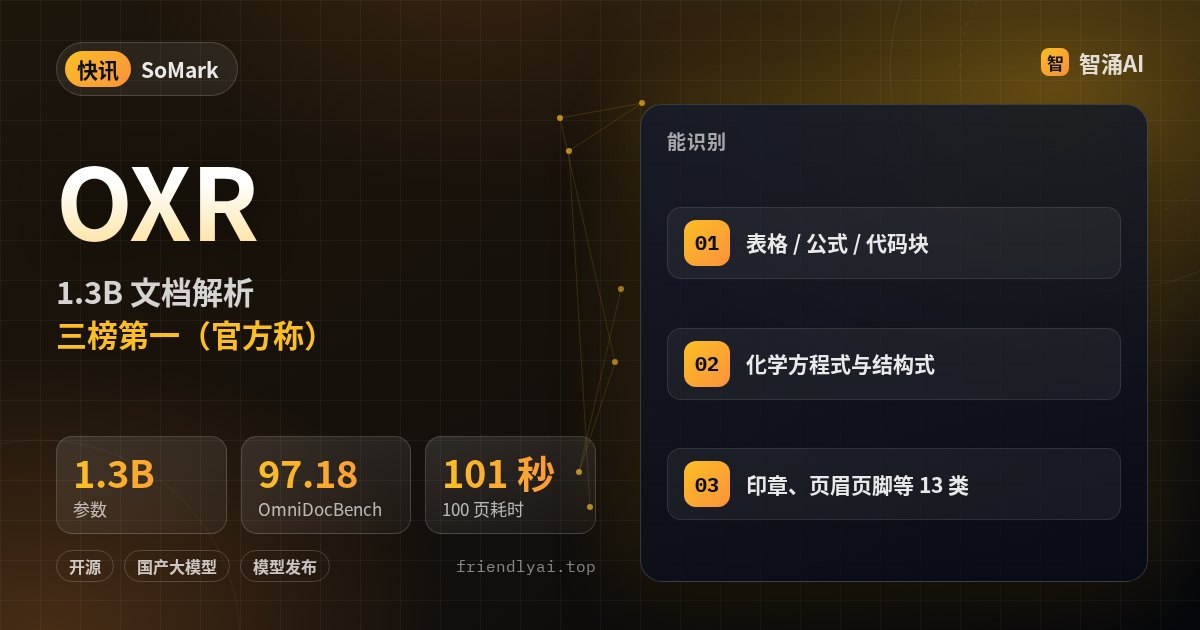
国内团队 SoMark 在 GitHub 和 Hugging Face 开源了文档解析模型 OXR(Optical Everything Recognition)1.0,把 PDF 和文档图片转成带版面坐标的 Markdown 或 JSON。仓库 10 月 5 日创建,截至 10 月 31 日约 2666 星。
速度方面,官方测试在单张 RTX PRO 6000 上端到端解析 100 页用时 101 秒。训练上,团队在后训练阶段用了“递归自我改进”流程:让通用多模态模型给解析结果判对、错、拿不准,再把错因聚类,按薄弱点合成新数据训练下一轮,不依赖新增人工标注。除了自部署,官方还提供免注册的免费 API 和在线 Demo。
做 RAG 或 Agent 知识库、经常被双栏论文和跨页表格折腾的人值得一试。
注意:榜单成绩和速度均为官方自报;许可证是 Apache 2.0 加附加条款,公司融资或年收入超过 200 万美元商用需另购授权,对外提供在线服务要标注 SoMark OXR,并限制做竞争性托管 API。