32GB Mac 跑 180B MoE:Transformers 专家流式加载
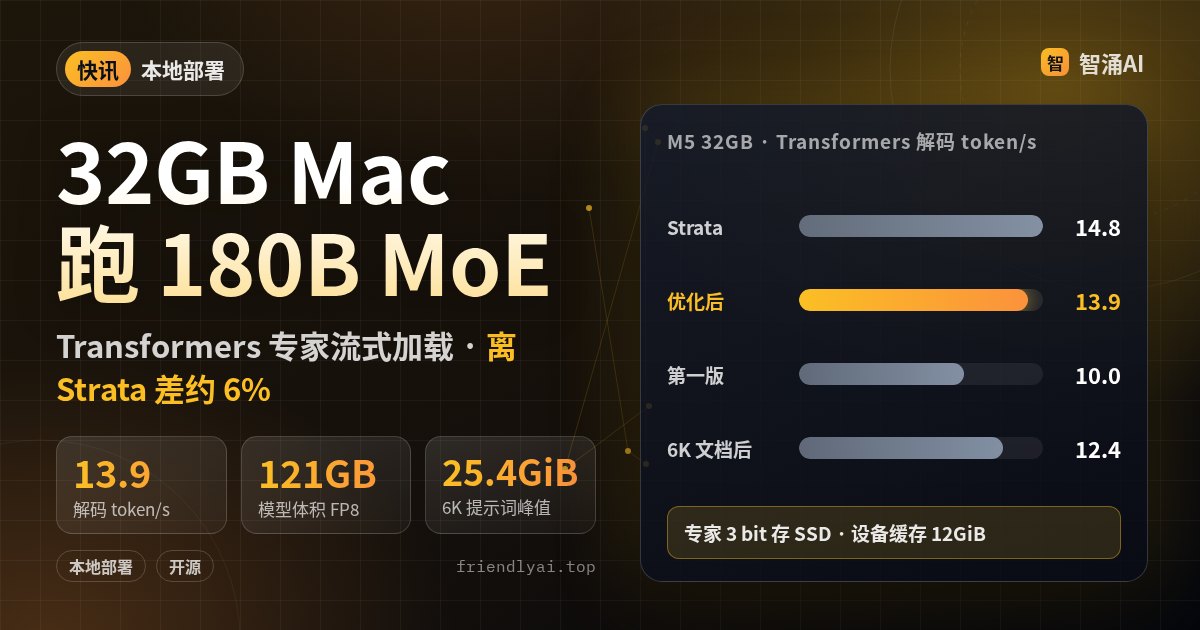
Hugging Face 工程师 Tarek Ziadé 在美国时间 11 月 18 日发文:给 Transformers 加了「专家流式加载」,在一台 32GB 统一内存的 MacBook M5 上跑起了约 180B 参数的 MoE 模型 Qwen3.8-Flash-Next,短文本生成每秒 13.9 个 token,离专门为此设计的推理引擎 Strata 只差约 6%。代码还在一个未合并的 PR 里,想在笔记本上跑超大 MoE 的人可以看看。
原来的卸载方式,对 MoE 几乎不可用
MoE 模型九成以上的权重在专家里,每个 token 只用其中少数几个。Transformers 原来走 Accelerate 卸载,按模块整块搬运:一层的全部专家每个 token 都要拷到 GPU,实际只用 8 到 10 个,没有缓存,也不看路由结果。
作者先在一张 24GB 显存的 A10G 上用 Qwen3.6-35B-A3B 对比了几种引擎的卸载方案,解码速度差距很大:
| 引擎与配置 | 解码(token/s) |
|---|---|
| Strata,Q8_0 | 82 - 88 |
llama.cpp,Q8_0,--fit on | 63 - 64 |
vLLM,FP8,--cpu-offload-gb 16 --cpu-offload-params experts | 20.1 |
| Transformers + Accelerate | 0.16 |
作者认为,专家放得进内存时 llama.cpp 很难超越;放不进时,就只能按路由结果去读需要的专家,并让瓶颈落在 SSD 上,而不是 Python。
做法:缓存槽位池,直接复用现成的专家算子
核心改动是把专家缓存做成一个「槽位池」:所有层共用一块预分配的设备张量,每层一张表记录专家编号对应哪个槽位。把路由输出的专家编号换成槽位编号,这块缓存在算子看来就是一组普通专家权重,Transformers 原有的 grouped_mm 可以直接跑。在小模型 OLMoE-1B-7B 上,这一步把速度从 10.1 提到 34.6 token/s,原生是 38.1。
要试得先从这个 PR 安装 Transformers:
pip install "git+https://github.com/huggingface/transformers.git@refs/pull/50717/head"没命中的专家由 8 个 I/O 线程读取,每个专家一次连续读;当前层计算时,提前用后两层的路由器猜要用哪些专家并预取。加载时在 from_pretrained 的 device_map 里把 "experts.*" 映射到 "disk",再用 experts_offload 给出缓存大小,文中示例给专家缓存分了 12GiB。
32GB Mac 上的账
Qwen3.8-Flash-Next 有 48 层,每层 512 个专家、激活 10 个,FP8 下 121GB,另有一张 51GB 的 n-gram 嵌入表。作者的拆法:专家量化到 3 bit,磁盘上 49GB;稠密层 8 bit,约 5.4GB,困惑度比 BF16 高 0.2%;n-gram 表留在磁盘上按行读。转换一次约 5 小时,6K 提示词时内存峰值 25.4GiB,作者说得关掉浏览器,不然 macOS 开始换页。
同一台 M5,第一版解码约 10 token/s,补上 GPU 提交时机、Metal 算子和预取后到了 13.9。
剩下约 6% 的差距主要来自每个 token 约 10 毫秒的主机往返:PyTorch 不提供逐层等待 GPU 事件的接口,Strata 能一次排好整个 token 的工作。作者也直说,约 14 token/s 对他用编程 Agent 来说还是太慢,日常仍用两张 RTX 4090 的台式机。
谁该关心
手上只有 32GB 级 Mac、又想本地跑放不进内存的 MoE 模型的人,可以去 Hugging Face Space「tarekziade/moe-expert-streaming」看完整设置和原始数据。这是一个概念验证 PR,API 形式可能会改,量化专家后续可能并入 #50245 的逐层量化方案,现在不适合放进生产代码。
最后
想自己试,先读 PR #50717 的讨论和 Space 里的测试设置,确认磁盘空间够放 49GB 的专家文件再开始转换。