vLLM 0.34:KV 缓存按实际显存分配
vLLM 在北京时间 11 月 19 日发布 v0.34.0,这一版有 412 位贡献者、1061 次提交,几项默认行为的改动会直接影响现有部署脚本。
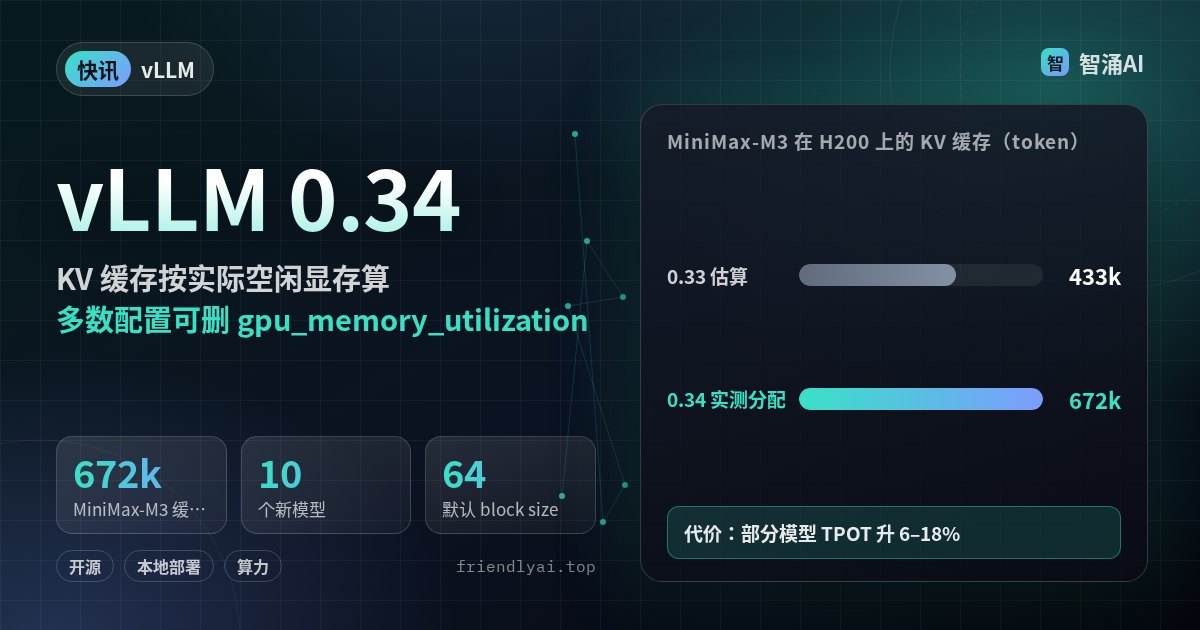
升级前要看「Before you upgrade」表:设了 VLLM_USE_V2_MODEL_RUNNER=0 的会启动失败;需要 huggingface_hub ≥ 2.0.0、tokenizers ≥ 0.23.3;ROCm 7.2 镜像不再发布,改用 ROCm 10.0;fp_quant 检查点不能再加载;Marlin W4A8 被移除。官方建议多数情况下不再设置 gpu_memory_utilization,要和其他进程共享显卡时才设。
性能方面,官方给出 Blackwell 和 MI355X 上的提升:GB200 上 Step5 解码最高快 1.95 倍,GLM-5.3-Flash 吞吐提升 1.6 倍。用 Docker 镜像部署的,换 tag 前先在测试机上跑一遍启动和压测,确认缓存大小和延迟符合预期。上一次大版本的升级要点见站内 vLLM 0.32。
注意:加速数字来自 vLLM 发布说明里的特定硬件和模型;更大的 KV 缓存在部分 H200 模型、并发 128 时会让每 token 解码延迟上升 6% 到 18%,可用 --no-enable-extensible-kv-cache 关闭。