ZONOS3-Mini 开源:1 亿激活参数实时克隆语音
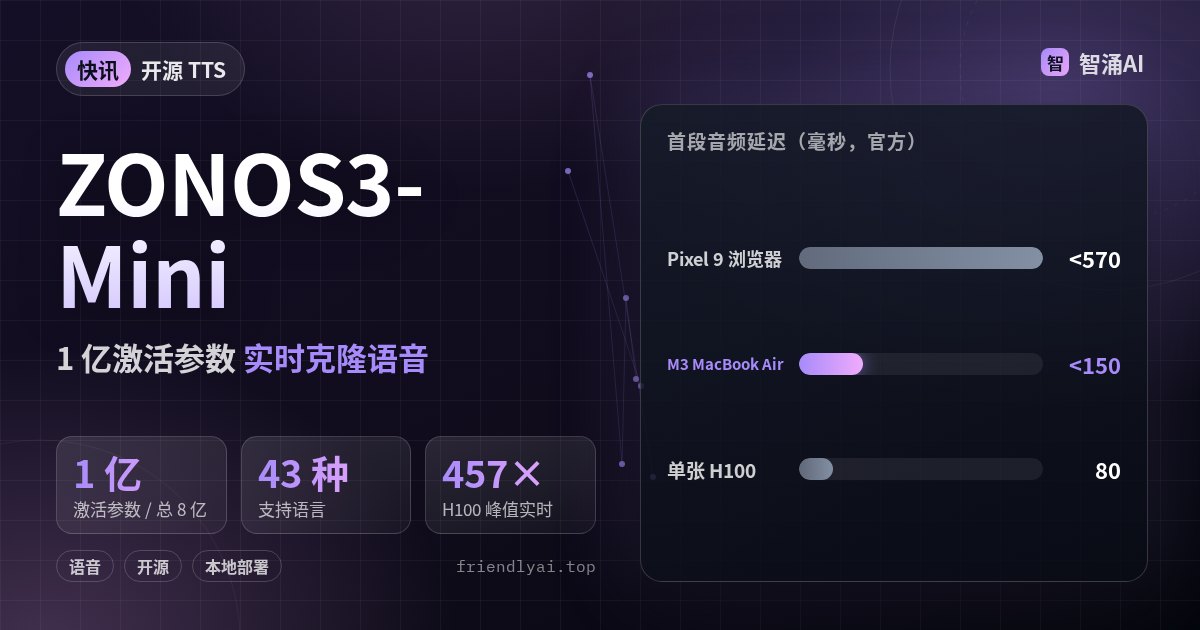
语音模型公司 Zyphra 11 月 12 日在 Hugging Face 发布 ZONOS3-Mini:一个支持零样本声音克隆的开源文本转语音(TTS)模型,激活参数只有 1 亿(总参数 8 亿),权重用 Apache 2.0 许可。官方给的数字是在 M3 MacBook Air 上首段音频延迟不到 150 毫秒,在 Pixel 9 手机的浏览器里不到 570 毫秒。做语音 Agent、想把 TTS 放到本地或端侧的开发者,可以直接拿来试。
小模型能跑实时,靠的是重做了音频编码
上一代 ZONOS2 用 8B 参数的主干去建模 86 Hz 的音频编码,质量好但很难放到本地。ZONOS3-Mini 换了三处:自研的 ZAC-1 编解码器把帧率降到 15 Hz(输出 44.1 kHz 音频),主干改成 Gated DeltaNet 与注意力混合的稀疏 MoE,说话人编码器换成 MECT-B2 声纹模型。帧率从 86 降到 15,意味着同样一秒语音,模型要生成的步数少了很多,我们估计这是它能在笔记本和手机上实时出声的主要原因。
Zyphra 称,在同样的数据条件下,用 ZAC-1 训练的 TTS 模型词错率比用 DAC 编码器低一个数量级(10 倍)。整个模型在 112 张 H100 上训练了 2.5 天。
| 项目 | ZONOS2 | ZONOS3-Mini |
|---|---|---|
| 主干参数 | 8B | 激活 1 亿 / 总 8 亿(MoE) |
| 音频编码帧率 | 86 Hz | 15 Hz(ZAC-1) |
| 端侧部署 | 受限 | 浏览器、手机、笔记本 |
官方给出的速度和质量数字
- 首段音频延迟(TTFA):Pixel 9 浏览器内 <570 毫秒,M3 MacBook Air <150 毫秒,单张 H100 在并发 8 时中位数 80 毫秒。
- 吞吐:单张 H100 最佳并发下峰值每秒生成 457 秒音频,也就是 457 倍实时。
- 质量:Zyphra 同时发布了评测集 ZTTS2-Eval,干净朗读语音覆盖 35 种语言,真实环境的声音克隆覆盖 20 种语言,再用 420 个评测项做综合能力指数。按这个指数,ZONOS3-Mini 在开源权重模型里排第一,领先 Fish S2 Pro 和 MOSS TTS v1.5。
对本地语音 Agent 来说,1 亿激活参数、笔记本上 150 毫秒内出声,TTS 这一步可以先放在本机试。
它还支持「激活引导」:不重新训练,直接调内部方向来控制说话方式,比如 projection 控制从轻声到隔空喊话,lively 控制从平淡到活泼。博客里给了对应的试听样例。
谁该关心,怎么试
在做语音助手、实时配音、端侧 Agent 的团队可以重点看,特别是之前因为成本或隐私只能用云端 TTS 的场景。截至 2026-11-13,Hugging Face 模型页显示约 8,543 次下载、227 个赞。
零安装的试法是在官方 Hugging Face Space 里直接试零样本克隆;想接到自己的服务里,官方给的起服务命令是:
sgl-omni serve --model-path Zyphra/ZONOS3-Mini --port 8000
curl -X POST http://localhost:8000/v1/audio/speech \
  -H "Content-Type: application/json" \
  -d '{"input": "Hello from ZONOS3-Mini on Hugging Face!"}' \
  --output output.wav
Mac 用户可以走 MLX,没有独显的机器可以用 C++/ggml 加载 GGUF 量化权重。站内也写过 Mistral 的语音 Agent 方案,可以对照 Voxtral 3 快讯。
注意:延迟、吞吐和排名都是 Zyphra 自报,基准也是它自己设计的。零样本克隆只要一段参考音频就能模仿一个人的声音,Zyphra 的发布博客没有写水印或使用限制,上线到产品里时,取得声音授权、标注合成语音这些事要自己做。
最后
手上有语音功能的,先用 Hugging Face Space 拿自己的中文参考音频试一段,听完再决定要不要本地部署。