KittenTTS 实测:CPU 半秒合成一段中文
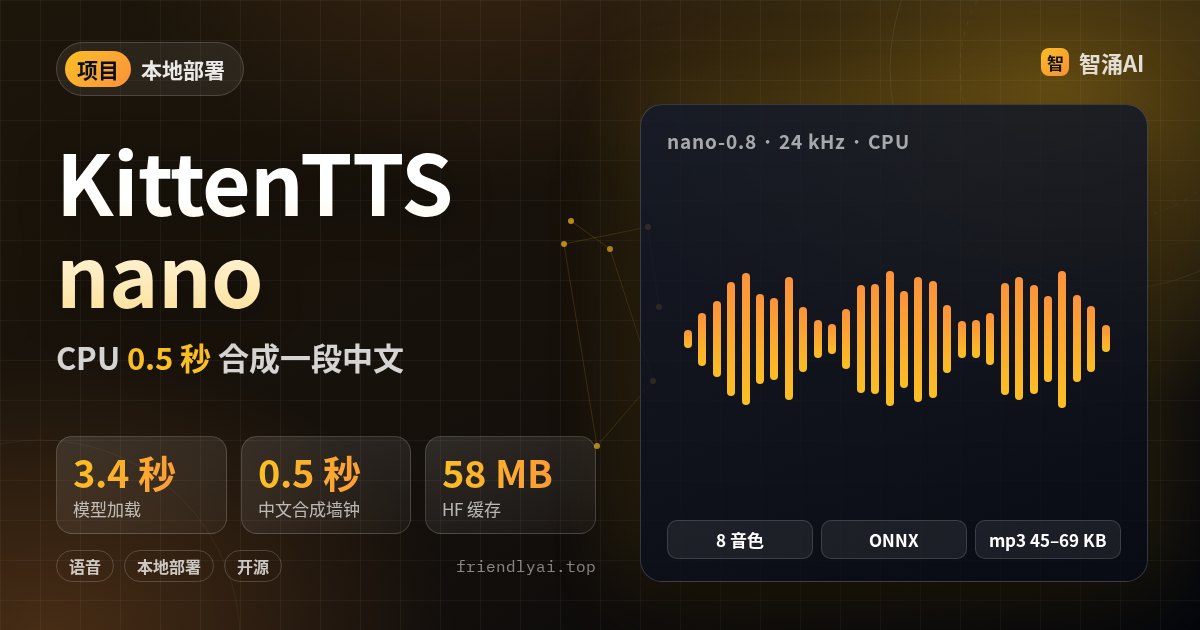
想在本机给 Agent 或脚本加一段语音,又不想申请云端 TTS 密钥时,KittenTTS 的轻量 ONNX 模型是一条路。我们 2026-10-27 在无显卡的 Debian 上装了 PyPI 包 kittenml 0.9.6,只拉 ONNX 依赖,用 nano-0.8(约 15M 参数)合成了中英文各一段,并压成网页可用的 MP3。
它是什么
KittenML 开源的文本转语音项目。一面是可在 CPU 跑的 ONNX 小模型(nano / micro / mini),一面是更大的 KittenTTS 2。本文只测能在普通服务器上几分钟装完的 nano。
| 仓库 | github.com/KittenML/KittenTTS(PyPI kittenml) |
|---|---|
| 作者 | KittenML |
| 许可证 | Apache-2.0 |
| 热度 | GitHub 16,514 星(截至 2026-10-27);PyPI 包版本 0.9.6(上传于 2026-10-21) |
| 语言 | Python ≥3.8;ONNX 路径需 onnxruntime 等,不必装 GPU / PyTorch |
| 最新版本 | kittenml 0.9.6;实测模型 KittenML/kitten-tts-nano-0.8 |
解决什么问题
云端 TTS 要账号、计费和网络;很多开源大模型又重到本机装不动。nano 这类 ONNX 模型把「读一句提示词 / 报一段状态」压到几十兆缓存和半秒级合成,适合脚本播报、本地 Agent 语音反馈,以及不方便出网的环境。别指望它当工作室配音;声音克隆我们这次也没测。
怎么用
python3 -m venv .venv && source .venv/bin/activate
pip install kittenml --no-deps
pip install onnxruntime espeakng_loader phonemizer soundfile numpy huggingface_hub

python3 - <<'PY'
from kittenml import KittenTTS
model = KittenTTS("KittenML/kitten-tts-nano-0.8")
print(model.available_voices)
model.generate_to_file("你好,这是本地 TTS。", "out.wav", voice="Jasper")
PY
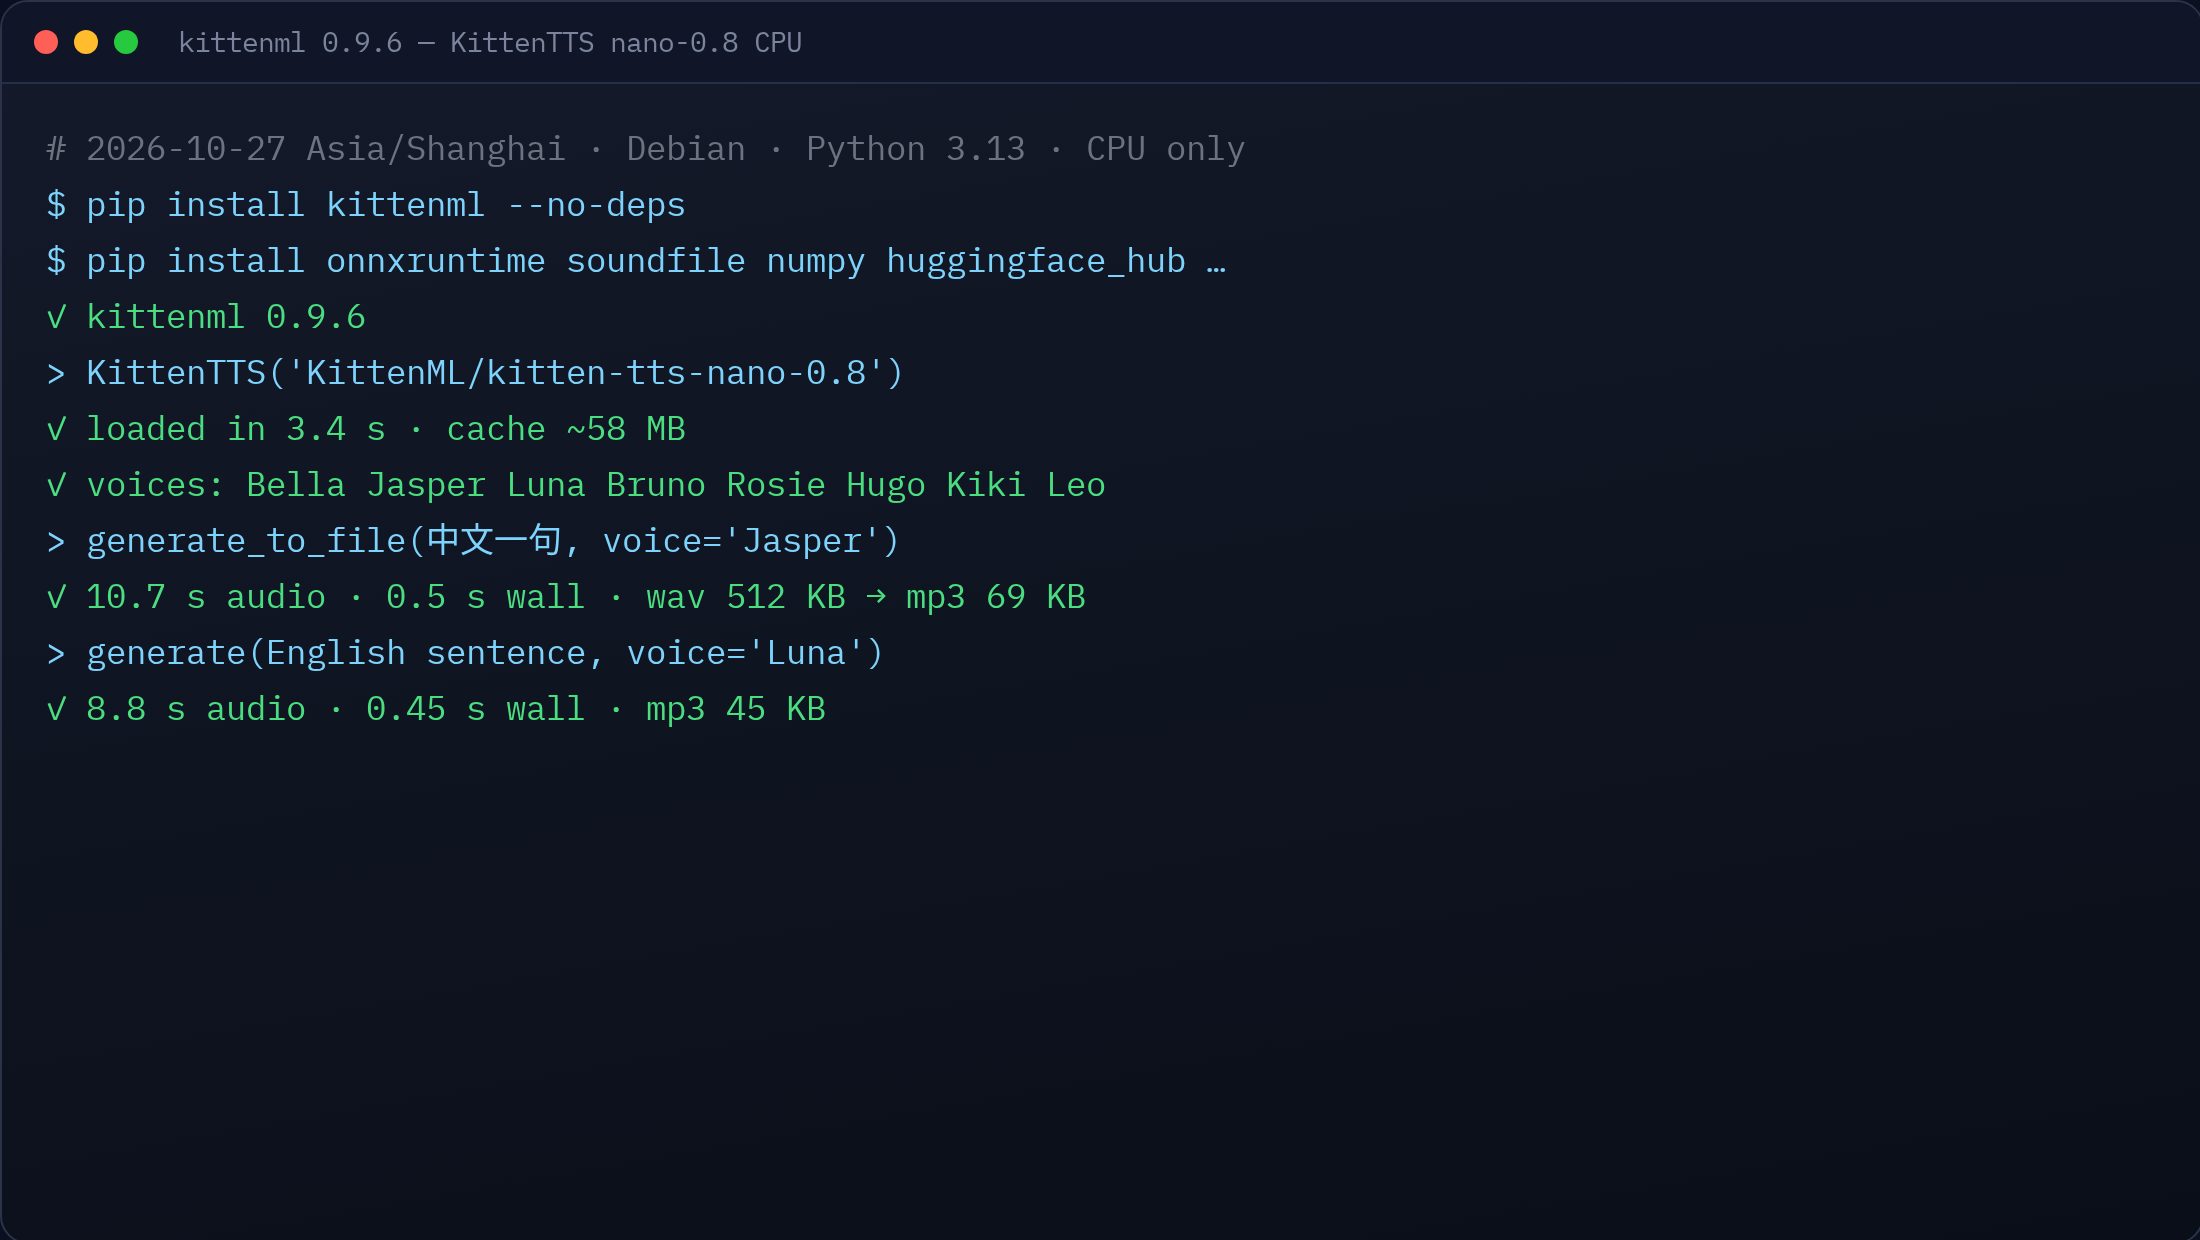
音色列表:Bella、Jasper、Luna、Bruno、Rosie、Hugo、Kiki、Leo。可用 speed 调语速。网页嵌入前建议用 ffmpeg 压成 MP3(我们实测 wav 约 500 KB,mp3 约 45–70 KB)。
实测
环境:2026-10-27 北京时间,Debian,Python 3.13.5,CPU,无 GPU,无 Hugging Face token(匿名下载,有速率提示)。
- 加载 nano-0.8:3.4 秒;缓存目录约 58 MB。
- 中文「你好,智涌AI。这是 Kitten TTS nano 在 CPU 上的实测。」音色 Jasper:墙钟 0.5 秒,音频约 10.7 秒,wav 512,044 字节 → mp3 约 69 KB。
- 英文一句,音色 Luna:墙钟 0.45 秒,音频 8.83 秒,mp3 约 45 KB。
未实测:KittenTTS 2(1.7B,需 PyTorch);5–30 秒音频克隆;情感 / 事件标签;CUDA 后端;mini/micro 对比听感。官方另有云端 API,我们未注册。
听感上,nano 能听懂,但偏合成腔:中文节奏还行,音色干净却不像真人录音;英文 Luna 也清楚。做状态播报、演示旁白够用;要做有声书或广告配音,建议换更大模型或云端。匿名拉 Hugging Face 时终端会提示未认证、限速更高——公司网络若拦 HF,需要先解决下载通道。
装依赖时注意:我们第一次若直接 pip install kittenml,会开始解析 torch≥2.6,体积和编译时间都上去。官方 ONNX 文档写明可用 --no-deps 再装 onnxruntime、phonemizer、soundfile 等。phonemizer 依赖 espeak,Debian 上 espeakng_loader 包会带上加载逻辑,我们没有额外 apt 安装 espeak 也能跑通本次两段合成。
输出采样率 24 kHz。写入 wav 后我们用 ffmpeg 的 libmp3lame 转 MP3,中文约 69 KB、英文约 45 KB,适合直接嵌进文章;站点规范要求图片约 ≤200 KB、视频更严,音频按体积控制在几十 KB 即可。
适合谁,不适合谁
适合:要在本机给 Agent、脚本或演示加短语音,且不想申请 TTS 云密钥的人。不适合:要多语种工作室级音质、稳定音色克隆,或必须离线且不能从 Hugging Face 拉模型的场景。更大一档可看官方 KittenTTS 2;只要 Agent 剪视频可看本站 ffmpeg-skill。