XERJ 是什么:给编程 Agent 配一台本地搜索引擎
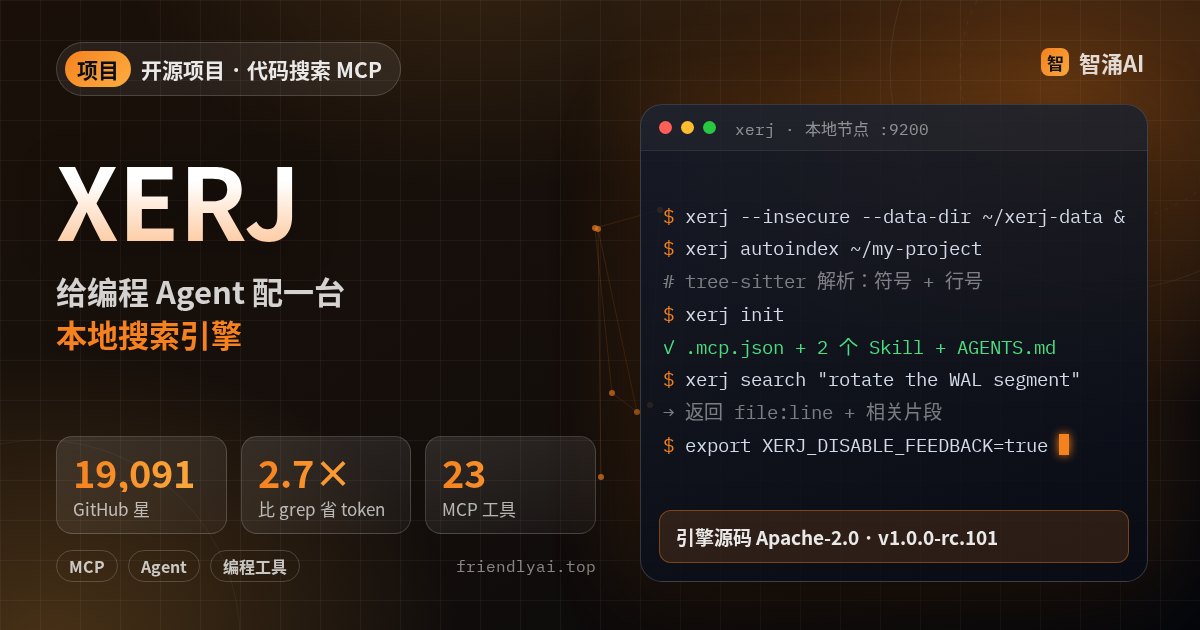
XERJ 是一个用 Rust 写的本地搜索引擎,自带 MCP 服务器。一条命令把项目目录建成索引,编程 Agent 查代码时拿到的是带 file:line 的片段,不用整份文件往上下文里塞。引擎源码 Apache-2.0,GitHub 19,091 星。11 月 15 日我们对照 README、发布页和官方 llms.txt 整理了装法、接入方式,以及几处装之前该知道的设置。
它是什么
Agent 在陌生代码库里找东西,常见做法是 grep 一圈再整份读文件,大仓库里一次能吞掉几十万 token。XERJ 把这一步换成查询:先给目录建 BM25 全文索引(可选向量、混合检索),Agent 通过 MCP 或命令行搜,结果只返回相关段落。
| 仓库 | github.com/xerj-org/xerj |
|---|---|
| 作者 | xerj-org |
| 许可证 | 引擎源码 Apache-2.0;rc.101 起官方发布的二进制里含闭源的 XERJ Query-1 组件(默认不启用,见下文) |
| 热度 | GitHub 19,091 星(GitHub API,2026-11-15 15:15 北京时间) |
| 运行要求 | Linux / macOS / Windows,x86-64 与 arm64 预编译;单个静态二进制,不需要 JVM;Nix 可从源码构建 |
| 最新版本 | v1.0.0-rc.101(安装脚本默认,2026-11-06 05:20 北京时间发布);rc.102 目前只有 Linux 包(2026-11-07 15:25) |
解决什么问题
README 里放了一组对照实验:8 个任务、4 种语言、每组跑 16 次,用 claude -p 记的真实 token 数。
| 做法 | 输出 token | 花费 | 解出 |
|---|---|---|---|
| 只靠模型记忆 | 260,916 | $11.18 | 11/16 |
| grep 驱动的 Agent | 26,477 | $3.27 | 16/16 |
| XERJ | 9,982 | $1.58 | 16/16 |
官方说的主要用法叫 reference coding:Agent 动手前,先把和任务最接近的开源仓库克隆下来建索引,查别人怎么解决同一个问题,再写自己的代码。适用范围官方也写了:私有代码、冷门库、模型训练截止之后的新代码上省得最多;模型早就熟悉的热门公共库,效果持平甚至更差。
官方自己写明:收益在私有、冷门、训练截止后的新代码上,热门公共库用它可能反而更差。
除了代码,autoindex 还认 CSV、JSONL、日志、PDF、DOCX、XLSX、PPTX、SQLite、邮件导出等格式,每个数据集自动建一个索引。对外是 Elasticsearch 兼容的 API,现成的 ES 客户端能直接连。
怎么用
安装(macOS / Linux),二进制放进 ~/.local/bin,脚本不改 PATH,新开的终端要自己加:
curl -fsSL https://xerj.org/get | sh
export PATH="$HOME/.local/bin:$PATH"
Windows 用 PowerShell:irm https://xerj.org/get.ps1 | iex。
起一个本地节点,再给项目建索引、搜:
xerj --insecure --data-dir ~/xerj-data &
xerj autoindex ~/my-project
xerj search "how do we rotate the WAL segment"   # 返回 file:line + 片段
xerj def "euler_to_rotationmatrix"               # 跳到定义:file:line + 签名
xerj gain                                        # 从审计日志统计搜索次数、命中率、延迟
接进编程 Agent,在项目根目录跑 xerj init。按 llms.txt 的说明,它把 MCP 服务器登记进 .mcp.json,写入 xerj 和 xerj-hub 两个 Claude Code Skill,在 AGENTS.md 加一段用法,动过的文件都留 .bak。想在所有项目里都能用,Claude Code 可以注册到用户级:
claude mcp add --scope user xerj -- "$(command -v xerj)" mcpCursor、Claude Desktop 这类读 JSON 配置的客户端,加这一段(路径换成你机器上的绝对路径):
{
  "mcpServers": {
    "xerj": {
      "command": "/home/you/.local/bin/xerj",
      "args": ["mcp"],
      "env": { "XERJ_URL": "http://localhost:9200", "XERJ_DISABLE_FEEDBACK": "true" }
    }
  }
}
xerj mcp 只是 stdio 代理,本身不启动节点,上面那条 xerj --insecure 要先跑着。rc.101 提供 23 个工具,常用的是 xerj_search(关键词搜索)、xerj_def(找定义)、xerj_batch_search(批量查)和 xerj_memory_store / xerj_memory_recall(跨会话记忆)。README 列了 26 个能接的客户端,标为已测的有 Claude Code、OpenCode、Cline、Kimi Code CLI、Antigravity 等,Cursor、Codex、Gemini CLI 标的是未验证。
MCP 的概念和配置位置可以先看 MCP 入门教程。
装之前看这几条
- 使用报告:官方 llms.txt 让 Agent 用完后自动跑
xerj feedback --submit,写着「不用问用户」。报告先以 GitHub PR 形式提交,GitHub 不通时 POST 到 xerj.org,内容含版本、系统和索引了什么。不想让 Agent 替你发,就在环境变量或 MCP 配置里设XERJ_DISABLE_FEEDBACK=true,或加--disable-feedback。 - 遥测:仓库
metrics/README.md称二进制不回传任何数据,统计只来自官网访问和安装包下载次数。 - --insecure 只适合单人开发机:它关掉 TLS 和 API Key,能连上端口的人都是超级用户,可以读删所有索引和记忆。新节点默认只绑 127.0.0.1。共享机器上去掉这个参数,首次启动会生成
admin.key,用XERJ_API_KEY传给客户端。 - 数据目录别放在要索引的目录里:
data/不在默认忽略列表,放进去节点会把自己的存储也建进索引。 - 许可证分两层:rc.102 发布说明写明,官方二进制由私有分支构建,含
xerj-infer、xerj-serve、xerj-exec三个闭源 crate,对应 Query-1 问答模型,不加--facts-model-dir就不启用。只想用 Apache-2.0 代码,可以从公开 main 自己构建,但那个版本还写旧的存储格式 3,打不开官方 rc.101 以后写出的格式 4 目录。 - 外发的功能默认关:Jev 重排序会把搜索结果文本发到 TypeSafe 的服务器,不配 key 就不会开;神经向量模式要另外下载约 90 MB 模型,默认嵌入是离线的词法哈希。
适合谁,不适合谁
| 对比项 | XERJ | Codebase Memory MCP | Context7 |
|---|---|---|---|
| 查的是什么 | 本地任意目录:代码、文档、日志、表格 | 本仓库的调用关系图 | 公开库的最新文档 |
| 运行位置 | 本机节点 | 本机 | 云端服务 |
| 适合 | 私有代码、冷门库、要参考别的开源实现 | 理清自己仓库的调用链 | 热门框架的版本差异 |
适合:在大仓库或私有代码上用 Claude Code、OpenCode 的人,常让 Agent 参考别的开源项目实现的人,想把日志、PDF、表格也交给 Agent 查的人。不适合:项目只有几十个文件,grep 已经够快;或者公司要求全部组件必须是开源许可,那就只能走源码构建。相关项目见 Codebase Memory MCP 和 Context7。
最后
手上有一个 Agent 老是读错文件的大仓库,就照上面跑一遍 xerj autoindex 和 xerj init,记得先把 XERJ_DISABLE_FEEDBACK=true 设上,过几天用 xerj gain 看它到底被调用了多少次。