Agent 评测集怎么搭:任务、协议和可信分数
团队想知道「换个模型、换套提示词,编程 Agent 到底变好了没有」,最后都得自己搭一套评测集。斯坦福 2026 秋季课程 CS329Z(Engineering AI Agents,由 Diyi Yang、Michael Ryan、John Yang 主讲)第 13 讲专门讲 Agent 评测基准怎么设计,第 12 讲讲数据怎么筛。下面把两讲的课件整理成一份能照着做的清单:任务怎么写、评测协议要定哪些参数、怎样的分数才可信。
Agent 评测和问答评测不是一回事
课件把基准分成三类来比。普通 LM 基准是「输入一道题,输出一个答案」;Agent 基准的输入是任务加一个环境,中间有多轮「动作—观察」交互,输出是一条轨迹外加一个被改动过的环境。所以给 Agent 打分,往往要看环境的最终状态,而不只看最后一句话。
| 基准 | 任务 | 怎么判分 |
|---|---|---|
| SWE-bench | 按 GitHub issue 改真实仓库 | 跑单元测试 |
| Tau-bench | 客服对话中调用工具 | 对比数据库最终状态 |
| Terminal-bench | 89 道难题,每题一个 Docker 环境 | 环境里的测试脚本 |
| VendingBench | 长期经营一台售货机 | 最终净资产 |
| AIRS-bench | 20 个机器学习研究任务 | 任务指标 |
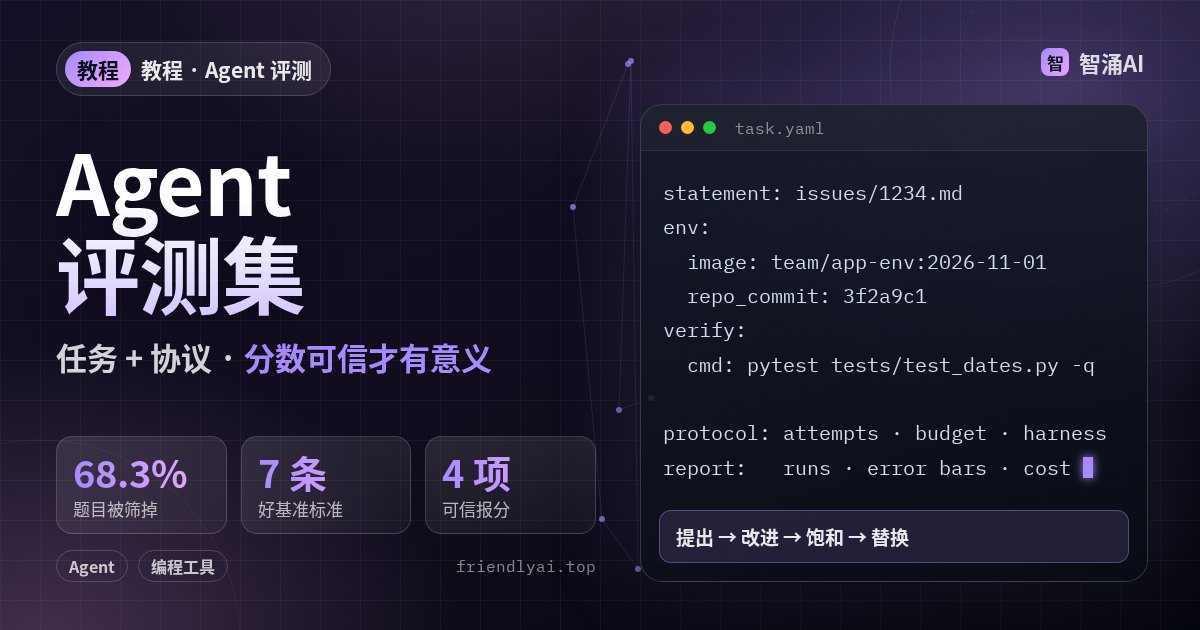
课件给的定义是:基准 = 任务表述 + 评测协议。前者回答「考什么」,后者回答「怎么考」。内部评测常常只写了前者,换个人跑,数就不一样。
第一步:每道题写清三件事
- 问题描述:Agent 拿到的输入,比如一段 issue、一句用户请求。要让有经验的人看完就知道该做什么。
- 环境:Agent 能操作的东西,比如一个固定 commit 的仓库、一个装好依赖的容器、一个模拟数据库。
- 验证:怎么判断做对了。能用测试、最终状态比对或精确匹配的,就别用模型打分。
下面是一个题目卡片的示例格式(字段是本文为说明而拟的,不是课件原文):
id: fix-date-parse-001
statement: issues/1234.md          # 问题描述
env:
  image: team/app-env:2026-11-01   # 固定镜像版本
  repo_commit: 3f2a9c1
verify:
  cmd: pytest tests/test_dates.py -q
  pass_if: exit_code == 0
第二步:把评测协议写死
同一批题,协议不同,分数就不能比。课件列的协议参数如下,建议逐项写进评测仓库的 README:
- 尝试次数:每题跑几次 rollout。
- 终止条件:最多几轮、多长时间、多少算力预算。
- 模型配置:推理强度、temperature。
- harness:用固定的 harness,还是允许各家自带。
- 工具与联网:能用哪些工具,能不能上网。
- 汇总方式:多次运行怎么合成一个分数,另外报哪些维度,比如成本、轮数、token。
分数只在协议相同的前提下才能比较;换了 harness 或预算,就是另一场考试。
harness 本身对结果影响很大,站内harness 复盘一文有具体例子。
第三步:筛题,别把坏题留在集子里
第 12 讲举了 SWE-bench 的例子:OpenAI 请 93 名 Python 开发者标注了 1,699 道随机抽取的 SWE-bench 题,每题 3 人标注、取最严重的标签。结果 38.3% 的问题描述不够明确,61.1% 的题被标为单元测试不公平(可能把正确解判错),合计 68.3% 的题被筛掉,剩下的就是 SWE-bench Verified。
课件总结的筛题顺序是四步:
- 去掉坏掉或不稳定的题。
- 实际跑一遍,确认题目有效。
- 留下模型「有时能做对」的题,全对和全错的都区分不出模型。
- 模型变强后重新挑题。
同一讲还提醒:在同等数量下,筛过的数据比随机抽的好;但更大的未筛数据集仍可能胜出。筛选在候选池有限时最有用,而真正带来泛化的是多样性。
第四步:用七条标准自检
| 标准 | 自检问题 |
|---|---|
| 有难度 | 当前最好的模型还没做满分吗? |
| 贴近真实 | 题目像真实工作里会遇到的吗? |
| 有区分度 | 强弱模型的分数拉得开吗? |
| 好跑 | 同事一个下午能跑起来吗?是否一个安装脚本、写明系统要求、配置能从命令行传? |
| 好验证 | 判分是确定的,不靠人看? |
| 可解释 | 分数变了,能说清是哪类题变了吗? |
| 耐用 | 半年后还不会被刷满吗? |
「好验证」这一条,课件专门列了用模型当裁判(LM-as-a-judge)的毛病:偏爱更长的回答、偏爱和自己风格相近的输出、可以被针对性刷分,换个提示词或换个裁判模型分数就变。主观质量确实要靠模型打分时,做法见客观与主观评审分开。
基准也有寿命。课件把它概括为「提出 → 改进 → 饱和 → 替换」,例子有 MMLU 到 MMLU-Pro(选项从 4 个加到 10 个)再到 GPQA、HLE,SWE-bench Verified 到 Multilingual、Pro,τ-bench 到 τ²-bench。自己的评测集一旦接近满分,就该进入下一轮。
第五步:报一个可信的分数
- 公平:和对比对象用同样的脚手架、预算、设置、尝试次数和联网条件;做不到就写明差在哪。
- 可复现:固定模型快照、harness、数据集和镜像版本。
- 透明:报运行次数、误差范围、成本和排除了哪些题。课件的例子是 70% 对 67%,落在误差范围内,成本却是 3 倍,这种「领先」没有意义。
- 诚实:不在测试集上调参,不从 10 次运行里挑最好的一次当 pass@1,报的是哪个系统就交付哪个系统。课件举了 2015 年 ImageNet 比赛一支队伍因过多次向测试集提交而被取消资格的例子。
课件引的是古德哈特定律:指标一旦成了目标,就不再是好指标。
常见坑
- 只报一次运行的分数:Agent 每次轨迹都不一样,单次结果差 2–3 个点很正常,至少跑多次并给误差范围。
- 环境不固定:镜像、依赖、仓库 commit 没锁住,下个月同一题的结果就变了。
- 测试本身有错:SWE-bench 的教训是六成题目的测试被标为不公平,自己的题也要先人工复核一遍判分脚本。
- 边调边测:拿评测集调提示词,分数会越来越好看,真实效果不变。留一份不碰的保留集。
完成标准
- 每道题都有问题描述、固定版本的环境和确定的验证命令。
- README 写明了第二步的全部协议参数。
- 新同事按 README 一个下午能跑完一轮。
- 报告里有运行次数、误差范围、成本和排除题目清单。
最后
先从团队最近 20 个真实工单里挑题,按第一步写成题目卡片,跑一轮再按第三步筛掉坏题。课程主页和全部课件见下方来源。