Replit Missions 怎么用:先签约定,再放 Agent 干活
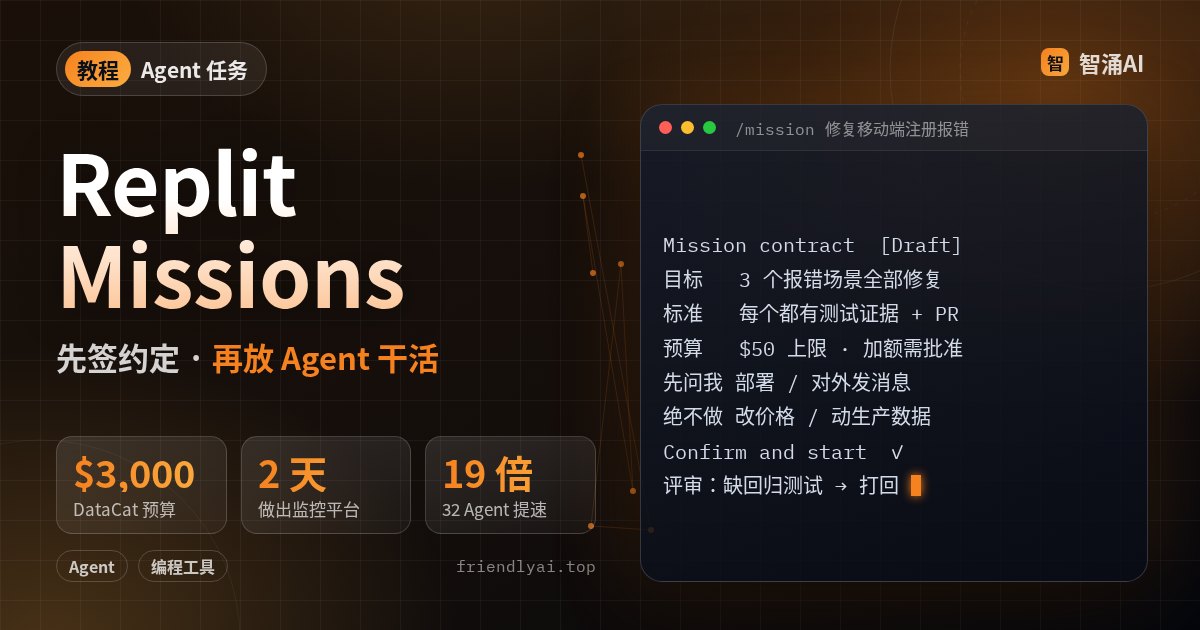
Replit 美国时间 11 月 17 日上线了 Missions:给一个聊天绑定一个长期目标,开工前先和 Replit 把做法、完成标准、预算上限和禁止动作写成一份「Mission contract」,然后由一群 Agent 在云端并行去做,最后由另一个 AI 评审按标准验收。它和平时一句提示词就开干的区别全在这份约定上。下面按官方文档讲清怎么开、约定怎么写、哪些地方文档自己提醒过别误会。
Missions 和普通对话差在哪
文档的定义很简短:一个 mission 给聊天一个持续存在的目标。开始前你和 Replit 约定四样东西:做法(怎么推进)、成功标准(什么算做完)、预算(这次最多花多少 Replit AI 用量,按美元算)、边界(哪些动作要先问你、哪些绝不能做)。目标会跨轮次、跨会话一直挂在这个聊天上,等你回复或等定时任务恢复时也不会丢。
| 对比项 | 普通 Agent 对话 | Mission |
|---|---|---|
| 开工前 | 一句提示词 | 多轮提问后形成一份约定,确认后才启动 |
| 花费 | 按用量走 | 预先设美元上限,任务期间你发的消息也算进去 |
| 谁说做完了 | Agent 自己 | 独立的 AI 评审按成功标准验收,可打回 |
| 执行方式 | 单个 Agent | 一群 Agent 并行,可关电脑等进度通知 |
前置条件
- 一个 Replit 账号和可用的 AI 用量额度,任务期间的花费都从这里扣。
- 一件边界清楚、能用证据验收的工作。文档给的例子是「修掉客户报告的 25 个问题,逐个测试,总结还需要关注的地方」。
- 想清楚哪些动作必须你点头,比如对外发消息、改价格、部署上线。
分步:从开任务到验收
1. 发起并选规划深度
在聊天里让 Replit 开一个 mission,或者直接输入 /mission 加目标。先选规划深度:Only the essentials 问得少、很快出约定;Work through the details 会逐阶段追问。第一次用建议选后者,能看清每一项是怎么定下来的。
2. Understand 和 Approach
Understand 阶段讲清要做成什么、为什么、手上已有什么,Replit 据此划定范围。Approach 阶段它会给几种推进方式,你挑一个或自己写。
3. Success:写可检查的结果
这是最关键的一步。文档原话是选能对着结果检查的标准,别只列要做的活动。可以照这个格式写:
目标:注册页移动端报错可复现的问题全部修掉
成功标准:
- 3 个已知报错场景都能复现,并在修复后通过自动化测试
- 每个问题给出根因说明和对应 PR
- 回归测试套件全部通过
不算完成:只改了代码但没有测试证据
官方博客举的销售任务例子也一样:「拿下 10 个付费企业客户」之前,会追问付费试点算不算、年合同有没有最低金额,答案决定 Agent 先跟哪些客户、怎么算进度。
4. Boundaries:预算和红线
设美元预算上限、选这次用的模型,再列两张清单:要先问你的动作、绝不能做的动作。博客的例子是预算封顶 1,000 美元,联系潜在客户、发方案、改对外销售材料、做产品承诺之前都要审批。这些限制在做法调整后依然有效。产品页还写明,提高预算上限需要你单独批准。
5. 审约定,确认开工
侧边栏里的 Mission contract 汇总了目标、做法、成功标准、预算和边界。哪里不对就让 Replit 改,满意后点 Confirm and start。标着 Draft 的约定还没激活。
6. 跟进度、验收
规划时可以选通知内容(卡点、进度、整体状态)和频率(即时、每日汇总或每周)。任务需要决定、审批或连接某个服务时会来找你。Replit 尝试收尾时,自动评审会拿现有证据对照成功标准,要么接受,要么把剩下的工作列出来打回。通过后聊天里显示 Mission complete,可打开 Mission report 看结果。预算先花完的话,工作停止,目标保持未完成。
约定写得越含糊,钱烧得越快;成功标准写成可检查的证据,评审才有东西可对。
官方案例里的数字怎么看
Replit 用 Missions 给自己做了一个应用监控平台 DataCat:2 天、3,000 美元预算内做出仪表盘、告警和链路追踪。人为注入一个数据库 bug,告警在 38 秒内触发,目标是 60 秒;3 小时压测写入 2,600 万条活动记录和 440 万条日志,无数据丢失。他们还用同一句初始提示词在 Claude Code 里用 /goal 做了一版对比,DataCat 在追踪数据写入上是每秒 49,000 条对 9,800 条。性能优化场景里,13 个 NumPy 基准任务上,Auto (Max) 模式单 Agent 最高提速 4 倍,16 个 Agent 并行到 17 倍,32 个到 19 倍。
这些都是 Replit 自己的受控测试,博客也注明对比构建每种配置只跑了一次、只比了双方都有的功能。拿来判断「并行 Agent 加明确验收标准能走多远」有参考价值,别当成你项目的预期。DataCat 已经开源了可自托管的版本。
常见坑
- 以为预算是硬上限。文档写明,已经在跑的工作可能让花费略超预算才停下;预算也不保证任务能在这个数内完成。
- 以为清除任务就停了。Clear a mission 只移除目标,不会取消后台进程,也不会撤销已经做过的动作。要停,得明确让 Replit 找出并停止正在进行的工作,再检查它回报里有没有停不掉的操作。
- 把评审通过当成正确。文档原话:自动完成不保证结果正确或符合预期。交付物还是要你对照成功标准过一遍,没达到的告诉 Replit。
- 边改需求边口头说。目标、标准、权限、预算变了要明说,并重新查看更新后的约定,否则评审还按旧标准验收。
完成标准
- 约定里每条成功标准都对应一种可提交的证据(测试结果、PR、截图、指标)。
- 对外发消息、部署、改价格、加预算都在「先问我」清单里。
- 收到 Mission complete 后,你按约定亲自核过一遍交付物。
同类「给目标不给任务」的做法,站内还写过 Codex 与 OpenCode 的 /goal 目标模式 和 Devin Bots,可以对照着选。
最后
挑一件手头拖了很久、能用测试验收的小活,设一个你能接受全部花掉的预算,开第一个 mission,重点看评审打回了什么。