Agent 出码快 11 倍后,Shopify 怎么做移动端安全审查
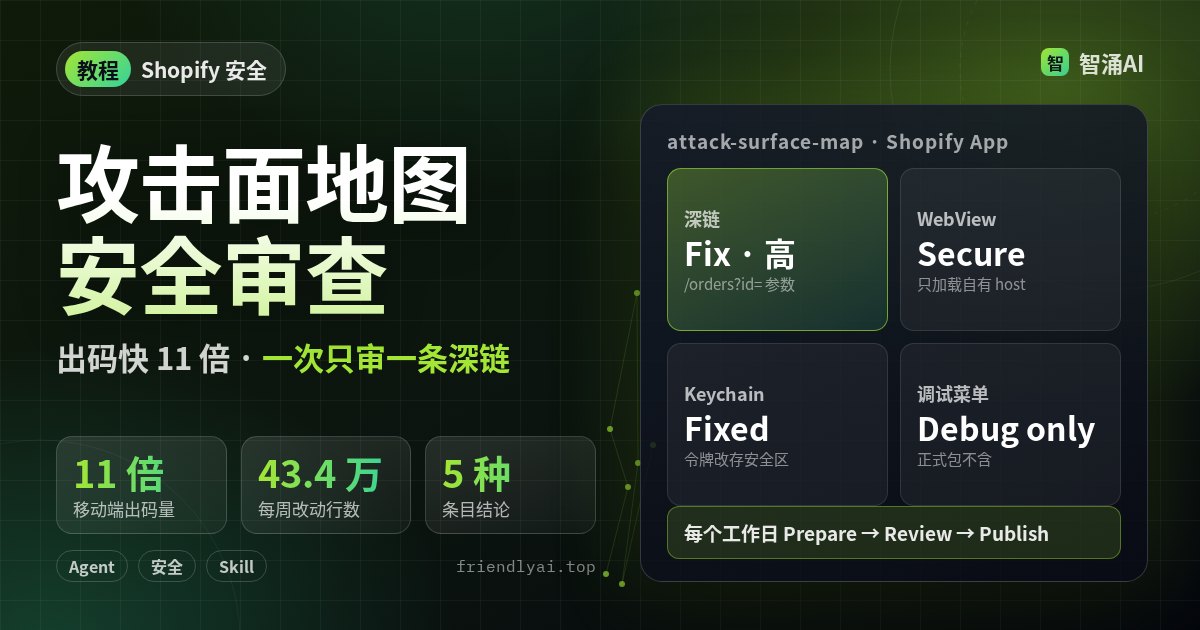
Shopify 工程博客美国时间 11 月 18 日写了他们移动端的安全做法:Agent 参与开发后,移动应用的出码量是去年同期的 11 倍,12 周重写 Shopify App 期间平均每周改动约 43.4 万行,去年同期大约 3.9 万行。人工审查跟不上,他们给每个 App 维护一张「攻击面地图」,把安全知识写成 Skills,再让模型每个工作日只审变动过的那几项。下面把这套流程拆开,配一份可以照着搭的骨架。
问题出在「让模型审整个 App」
博客里有一句很实在的话:让模型去找整个 App 的漏洞,得到的是一张又长又含糊的清单。Shopify 原本就有扫描改动代码的漏洞扫描器(他们叫 Dispatch),这套地图要补的是另一件事:看清每个 App 整体暴露了什么,暴露面一变就知道,并且拿过去踩过的坑逐项对照。
| 做法 | 一次看多少 | 输出 |
|---|---|---|
| 整 App 交给模型审 | 全部代码 | 长而含糊的可疑点列表 |
| 漏洞扫描(Dispatch) | 本次改动的代码 | 找到并证明的漏洞 |
| 攻击面地图 + 逐项审 | 一个条目及它碰到的代码 | 每项一个五选一结论,能逐条核对 |
前置条件
- 一个移动端仓库(iOS / Android / 跨端都行),Agent 能只读访问。
- 一个能定时跑的 Agent 环境,支持加载 Skills,工具权限能限制成只读。
- 团队过去的安全事件、漏洞赏金报告,哪怕只有几条。
- OWASP 的移动应用安全标准 MASVS 和测试指南 MASTG,作为第一版检查项的来源。
第一步:给每个 App 建一张攻击面地图
地图按攻击面分组:深链、WebView、存储的数据、权限、依赖等。每个攻击面先写一两句「为什么要紧」,下面每个条目都带一个结论和一个指向来源代码的链接。结论只允许五种:
- Fix:要修,并标严重程度;
- Tradeoff:有风险但权衡后接受;
- Secure:确认安全;
- Fixed:已修复;
- Debug only:只存在于调试构建。
结论收窄到五种,好处是后续每天的变更页可以直接比对,不用再读一段段自由发挥的分析。
第二步:每个攻击面写成一个 Skill
地图由一组 Skill 生成,一个攻击面一个。Shopify 从 MASVS 和 MASTG 起步,再加上移动应用被报告过的漏洞,包括他们自己的。每个 Skill 写三件事:要列出什么、好的样子是什么、要检查什么。写成 Skill 的好处是不绑定某个工具:定时审查用它,临时做一次安全评审也用它,任何在这个仓库干活的 Agent 都能加载。学到新东西就改 Skill,之后每一次运行都自动带上。
下面是按这个思路整理的深链 Skill 骨架(结构是本文整理的示例,内容要换成你们自己的规范):
---
name: deeplink-surface
description: 盘点并审查 App 的所有深链路由与参数
---
## 要列出什么
- 每个深链路由(scheme / universal link / app link)
- 每个路由读取的每个参数,以及读取它的代码位置

## 好的样子
- 参数一律当不可信输入:校验类型、长度、允许的 scheme 和 host
- 授权回调用 PKCE,敏感数据不放进深链

## 检查什么
- 参数能否让 WebView 加载任意 URL 或 javascript: / data: 内容
- 参数能否绕过登录态直接打开敏感页面
- 历史事件类别:(每次修完事件把类别补在这里)

## 输出
每个条目:路由 | 结论(Fix+严重度/Tradeoff/Secure/Fixed/Debug only) | 代码链接 | 理由
Skill 本身怎么写、怎么校验,站内有一篇 10 分钟写出第一个 Agent Skill 可以对照。
第三步:先盘点,再一次只审一项
每个 Skill 先做完整盘点:所有深链路由和它读的每个参数、所有 WebView 和它加载的 host、每个 WebView 的 JavaScript 接口方法、每个 Keychain / Keystore 条目、每个依赖和版本。然后模型逐项审,每次只带上这一项碰到的代码。拿深链来说,就是看一个路由、它读的每个参数、读参数的那几段代码,问一句「这个参数是恶意的会怎样」。这样得出的答案足够具体,可以验证。要判断能不能真的被利用时,再交给专门的网络安全模型。
问题越小,模型给的答案越能核对;一次只看一条深链,比一次看整个 App 有用得多。
第四步:每个工作日审一次变更
Shopify 每个工作日用最新的前沿模型过一遍当天的改动,分三段:
- Prepare:在最新提交上重新盘点,和上一版已确认的地图比较。只有被引用的代码行改了,或者盘点报告某项有变化,这一项才算「变更」。
- Review:模型逐个判断变更和新增的条目,只给只读工具,只看代码。第二遍再通读改动过的文件,找没有任何条目覆盖到的安全相关改动。每个回答用之前都要检查:格式、行号范围、措辞,以及里面有没有带出密钥。
- Publish:生成新地图和一页「本次变化」,摘要发到 Slack。变化页列出上次运行以来每一处安全相关改动和对应结论。
仓库外的问题也要盯:依赖和平台不断披露新漏洞,Agent 定期读安全资讯,拿每条对照地图和代码,只在真正影响到自家 App 时才提醒团队。同一套 Skill 也用来评估准备引入的第三方库,让依赖拿到和自家代码一样的地图和结论。
常见坑
- 审查时给了写权限。Review 阶段只给只读工具和代码,模型就没机会顺手「修」出新问题,也没机会碰到不该碰的东西。
- 模型输出直接入库。Shopify 会先校验格式、行号是否落在真实范围、措辞,以及有没有泄露密钥。行号对不上的结论,后面每天的比对都会跟着错。
- 变更判定太宽。如果「文件改了就重审」,每天都是全量。用「被引用的行改了」做判定,审查量才跟得上每周几十万行的改动。
- 修完事件不回写。每处理一次安全事件或赏金报告,先修 bug,再把这一类问题加进对应 Skill,否则下次同类问题还要靠运气。
完成标准
- 每个 App 有一份地图,所有条目都有五选一结论和代码链接。
- 每个攻击面有一个 Skill,写明要列什么、好的样子、要查什么。
- 定时任务每个工作日产出一页变化清单,发到团队频道。
- 最近一次安全事件的类别已经写进了对应 Skill。
同一家公司另一个思路是让 Agent 主动攻击生产环境、用裁判 Agent 兜底,见站内的 Shopify Cyber Chaos Monkey 拆解;两者一个守暴露面,一个找可利用的漏洞,可以搭配着看。
最后
先从深链这一个攻击面开始:让 Agent 列出全部路由和参数,逐条给结论,跑满一周再加 WebView 和存储。