Agent 浏览器工具怎么选:通过率相近,成本差 13 倍
给 Agent 接浏览器,最常见的选择是 Playwright MCP、各家云浏览器的 MCP,或者 Stagehand、agent-browser 这类专门给 Agent 用的工具。LangChain 在 2026-11-03 发了一篇评测,用同一个模型、同一批 100 个网页任务比了 7 套浏览器工具:通过率都在 78% 到 90% 之间,花的钱却差了 13 倍。下面按 LangChain 官方博客和文档(2026-11-04 北京时间查阅),讲清差距出在哪,以及选型和接入时该看什么。
通过率差不多,账单差 13 倍
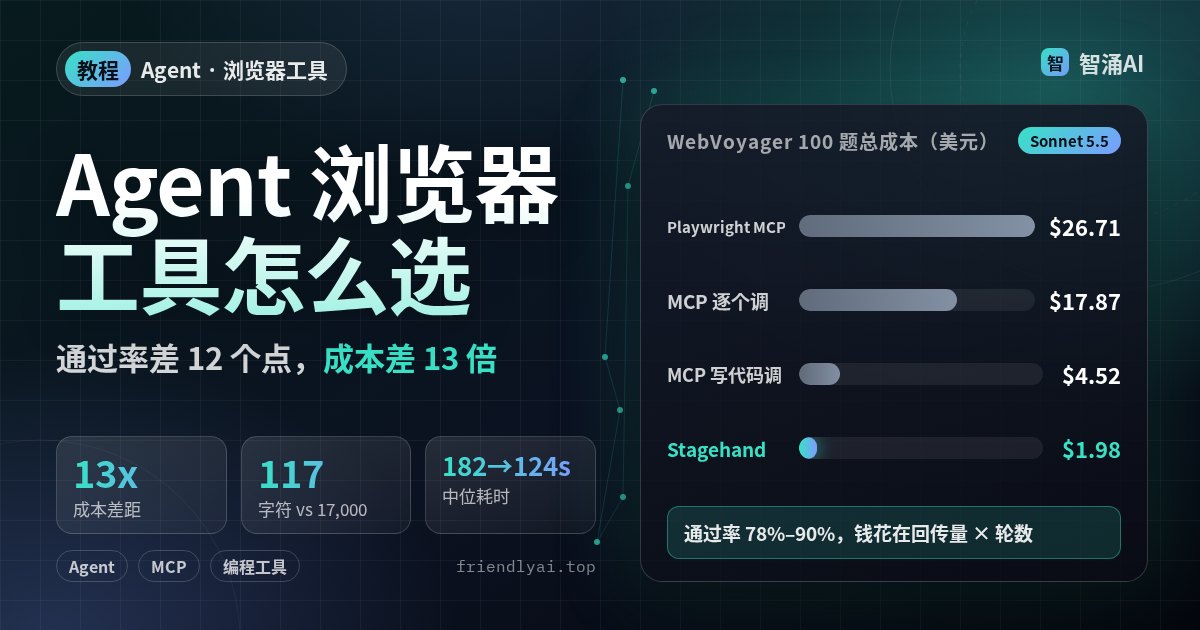
评测用的是 WebVoyager 的 100 个任务,模型统一为 Claude Sonnet 5.5。7 套工具的通过率落在 78% 到 90%。Stagehand 工具通过率最高(90%),100 个任务总共花了 1.98 美元,单任务中位耗时 17.4 秒。Playwright MCP 通过 78%,花了 26.71 美元,约是前者的 13 倍,单任务耗时也是它的 3 倍。
| 指标 | Stagehand | 对照 |
|---|---|---|
| WebVoyager 通过率 / 总成本 | 90% / 1.98 美元 | Playwright MCP:78% / 26.71 美元 |
| 平均每任务步数 | 10 步 | Playwright MCP:26 轮 |
| 一次页面导航回传 | 中位 117 字符 | Browserbase 托管 MCP:中位约 17,000 字符 |
| HardBench 38 个核心任务 | 通过 30 个(写代码的 run) | 命令式 browse CLI:通过 21 个 |
这些是 LangChain 在自己的评测集上测的,Stagehand 又是他们推荐的方案,换成你的任务数字会变。差距的方向和原因值得参考。
钱花在哪:回传内容和轮数
每次工具调用的返回值都会进模型上下文。一次导航回来 17,000 字符的页面,和回来 117 字符的摘要,乘上几十轮,token 账单就拉开了。轮数是第二个乘数:每多一轮,模型就要把前面的上下文再读一遍。
浏览器工具省不省钱,看两件事:每次回传多少,一共走几轮。
评测里另有两条发现:
- 事后截断没用。把快照硬截到 8,000 字符,Agent 只会再去抓一次页面。精简得在工具源头做,只返回可交互元素和与任务相关的文本。
- 截图不便宜。截图中位 89 KB 一张,模型还得自己看图理解。能用无障碍树文本完成的步骤,别默认截图。
让 Agent 写代码,少走几轮
把一串点击、输入合并成一次执行,是降轮数最直接的办法。评测里,把 Browserbase 的 MCP 工具改成在解释器里用代码批量调用,成本降了 4 倍(17.87 美元到 4.52 美元)。Stagehand 的 run 工具本身就接受代码,支持 Playwright 风格的 page、context、browser 对象。思路和站内讲过的 Code Mode 一样。
代码风格也有讲究。LangChain 试过让 run 改收 Stagehand 原生 API,通过率反而少 5.3 个百分点,每个通过任务的成本高 19%。模型对 Playwright 写法更熟,换成它没见过的 API 就容易写错。
等待也很费时间。Agent 写的 sleep(8) 大部分时间在空等。LangChain 把 run 改成页面安静 500 毫秒就结束等待,不超过 Agent 要求的时长,一次 8 秒的等待 0.6 秒就返回了。配合其他改动,HardBench 上的中位耗时从 182 秒降到 124 秒,准确率在误差范围内。
用 Stagehand 给 Deep Agents 接浏览器
LangChain 文档给的最小接法如下(要求 Python 3.11+、LangChain 1.4.7+、Stagehand 4.3.0+):
pip install langchain-stagehand deepagents langchain-openai
export OPENAI_API_KEY="..."
export BROWSERBASE_API_KEY="..."
然后用 StagehandMiddleware 把一个配好的 Stagehand 客户端挂到 Agent 上:
from deepagents import create_deep_agent
from langchain_stagehand import StagehandMiddleware

agent = create_deep_agent(
    model=...,
    middleware=[StagehandMiddleware(stagehand=stagehand)],
)
Agent 会拿到三个工具:snapshot 读当前页的无障碍树并给可交互元素编号,run 批量执行点击、填写或一段 JS,screenshot 截图。不用另起 MCP 服务器,也不用写浏览器系统提示词。
浏览器放哪也要选。本机或沙箱里的 Chrome 能访问 localhost,适合测自己的应用;Browserbase 这类云浏览器和你的机器隔离,要 API Key,但访问不了你本机的 localhost。托管版 Managed Deep Agents 用 define_browser 声明浏览器,scope 可选按线程或按用户保留会话。
登录这一步,交给人做
浏览器任务最常卡在登录页。把账号密码写进提示词,密码就会出现在模型消息、调用记录里,也会发到模型服务商那边。Managed Deep Agents 的做法是给 Agent 一个 browser_handoff 工具:遇到登录页,Agent 调用它并写明原因,比如「请登录某某网站,我再继续」。你在 LangSmith Studio 里拿到同一个浏览器,自己登录后点 Hand back,Agent 接着往下做。
会话范围决定登录态留多久。scope="thread" 是默认值,每个对话都从一个干净的浏览器窗口开始,不带别的对话留下的 cookie。scope="user" 让同一个用户的多个对话共享 cookie,登录一次,后面的对话都能用;每个对话仍有自己的窗口,不会互相抢着点。浏览器闲置超过 idle_ttl_seconds(默认 600 秒)就会停掉,不为没人用的浏览器付钱。
已经在用 Playwright MCP 怎么办
不一定要换。文档里 Playwright MCP 和 Vercel Labs 的 agent-browser 都列为可选方案。想省 token,可以从这几处下手:
- 让 Agent 优先读快照文本,截图只在需要看布局时用。
- 能写成一段脚本的连续操作,让 Agent 一次执行完,别一步一调。
- 把固定的
sleep改成等待具体元素或网络空闲。 - 按任务统计步数和 token,找出回传最大的那几个调用。
常见坑
- 只看通过率。7 套工具通过率差 12 个百分点,成本却差 13 倍,选型要把单任务成本和耗时一起算。
- 云浏览器测本地应用。远程浏览器访问不了你本机的 localhost,端到端测试要用本机或沙箱里的 Chrome。
- 把密码交给 Agent。登录让人来做,用 handoff 或手动登录后再交回,密码别进提示词。
- 元素编号跨页面用。Stagehand 的元素 ID 只对当前页最新一次快照有效,导航后要重新
snapshot。
完成标准
- 拿 10 个你自己的典型网页任务,记下通过数、总 token 和单任务耗时。
- 知道哪个工具调用回传最大,并已在源头精简。
- 本地应用测试用的是能访问 localhost 的浏览器。
最后
先别急着换工具。挑 10 个常跑的网页任务,把步数和 token 记下来,看钱是花在回传上还是轮数上,再决定改写法还是换工具。想了解浏览器 Agent 的基本原理,看本站的 Computer Use 入门。