Claude Code /advisor 怎么用:Sonnet 干活、Opus 把关
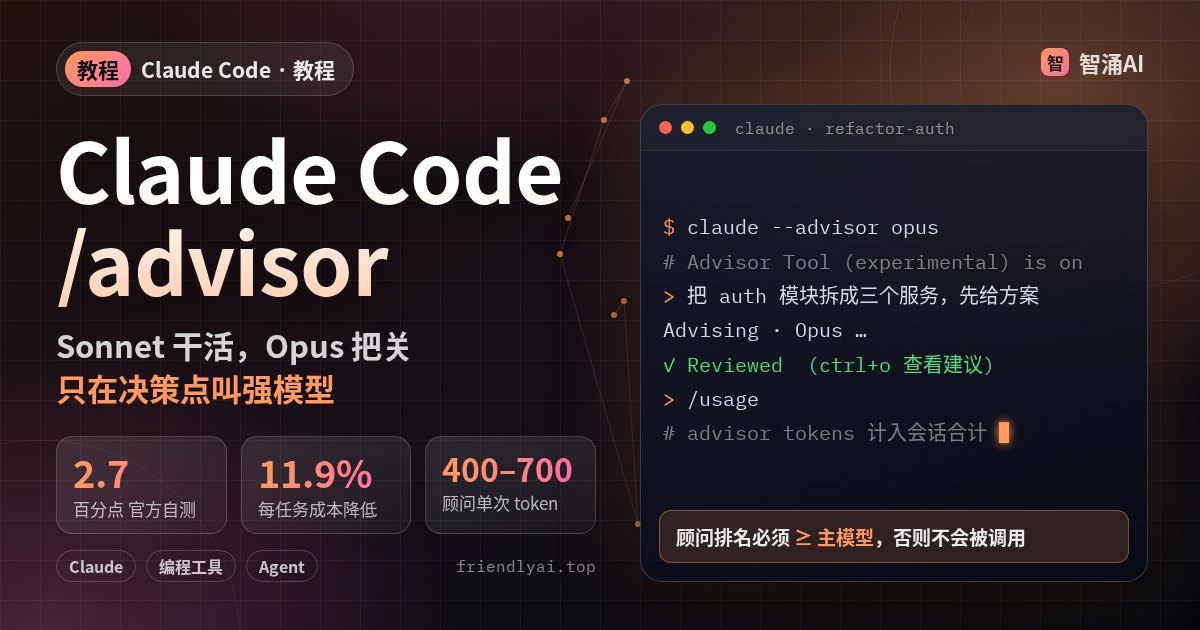
用 Claude Code 跑长任务,很多人的做法是全程开 Opus:贵,额度也掉得快。Claude Code 现在有个实验功能叫 advisor(顾问工具):主模型照常用 Sonnet 或 Haiku 干活,到了定方案、同一个错反复出现、准备说「做完了」这几个节点,它自己去问一个更强的模型,拿到建议再继续。这篇按 Claude Code 官方文档和 Anthropic 的发布博客,讲怎么打开、怎么搭配模型、钱怎么算,以及几个会让 advisor 悄悄失效的情况。
它和换模型、opusplan、子 Agent 不一样
advisor 在 Anthropic 那边是一个服务端工具。顾问模型拿到的是完整对话,包括每次工具调用和结果,但它自己不调工具、不直接回复你,只给主模型一段指导。什么时候去问由主模型决定,文档说它倾向于在三个时刻调用:动手前定方案、一个错误反复出现、宣布完成之前。
官方文档给了一张对比表,按「强模型什么时候上场」来区分:
| 做法 | 强模型何时参与 | 谁来触发 |
|---|---|---|
| advisor | 任务中途的决策点 | 主模型需要时自己调用 |
| opusplan | 计划模式里用 Opus,执行切回 Sonnet | 你进入计划模式 |
| 子 Agent 指定 model | 整个被委派的子任务 | 主模型委派或你手动调用 |
| /model | 从下一次请求起一直用 | 你手动切换 |
文档建议的适用场景是长、多步、大部分步骤很常规但方案质量决定成败的任务:大重构、反复出同一个错的调试、希望完工前有人独立复核的活。短任务没什么可规划的,或者每一步都需要最强模型的,直接换主模型更合适。
前置条件
- 走 Anthropic API、Claude Platform on AWS 或 Claude Models on Google Cloud(Anthropic 托管)。Amazon Bedrock、Google Cloud Agent Platform、Microsoft Foundry 上没有这个功能;后两种 Anthropic 托管渠道要 Claude Code v2.1.300 及以上。
- 主模型是 Fable、Opus 4.6 及以上、Sonnet 4.6 及以上、Haiku 4.5 或 Haiku 5.5。
- 订阅账号和 API 计费账号都能用。功能标着 experimental,行为、价格和可用范围都可能调整。
第一步:三种打开方式
会话里直接敲命令,选择会写进用户设置,以后每次都生效:
/advisor            # 不带参数,弹出可选模型列表
/advisor opus       # 直接指定,返回 Advisor set to …
/advisor off        # 关掉
不想开会话就改配置,写进 ~/.claude/settings.json:
{
  "advisorModel": "opus"
}
只想这一次用,启动时加参数,不改已保存的设置:
claude --advisor opus可填的值是 fable、opus、sonnet 三个别名,会解析成当前 Claude Code 版本的默认型号;也可以写完整 ID,例如 claude-opus-5-5。开启后会话里会提示 Advisor Tool (experimental) is on and may use more tokens。在 -p 非交互模式、Agent SDK、桌面端和 Remote Control 里没有选择列表,要带参数用,这需要 v2.1.260 及以上。
第二步:选一对合适的搭配
顾问的排名要等于或高于主模型。文档列了完整对照,挑几行常用的:
| 主模型 | 可选顾问 |
|---|---|
| Sonnet 5.5 | Fable、Opus 5 及以上、Sonnet 5.5 |
| Opus 5 / Opus 5.5 | Fable、Opus 5 及以上 |
| Haiku 4.5 | Fable、Opus、Sonnet、Haiku 5.5 |
| Fable 5.2 | 只能 Fable 5.2 |
官方推荐的几种组合,按花钱多少排:
- Haiku 主 + Opus 顾问:主模型最便宜,规划交给 Opus。比只用 Haiku 贵,比把主模型换成 Sonnet 或 Opus 便宜。
- Sonnet 主 + Sonnet 顾问:便宜的第二意见,抓常规疏漏。
- Sonnet 主 + Opus 顾问:最常见的一对,日常活 Sonnet 干,定方案、查疑难失败、完工复核交给 Opus。
- Opus 主 + Opus 顾问:第二个 Opus 复核第一个,适合独立检查比成本更重要的任务。
Haiku 4.5 能当主模型调用顾问,但不能当顾问。子 Agent 会继承你配置的顾问,再按它自己的模型重新做一次搭配检查。
顾问只在决策点被叫来,主模型用便宜的、顾问用贵的,通常比全程开贵模型省。
第三步:在提示词里点名,或者让它自己决定
调用时机由模型决定,没有设置能限制或强制次数。想让它多问,就在提示词里写,例如 consult the advisor before you continue;想少问也一样靠提示词。
调用时对话里会出现一行 Advising 加顾问模型名,结束后有三种结果:Reviewed(已审阅,有可读建议时按 Ctrl+O 展开)、Declined(顾问拒绝给建议)、Unavailable(调用失败,后面跟错误码)。主模型一般照建议做,但如果建议的步骤试了失败、或文件内容和建议对不上,它会把冲突摆出来,不会硬照着做。
钱怎么算
每次调用,顾问都要读一遍对话,按顾问模型的价格计费,叠加在主模型用量之上。API 计费按顾问模型的输入输出单价付;订阅用户算进套餐额度,Fable 当顾问时在部分套餐里走 usage credits。/usage 里的会话合计包含顾问用量。
缓存上,会话中途开关 /advisor 不会让主模型的提示缓存失效,这和切换模型不同;但顾问自己读对话没有缓存,每次调用都从头处理整段记录。对话越长,单次顾问调用越贵。
Anthropic 在发布博客里给过自家评测:Sonnet 4.6 配 Opus 4.6 顾问,SWE-bench Multilingual 比 Sonnet 单跑高 2.7 个百分点,每个任务成本低 11.9%;BrowseComp 上 Haiku 4.5 配 Opus 顾问得分 41.2%,单跑是 19.7%。顾问每次通常只输出 400–700 个文本 token 的计划。这些是厂商自测数字,换成你的任务要自己对比。
常见坑
- 开了但从没被调用:先看搭配。顾问排名低于主模型时,Claude Code 不会挂上它,会在
/advisor输出和通知里提示。如果 API 拒绝了搭配,Claude Code 会去掉顾问重发请求,你看不到报错,也不会有顾问调用;这之后换的新顾问要/clear或/compact后才生效。 - 关了遥测导致没有功能开关:除两个 Anthropic 托管云渠道外,advisor 依赖从 Anthropic 拉取的功能开关。设置了
DISABLE_TELEMETRY这类关闭拉取的变量,会话就拿不到这个开关。 - 走 LLM 网关:用
ANTHROPIC_BASE_URL接网关时,能不能用取决于网关是否把请求原样转发到 Anthropic API。网关或上游不认这个工具时,Claude Code 按文档里「自动重试与错误转发」的规则处理。 - 组织白名单:
availableModels没放行的模型,保存成顾问也不会被调用。 - Fable 当顾问要先同意计费:部分套餐需要先跑一次
/model fable接受 usage credits 计费,之前/advisor fable不会保存。 - 想彻底禁用:设
CLAUDE_CODE_DISABLE_ADVISOR_TOOL=1,/advisor命令消失,advisorModel被忽略。
完成标准
- 启动会话能看到 advisor 已开启的提示,
/advisor显示的是你想要的顾问。 - 跑一个多步任务,对话里出现过
Advising行,结果是 Reviewed,Ctrl+O能看到建议内容。 - 任务结束后
/usage里能看到顾问用量,和你平时全程用强模型的花费对比过一次。
最后
如果你现在全程开 Opus 只是为了「关键时刻别出错」,可以拿一个真实的重构任务试试 Sonnet 主 + Opus 顾问,对比一次 /usage。还没调过推理强度的,先看站内的 Claude Code effort 档位教程,换顾问和调 effort 可以一起用。