编程 Agent 花钱值不值:LangSmith 算出每个 PR 成本
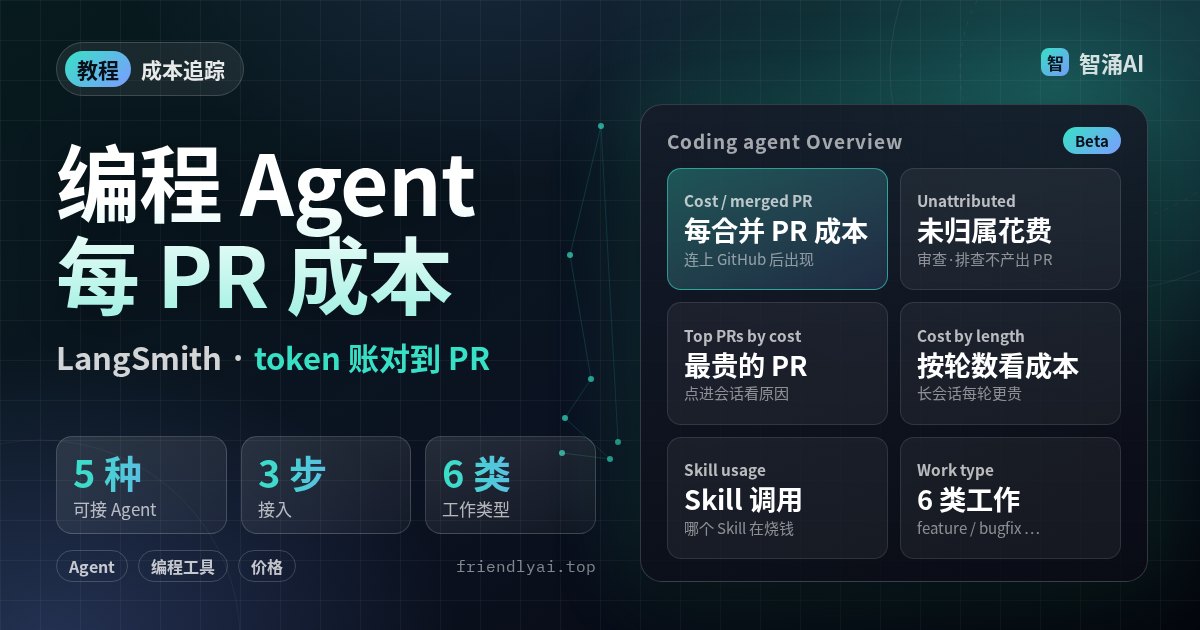
团队里有人用 Claude Code,有人用 Codex、Cursor,月底账单一出来,没人说得清这些 token 换来了什么。LangChain 11 月 18 日把 LangSmith 的编程 Agent 看板推到公开测试:把各家 Agent 的会话追踪汇到一处,再和 GitHub/GitLab 的 PR 关联,直接算出「每个合并 PR 花了多少钱」。这篇按官方博客和文档,把接入步骤、看板怎么读、怎么拿数据改团队习惯讲一遍。
前置条件:确认你的工作区类型
- 一个 LangSmith Cloud 账号。文档写明编程 Agent 类型还在 Beta,需要「基于 Agent 的工作区」,自托管版 LangSmith 用不了。
- 编程 Agent 的追踪计入你正常的 LangSmith 追踪用量。
- Claude Code 插件在 Windows 和 Linux 上需要 Node.js 20 及以上,macOS 自带构建不需要。
- 连 GitHub 时要有在仓库上安装 GitHub App 的权限,组织可能要求管理员审批。
第一步:给每个编程 Agent 装追踪插件
官方支持五种:Claude Code、OpenAI Codex、Cursor、VS Code 里的 GitHub Copilot,以及自建 Agent 用的 Deep Agents。以 Claude Code 为例,在会话里运行三条命令:
/plugin marketplace add langchain-ai/langsmith-claude-code-plugins
/plugin install langsmith-tracing@langsmith-claude-code-plugins
/reload-plugins
然后用 LangSmith CLI 登录一次:
langsmith auth login追踪默认是关的,要在 ~/.claude/langsmith.json 里打开,并指定发往哪个 Agent:
{ "enabled": true, "agent_id": "shared-claude" }如果这个 agent_id 还不存在,用官方插件发过去的追踪会自动创建一个类型为 Coding 的 Agent。发一条消息后,运行 /langsmith-tracing:trace 能拿到当前对话的追踪链接。
文档建议把团队所有编程 Agent 都发到同一个 LangSmith Agent,这样能跑同一套评估器,再按 harness(Claude Code、Codex 等)分组对比。要覆盖每位工程师,管理员可以用 MDM 统一安装 Claude Code、Codex、Cursor 插件,并锁定追踪目的地。
第二步:连上 GitHub 或 GitLab
在 Agent 的 Overview 页点 Track pull requests,连接 GitHub 或 GitLab 账号。对应规则有三条,搞清楚能省很多「为什么这个 PR 没数据」的排查:
- GitHub/GitLab 报告 PR 有动静(打开、更新、合并)时,LangSmith 才去关联。
- 关联的是那些追踪里记录了该 PR 仓库和源分支的会话。Claude Code 插件会给碰到 Git 仓库内文件的工具调用打上仓库、分支、提交和作者标签。
- 连接之前已经合并的 PR 不会出现,数据从连上那天开始积累。
一个会话开出多个 PR、一个 PR 由多个会话完成,两种情况官方博客都写明会正确归属。
第三步:读懂看板上的几张卡
| 卡片 | 看什么 |
|---|---|
| LLM cost / Threads / Turns per thread | 总花费、会话数、每个会话平均几轮,始终显示 |
| Cost / merged PR、Cache rate、Time to merge | 连上代码仓库后出现,合并率显示在 Time to merge 里 |
| Cost per PR by state | 打开、关闭、已合并 PR 各自的平均成本 |
| Top PRs by cost | 最贵的 PR,带作者、会话数、轮数 |
| Cost by conversation length | 按轮数分组的总成本和每轮成本 |
| Work type | 按 feature、bugfix、refactor、investigation、review、off topic 分类,需要先配内置的 Coding Work Type 评估器 |
| Skill usage | Agent 调用了哪些 Skill |
每张卡都能点开看趋势,按 PR 状态、用户、仓库、harness、模型等维度分组,再点进具体会话。
没有落到任何 PR 上的花费单独算作「未归属」。读代码、审查、排查问题经常不产出 PR,这部分钱未必浪费,点进去看会话内容再判断。
每合并 PR 成本给财务看单价,未归属花费给工程看去向。两个数要放在一起读。
第四步:拿数据改三个习惯
长对话该不该拆。每多一轮,模型都要把之前的对话再带一遍,所以长会话的每轮成本更高。官方博客提到,花费会集中在很长的会话里,而 Anthropic 的 Claude Code 成本指南也建议任务之间清空上下文。先在团队里推「一个任务一个会话」,过一两周看 Cost by conversation length,长会话占比有没有下来。
换模型值不值。换模型前后按模型分组看成本,再看同一时段 Time to merge 卡里的合并率。成本降了、合并率没掉,才算换对。把子 Agent 换成比主 Agent 小的模型也能这样验证省了多少。
哪个 Skill 在烧钱。某个 Skill 老出现在又长又贵的会话里,可能是它的指令让 Agent 多绕了几轮,改写它是最快的尝试;反过来,常出现在短会话且最后合并的 Skill,值得推给更多人。新 Skill 可以先给几个人用,再对比用和不用的会话成本与合并 PR 数。
Top PRs by cost 也能用来带人:同类活别人花得少很多,点开会话看是用了更合适的模型,还是没让会话无限拉长。
常见坑
- 克隆来的仓库改了你的追踪目的地。文档专门警告:项目里的
.claude/langsmith.json或langsmith-plugins.json能覆盖你的设置,陌生仓库可以借此打开追踪,把你的对话发到别人的服务器。信任一个仓库前,连同.claude/settings.json一起看一遍。 - 追踪内容比你想的多。插件上传每次模型调用带的对话和回复、模型名、token 数,以及工具调用的输入输出。代码和对话会进 LangSmith,上线前先过一遍公司的数据政策。
- 登录过期就断档。登录失效或密钥被拒期间的对话不会补传,Claude Code 会在聊天里提醒;管理员可以要求每次提示前都必须有有效登录。
- PR 下面没有会话。多半是追踪没记录仓库和分支。Copilot 只在 Local harness、且文件夹有 Git remote 时才记录;子 Agent 要跑完才上传,中途取消就丢了。
完成标准
- 团队用的每种编程 Agent 都装了插件,追踪发到同一个 Coding 类型的 Agent。
- GitHub/GitLab 已连接,新开的 PR 能在 Top PRs by cost 里看到对应会话。
- Work type 评估器已配置,未归属花费能按类型解释。
- 定下一项要验证的改动(拆长会话、换模型或改某个 Skill),记下改动前的每合并 PR 成本作基线。
只想先在个人层面省 token,可以看 TokenEconomizer 和 Agent harness 成本与规则放哪。
最后
官方建议从一个 Agent、一个仓库开始,第一批会话进来后就能看到按 PR 拆开的花费,先跑一周再决定要不要全员铺开。