Claude Code 团队怎么验 AI 写的码:verify Skill 与提交闸门
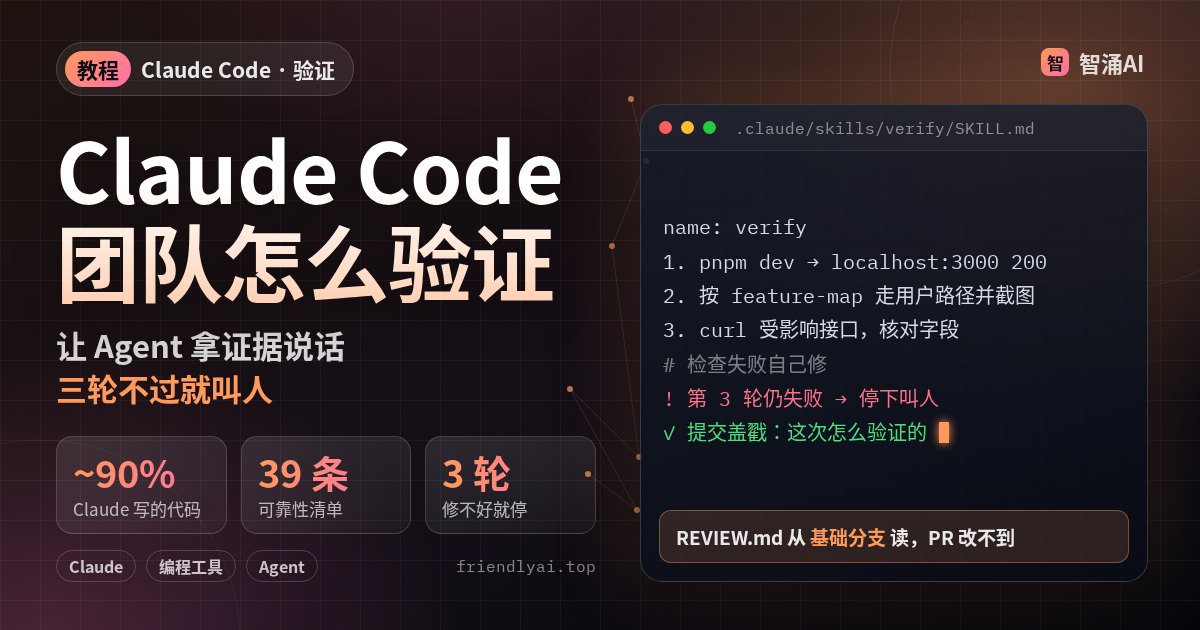
Claude Code 团队说,他们约 90% 的代码由 Claude 编写并审查。代码写得再快,人一个个看 diff 也看不过来,所以真正决定能并行开多少个 Agent 的,是验证。11 月 16 日 claude.dev 博客发了一篇长文,讲这个团队怎么让 Agent 拿出证据证明改对了。这篇挑出能直接搬到自己仓库的做法:三类值得投入的测试、一个叫 verify 的 Skill、提交闸门,以及怎么把漏掉的 bug 变成规则。
为什么验证决定并行上限
文章的说法很直接:没有验证闭环,你只能同时开一两个 Claude,因为每样都得自己检查;有了闭环,可以开几十上百个。他们在结构化文件生成的内部测试里,加一个独立的评分者按评分表检查,任务成功率最多提高 10 个百分点,越难的题提升越大。
另一个变化是验证变便宜了。测试、基准、规格说明、真实的端到端运行,以前费人工,现在可以让 Agent 生成;生成以后就是普通软件,反复跑也不额外花多少 token。
三类测试,各抓一类问题
| 类型 | 做法 | 适合 |
|---|---|---|
| 端到端测试 | 按真实用户流程走一遍:加购物车、结账、到确认页 | 首选。要么整个功能能用,要么不能,很难糊弄 |
| 属性测试 | 写一条「不可能失败」的断言,用 fast-check、Hypothesis、proptest 生成成千上万个输入去推翻它 | 人和 Agent 都容易漏的边缘情况;规格已经跟不上线上行为的重写 |
| 差分测试 | 新旧系统喂同样的输入,比输出 | 行为应该保持不变的大规模迁移 |
属性测试常见的几条断言:编码再解码得到原值;余额永远不为负;迁移、重试做两遍和做一遍效果相同;优化后的代码和朴素实现结果一致。差分测试的输入要随机生成或取生产流量样本,空白之类无关差异先归一化,确实该不同的地方列一张白名单。
两个要避开的坑:测试不稳定,Agent 学会的是重跑而不是修代码;测试太慢,Agent 就少跑,问题出在哪个批次很难定位。重的测试放在提交之前跑。
单元测试可能报「30 秒超时」,端到端测试能给你一张截图,说明哪里坏了。
第一步:写一个 verify Skill
团队的原则是「验证就是把改动跑起来」,比测试本身更重要。网页改动让 Claude 用 Chrome 扩展去点,移动端用 iOS 或 Android 的 MCP,桌面用 computer use,后端就在本地把服务起起来。
怎么启动模拟器、怎么把应用跑起来,写进一个叫 verify 的 Skill,放在仓库的 .claude/skills/ 里,离相关代码越近越好,需要几个就放几个。按文章说法,Claude 会在提交前用它。下面是一个骨架示例,命令换成你项目自己的:
.claude/skills/verify/SKILL.md
---
name: verify
description: 提交前把改动跑起来做冒烟测试。改了 web/ 下的页面或 api/ 下的接口时使用。
---
1. 启动:pnpm dev,等 http://localhost:3000 返回 200
2. 冒烟:按 docs/feature-map.md 里受影响的用户路径点一遍,每条路径截图
3. 接口:curl 受影响的接口,核对状态码和关键字段
4. 汇报:列出跑了哪些路径、结果、截图路径;有失败就修,三轮不过停下说明
写完以后让 Claude 自己反复跑、压力测试它。这是你的冒烟测试工具,要又快又稳。文章提到的「功能清单」(从用户视角列出路径、快捷键、选择器和预期结果)可以同时当 Agent 的导航和评分表。
第二步:把闸门装在 Agent 改不到的地方
- 便宜的检查先跑。开 PR 之前,Claude 先跑测试、构建和 lint。官方最佳实践文档给了两种强制办法:一个 Stop hook,脚本以退出码 2 结束时把 Claude 打回去继续干;或者用
/goal设定「测试全过」这类条件,由另一个模型每轮检查。写法见站内 Claude Code Hooks 护栏教程。 - 改动不能改自己的检查。Code Review 读的 REVIEW.md 来自基础分支,不读 PR 里的版本。规则放在改动碰不到的分支上。
- 审查只认具体提交。审查进行中又有人推了新提交,结果就作废。
- 一个审查者,多轮迭代。与其再叠一个更贵的审查者,不如调好主审查者,用 REVIEW.md 写清这块代码该看什么;每一轮带上前几轮的上下文和历史失败,别每次从头查。最佳实践文档里的
/code-review会在一个没看过对话的新子 Agent 里审 diff,不受写代码时那套推理影响。
第三步:新闸门先观察再强制
团队给每个提交盖一个「怎么验证的」戳,连「none」也盖,方便查出哪些提交没验证。另有一个提交闸门:会话里没跑过 /code-review 或 /verify 就拦下提交,分关闭、观察、强制三档。观察模式只记录本该拦住的提交,用来排查误报。强制模式下,提交说明里可以写明为什么没验证;同一会话被拦两次后,第三次放行,免得 Claude 卡死。
还有一份 39 条的可靠性清单,每条都有一个能从 diff 里看出来的触发条件、一项检查,以及背后的事故或 PR。例如会话存储或消息类型改了,就要问新字段在旧记录里缺失时能不能安全加载。Claude 读 diff,只查触发了的那几条,通常 3 到 10 条,没人需要背历史事故。
第四步:漏掉的 bug 变成规则
两条路:一是从人工审查意见和回滚的 PR 里提炼模式,至少在两个 PR 里出现过、能从 diff 识别,才算候选规则,然后让三个 Agent 试着推翻它,最后人在 PR 里批准。二是拿已知事故对应的 PR,让三个找 bug 的 Agent 重放,至少两个找到就算「可发现」;小 diff 上还漏掉的,值得写进 REVIEW.md。
不稳定的测试也一样处理:Claude 不能跳过、不能加 sleep、不能重试到通过;找不到根因就删掉测试并写明原因。规则文件和测试集也要定期清理,否则只会越来越长。把纠正固化成规则的另一种思路,见把每次纠正写成 lint 规则。
常见坑
- 只看单元测试。Agent 和测试都没理解完整任务时,两边一起错,单元测试全绿。
- 闸门一上来就强制。误报会让所有人绕开它。先观察,看记录再收紧。
- 审查者越叠越多。文章明确说,加第二个更贵的审查者通常不如调好第一个。
- 不审查审查者。团队会统计合并后被回滚的改动、合并前被维护者拒掉的改动,并拿一批规模相当、一直没出问题的改动做对照。
完成标准
- 仓库里有能一键跑起应用并冒烟的 verify Skill,Claude 提交前会用。
- Stop hook 或
/goal保证测试、构建、lint 过了才收工。 - REVIEW.md 从基础分支读取,PR 改不到。
- 新闸门在观察模式下跑过一段时间,误报可接受后再切强制。
最后
今天就在你最常改的那个目录旁边建一个 .claude/skills/verify/SKILL.md,只写三件事:怎么启动、走哪条用户路径、怎么汇报结果,然后让 Claude 下次提交前跑一遍。