同模型换 Agent 外壳:成本差一倍,规则该放哪
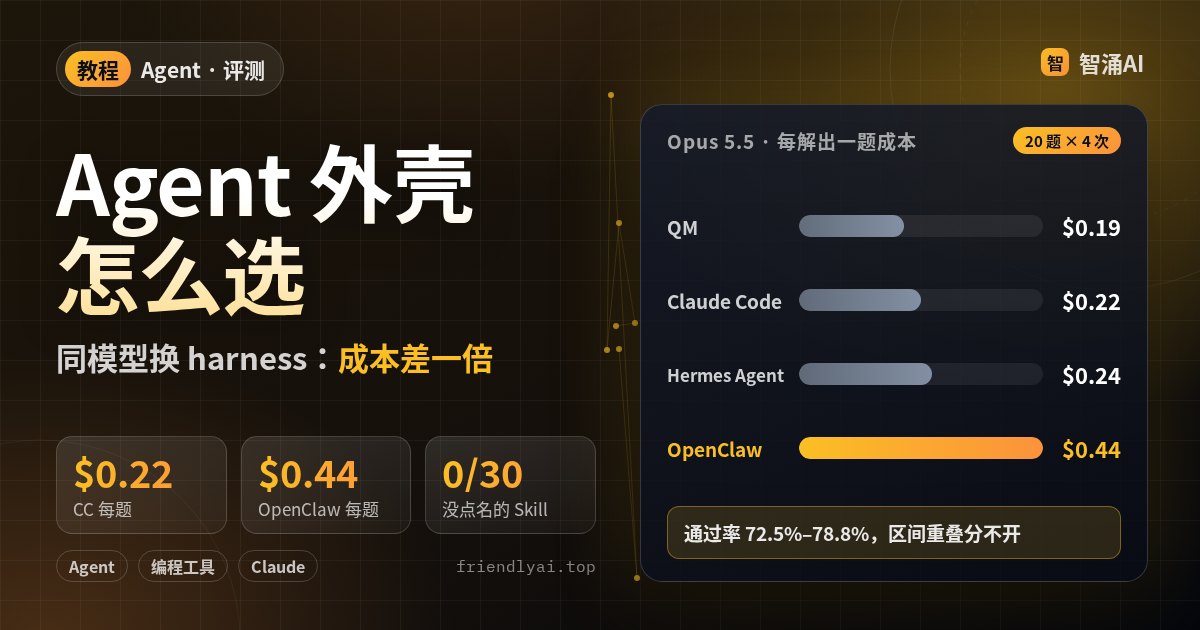
同一个 Opus 5.5,套进 Claude Code、Hermes、OpenClaw、QM 四种外壳去做同一批办公任务,通过率差不多,解出一道题的钱却能差一倍。11 月初开源的 harness-evals 把模型和任务钉死,只换 harness(系统提示、工具、记忆这一圈外围设计),量出了通过率、每解出一题的成本和耗时。下面拆它的数字,再讲三件能直接搬回自己项目的事:怎么比外壳、规则放哪、Skill 怎么才会被用上。
同模型换外壳:通过率分不开,钱分得开
前置条件很少:会用 Claude Code 或 Codex,能看懂 API 账单。评测本身是 MIT 许可的开源仓库 garrytan/g-harness-evals,任务是一家虚构公司的多人办公场景,在模拟的 Slack 里让 Agent 当团队机器人,处理权限、审批和别人事后的纠正。判分看任务结束后的系统状态和事件日志,不看 Agent 自己怎么汇报。主榜 7 个组合,20 道公开开发集任务各跑 4 次,共 560 次试验。
| 模型 | 外壳 | 通过率 | 每解出一题成本 | 单次耗时中位数 |
|---|---|---|---|---|
| Opus 5.5 | QM | 72.5% | $0.19 | 40.1 秒 |
| Claude Code | 76.3% | $0.22 | 40.1 秒 | |
| Hermes Agent | 78.8% | $0.24 | 64.6 秒 | |
| OpenClaw | 76.3% | $0.44 | 99.4 秒 | |
| GPT-6.1 Sol | Codex | 71.3% | $0.17 | 30.1 秒 |
| Hermes Agent | 75.0% | $0.19 | 81.5 秒 | |
| OpenClaw | 73.7% | $0.22 | 83.6 秒 |
通过率全挤在 71.3% 到 78.8% 之间,每个 95% 区间宽 32 到 39 个点,20 道题里有 14 道在所有组合下得分完全一样。作者自己也说题目快饱和了,小于 7.7 到 14.2 个点的差距在这套题上根本测不出来。所以榜单按成本排:成本是总花费按标价计,除以通过的题数,包括被排除的试验。Claude Code 和 Codex 各自只能跑自家模型,两者之间不做比较。
题目太简单时,通过率比不出东西。去比做对一道题各家花了多少钱、多少秒。
贵在哪:每次请求重发的上下文
OpenClaw 在 Opus 上贵了一倍,仓库单独做了一轮成本拆解:同样 80% 通过率,Claude Code 每次试验比它少花 $0.165,差价里约 81% 是缓存写入,原因是 OpenClaw 每次请求重发的系统提示和工具结果大得多。Sol 上则是输出量:OpenClaw 输出 282,492 个 token,Codex 只有 32,226 个。Hermes 在 Sol 上每次试验多发 423 kB 工具 schema,请求次数 16.7 对 11.6。
搬回自己项目的做法:别只看模型单价,先看外壳每轮带了多少东西。MCP 工具一多,schema 每轮都要重发,这和 Skill 瘦身是同一个道理。
规则放哪,Agent 才会每轮都照做
仓库用一条 289 字节的规则「先查 gbrain」做实验:Agent 在第一次回复前调用了 gbrain,就算这一轮照做了。10 道任务、30 轮成员对话的结果:
- Claude Code(Opus 5.5):写进系统提示或启动文件,30 轮全部照做;放每轮 hook 是 26/30;不写规则 18/30。
- Codex(Sol):放 hook、系统提示、启动文件都是 30/30,不写规则只有 6/30。
- 只说一次就会淡掉:同一会话里规则只给一次,后续轮次(Sol 上)Hermes 照做 2/10、OpenClaw 4/10,每轮 hook 是 10/10。
在 Claude Code 里,「启动文件」对应 CLAUDE.md,「每轮 hook」对应 UserPromptSubmit。官方 hooks 文档写明,这个事件的 hook 输出纯文本时,内容会作为上下文加进这一轮。最小配置写在 .claude/settings.json:
{
  "hooks": {
    "UserPromptSubmit": [
      {
        "hooks": [
          { "type": "command",
            "command": "cat \"$CLAUDE_PROJECT_DIR\"/.claude/turn-rules.md" }
        ]
      }
    ]
  }
}
这个事件不支持 matcher,写了也会被忽略。文档还提醒两件事:输出超过 10,000 字符会被存成文件、只给预览;措辞写成事实陈述(「本仓库用 bun test」)比写成系统指令更稳,后者可能被模型当成提示注入。更多 hook 用法见 Claude Code hooks 护栏。
Skill 不点名,可能一次都不会被打开
同样那条规则改成一个没人提起的 Skill:Codex 30/30、OpenClaw 29/30 都用上了;Hermes 和 Claude Code 上模型每次请求都能看到 Skill 名字,30 轮里打开 0 次。Claude Code 的提示里加一句「Use the brain-first skill.」,立刻变成 30/30。
所以在 Claude Code 里依赖某个 Skill 时,在提示或 CLAUDE.md 里写明「做 X 时用 Y skill」,或者直接用斜杠命令调用,别指望它自己翻。
精简提示词要在会失败的题上试
在简单题上,删掉 Claude Code 的记忆与 Skills 说明(每次请求 8.4 KB)能省 19% 成本,通过率也没掉。换到更难、依赖记忆的题上,把这段和工具描述里的建议一起删掉,通过率从 60.4% 掉到 0.0%。完整提示下有 37/48 次试验写了自动记忆文件,29 次通过全都有;删减后的 96 次一次都没写。想裁系统提示省钱,先找一批 Agent 真会做错的题来验,别在送分题上下结论。
常见坑
| 坑 | 怎么处理 |
|---|---|
| 拿这份榜直接选外壳 | 都是公开开发集、固定版本下的结果,不是留出集确认;换成你的任务再比 |
| 把外壳差异当成纯外壳差异 | 每个外壳只配一个模型,差异是外壳加模型的组合 |
| 忽略利益关联 | README 披露:gstack、gbrain 是维护者自己的项目,QM 是 YC 项目,YC 投了 Hermes;看这几行时心里有数 |
| OpenClaw 和 QM 的数字 | OpenClaw 两个组合最后一题因花费上限停跑;QM 用默认 Docker 网络,网络条件没对齐 |
自己想复核,仓库的 scripts/replicate.ts 有两种免费模式:--reanalyze 用试验包重跑分析脚本,--estimate-only 估算重跑花费;付费重跑要自己的 key,并用 --max-usd 设硬上限。自己搭评测集的思路可以配合 Agent 评测基准设计清单。
完成标准
- 能说清你常用的外壳,每解出一题大约花多少钱、多少秒。
- 必须遵守的规则已经写进 CLAUDE.md 或每轮 hook,而不是只在会话开头说一次。
- 依赖的 Skill 都在提示或 CLAUDE.md 里点了名。
- 裁过的系统提示,在一批会失败的任务上验证过。
最后
挑 5 到 10 个你每周都会交给 Agent 的真实任务,用两种外壳各跑几遍,按「总花费 ÷ 做对的题数」算一次账,再决定主力用哪个。