llm 命令行接 DeepSeek:OpenAI 兼容端点配置教程
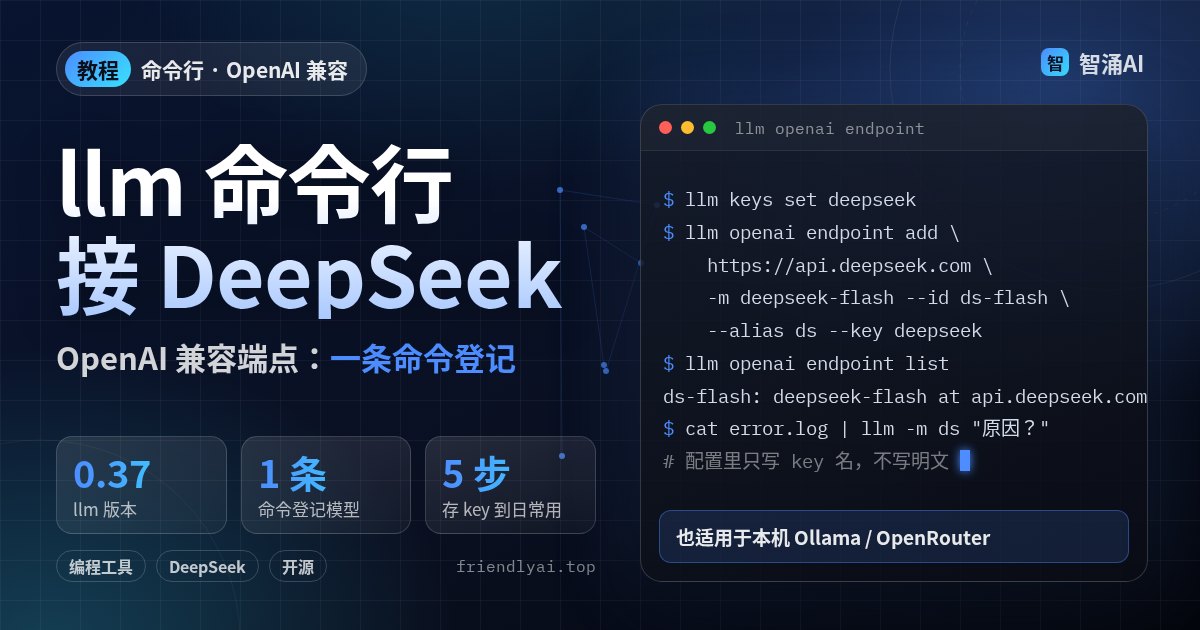
Simon Willison 的开源命令行工具 llm 在 11 月 2 日发了 0.37 版,新加的 llm openai endpoint add 让「接一个 OpenAI 兼容接口」从手改 YAML 变成一条命令。DeepSeek、本机 Ollama、OpenRouter 这类服务都走这个口子。下面按 llm 官方文档和 DeepSeek、Ollama 的接口文档(2026-11-03 北京时间查阅),把装好、存 key、先试后存、日常用的流程理一遍。
前置条件
- Python 环境。0.37 起不再支持 Python 3.10,新增 3.15 支持。官方给了四种装法:
pip install llm、pipx install llm、uv tool install llm、brew install llm。已装的用pip install -U llm或uv tool upgrade llm升级,llm --version看到 0.37 再往下走。 - 一个 DeepSeek API key,或者一台已经跑着 Ollama 的电脑。本机模型怎么装,见 Ollama 本地跑大模型教程。
- 知道服务商的 base URL 和模型名。下面用到的两组值都抄自官方文档。
| 服务 | base URL | 模型名(示例) | key |
|---|---|---|---|
| DeepSeek | https://api.deepseek.com | deepseek-flash、deepseek-v4-pro | 平台申请 |
| 本机 Ollama | http://localhost:11434/v1/ | 你 ollama pull 过的模型,如 qwen3:8b | 客户端要填,Ollama 忽略 |
| OpenRouter | https://openrouter.ai/api/v1 | 按其模型列表 | 平台申请 |
DeepSeek 文档注明:deepseek-flash 现在由 DeepSeek-V4.1-Flash-1017 提供服务;旧名 deepseek-v4-flash 仍能用,但对应模型已退役,请求会转给新 Flash,按 Flash 价计费。新配置直接写 deepseek-flash,省得以后再改。
第一步:把 key 存进 llm,别写进配置
llm keys set deepseek
# 提示 Enter key: 时粘贴 key,回车
llm keys          # 列出已存 key 的名字
llm keys path     # 查看 keys.json 位置
key 存在 keys.json 里,Linux 上一般在 ~/.config/io.datasette.llm/,macOS 在 ~/Library/Application Support/io.datasette.llm/。后面登记模型时只引用 deepseek 这个名字,extra-openai-models.yaml 里不会出现 key 本身,这个文件就算贴给同事看也不怕。
Ollama 文档说客户端必须带一个 key,服务端不校验。想保持写法一致,可以存一个占位值:llm keys set ollama,随便填 ollama。
第二步:先试跑,不登记
llm openai endpoint 从 0.32 起就有,直接对 base URL 发请求。官方文档写得很清楚:这条命令不登记模型、不写日志,也不会把你给 OpenAI 配的 key 发过去,要用哪个 key 得用 --key 明确指定。
# 看接口自报有哪些模型(请求 base URL 下的 models)
llm openai endpoint https://api.deepseek.com --models --key deepseek

# 发一条试试
llm openai endpoint https://api.deepseek.com \
  -m deepseek-flash --key deepseek \
  "用三句话解释什么是向量数据库"

# 推理档位:llm 支持 none 到 max,接口不认会直接回报错
llm openai endpoint https://api.deepseek.com \
  -m deepseek-flash --key deepseek \
  -o reasoning_effort high "证明根号 2 是无理数"
想连着聊几轮加 --chat;要贴图片或 PDF 用 -a 文件。这一步就确认三件事:URL 对、模型名对、key 能用。
先用 endpoint 试通再 add。之后再出错,基本就是配置文件写错了。
第三步:一条命令登记成常用模型
llm openai endpoint add https://api.deepseek.com \
  -m deepseek-flash \
  --id ds-flash \
  --alias ds \
  --key deepseek
这会往 extra-openai-models.yaml 末尾追加一条记录,大致是:
- model_id: ds-flash
  model_name: deepseek-flash
  api_base: https://api.deepseek.com
  api_key_name: deepseek
  aliases:
  - ds
model_id 是你在 llm 里叫它的名字,model_name 是真正发给接口的名字。分开写,是怕和别的插件注册的模型撞名。--id 不写就默认用模型名。
本机 Ollama 同理:
llm openai endpoint add http://localhost:11434/v1/ \
  -m qwen3:8b --id local-qwen --key ollama
登记完先核对,再正常调用:
llm models --options -m ds-flash   # 看模型和可用选项
llm -m ds "把这段 SQL 改成带索引提示的版本" < query.sql
cat error.log | llm -m local-qwen "这段报错最可能的原因是什么"
llm logs -n 1                       # 确认刚才那条记进了日志
想以后不写 -m,用 llm models default ds-flash 设成默认。0.37 把没设过默认的用户换到了 gpt-6-luna,换了国产接口的人记得设一下,否则漏写 -m 时会走 OpenAI。
第四步:能力开关按服务商文档加
| 参数 | 写进 YAML | 什么时候加 |
|---|---|---|
--supports-tools | supports_tools: true | 模型支持函数调用,你要用 -T 给它工具 |
--vision | vision: true | 模型能看图 |
--supports-schema | supports_schema: true | 要用 --schema 拿结构化 JSON |
--reasoning | reasoning: true | 推理模型 |
--responses | responses: true | 接口实现的是 Responses API 而不是 Chat Completions |
--no-stream | can_stream: false | 接口不支持流式 |
-H 名=值 | headers: | OpenRouter 这类要求额外请求头的服务 |
开关写错了 llm 不会替你纠正。服务商没写支持工具调用,你却加了 --supports-tools,结果就是调用时报错。拿不准就先不加,用到了再改。
第五步:登记之后的日常用法
登记过的模型和 llm 自带的 OpenAI 模型待遇一样,下面这些都能用。
# 连续对话,0.37 起可用 -u 在每轮后打印 token 用量
llm chat -m ds -u

# 接着上一轮问
llm -c "换成 Go 写一遍"

# 把常用的系统提示词存成模板
llm -m ds -s "你是严格的代码审查员,只列问题不夸" --save review
git diff | llm -t review

# 在历史记录里搜
llm logs -q 索引 -n 5
也能在 Python 里调。0.31 起,YAML 里登记的模型同时注册了异步版本:
import llm
model = llm.get_model("ds-flash")
print(model.prompt("给这个函数起三个更好的名字:def f(x)").text())
不想留记录可以 llm logs off。0.37 修了一个老问题:以前 llm chat 不理会这个开关,照样每轮都记,现在会遵守了。同一版还修了多个进程同时写日志库时报的 SQLITE_BUSY,脚本里并发调用 llm 的人可以升级。
为什么用 llm,不直接写 curl
| 对比项 | curl / SDK 直调 | llm 登记后 |
|---|---|---|
| 换模型 | 改 URL、模型名、key 三处 | 改 -m 一处 |
| key 存放 | 环境变量或脚本里 | keys.json,配置只写名字 |
| 历史记录 | 自己存 | 默认写进 SQLite,可全文搜 |
| 管道拼接 | 要自己转 JSON | cat 文件 | llm |
| 工具调用 | 自己写循环 | -T / --functions,本地执行后回传 |
要批量、高并发地调接口,还是直接用官方 SDK 更合适。llm 适合终端里随手问、在 shell 脚本里串起来用,也适合同一个问题拿几家模型轮流试。
常见坑
- 同名 ID 报错:同一个
--id再 add 一次会直接报错。要改参数加--replace。注意--replace和remove会重写整个文件,你手写的注释会丢;add只往末尾追加,不动原有内容。 - key 名字不存在:
--key填的名字必须已经出现在llm keys list里,先keys set再 add。 - 以为 endpoint 试跑有记录:不登记的
llm openai endpoint调用不写日志,llm logs里找不到。要留档就先 add。 - Ollama 上下文被截短:OpenAI 兼容接口没有设置上下文长度的参数。Ollama 文档给的办法是写一个 Modelfile:
FROM 模型名加一行PARAMETER num_ctx 长度,用ollama create 新名字建出新模型,再把新名字登记进 llm。长文档总结时回答前后对不上,先查这一项。 - Ollama 云端和本机是两个地址:本机是
http://localhost:11434/v1/,key 随便填;不装 Ollama 直连云端用https://ollama.com/v1,要真实的OLLAMA_API_KEY,模型名以https://ollama.com/api/tags为准。两者用不同的--id分开登记,别混。 - 漏写 -m 走了 OpenAI:见第三步,设好默认模型。
- 给模型开工具前想清楚:
-T和--functions让模型在你本机执行函数。llm 文档专门警告了提示词注入:模型同时能读私密数据、会读到外部内容、又能往外发数据时,风险最大。可以加--tools-approve让每次调用先问你,细节见 提示词注入防护教程。
完成标准
llm openai endpoint list能看到你登记的模型,格式是「ID: 模型名 at URL」。llm -m ds "hi"有回复,llm logs -n 1能看到这条。extra-openai-models.yaml里只有api_key_name,没有明文 key。llm models default显示的是你想要的模型。
最后
先挑一个最常用的接口照第二、三步走一遍,把它设成默认模型,之后管道里拼 cat 文件 | llm 就顺手了。配置文件位置随时用 llm openai endpoint path 查。