DeepSeek 搜索与抓取 API 教程:调用、计费与重试
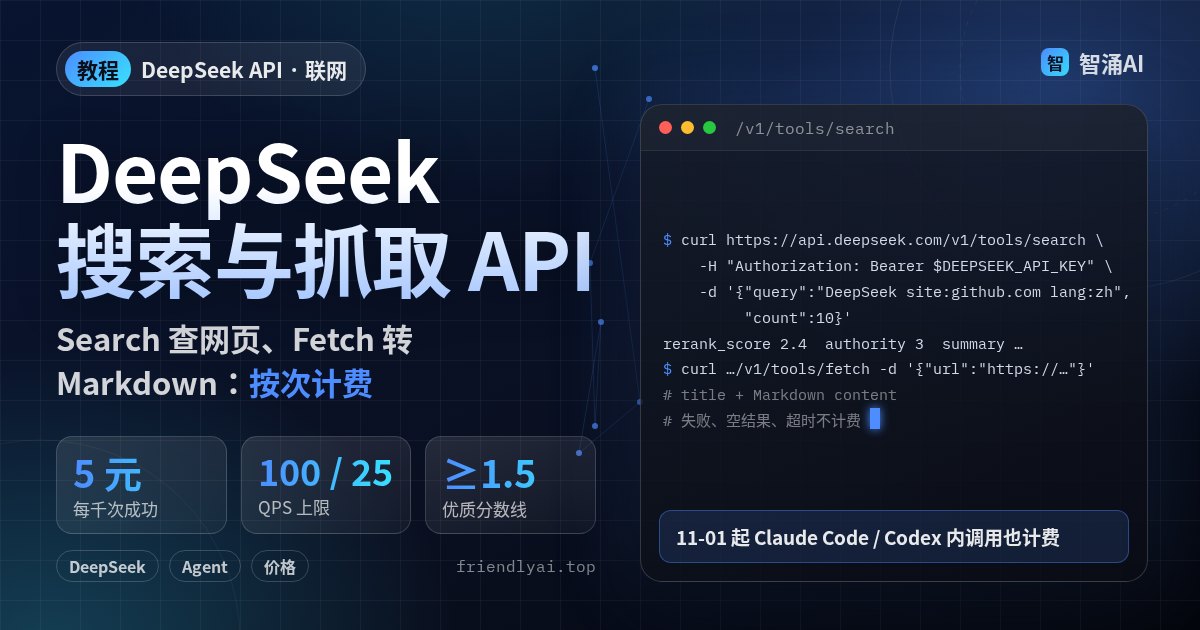
DeepSeek 在 2026-10-17 开放了自研搜索引擎的 API,一共两个接口:Search 按关键词返回结构化结果,Fetch 把单个网页转成 Markdown。按次计费,每 1,000 次成功请求 5 元,失败和空结果不收钱。还有一点很多人没注意:在 DeepSeek Harness、Claude Code、Codex 里用 DeepSeek API 时,服务端工具调用本来就会走这两个接口,从北京时间 2026 年 11 月 1 日 00:00 起按次收费。下面按官方文档(2026-11-03 北京时间查阅)讲怎么调、怎么控成本、哪些错误该重试。
先搞清楚两个接口各干什么
| 接口 | 输入 | 输出 | 账号级 QPS |
|---|---|---|---|
Search:POST https://api.deepseek.com/v1/tools/search | query 搜索词 | results 数组:标题、链接、长短摘要、可选正文、日期、分数 | 100 |
Fetch:POST https://api.deepseek.com/v1/tools/fetch | 一个 url | title + Markdown 格式的 content | 25(另有按目标域名的限速) |
两者都是原始 JSON 接口,用的是和模型 API 同一个 Key:请求头带 Authorization: Bearer <DeepSeek API Key> 和 Content-Type: application/json。不经过模型,也不按 token 计费,适合放进你自己的 Agent 或 RAG 流程,当「查网页」那一步。
第一步:发一次搜索
curl https://api.deepseek.com/v1/tools/search \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "query": "DeepSeek 模型 site:github.com OR site:huggingface.co lang:zh after:2025",
    "count": 10,
    "ori_question": "DeepSeek 最近开源了哪些模型?"
  }'
几个请求字段:
query:必填,1~128 个字符,不能全是空白。count:默认 10,范围 1~50。条数不影响单次价格。ori_question:触发这次搜索的用户原问题,帮搜索理解意图。Agent 把用户问题改写成关键词时,把原问题一起传过去。localization:传一个 IP 地址,优先返回本地化结果。need_content:默认false。设成true才在content里返回网页正文。
搜索语法会原样交给搜索服务:site: 限定站点(多个用 OR 连),-site: 排除站点,-词 和 -"短语" 排除,"短语" 精确匹配,lang:zh,en 限语言,after:/before: 限发布日期,可以写到年或具体日期。
第二步:用两个分数筛结果
每条结果除了 title、url,还有这几个字段值得用:
| 字段 | 含义 | 怎么用 |
|---|---|---|
rerank_score | 0~3 分,综合相关性、权威性、时效性;≥1.5 为优质 | 低于 1.5 的先丢掉 |
authority | 0~4,-1 表示未知;≥3 为极权威 | 查事实、数字时优先取 ≥3 的 |
snippet | 短摘要,通常 100~200 字符 | 给前端展示 |
summary | 长摘要,通常 600~800 字符 | 直接喂给模型 |
date | UTC 的 RFC 3339 时间,未知为 null | 做时效过滤 |
多数问题用
summary就够了。先筛再抓,比每条都要正文省上下文。
一个够用的流程:Search 拿 10 条,按 rerank_score ≥ 1.5 过滤,事实类问题再要求 authority ≥ 3;把 summary 给模型,模型判断信息不够时,再对一两个 URL 调 Fetch 拿全文。
第三步:按需抓全文
import os, requests

r = requests.post(
    "https://api.deepseek.com/v1/tools/fetch",
    headers={"Authorization": f"Bearer {os.environ['DEEPSEEK_API_KEY']}"},
    json={"url": "https://example.com/article"},
)
r.raise_for_status()
page = r.json()
print(page["title"])
print(page["content"])  # Markdown 正文
url 不超过 8192 个字符,必须是带 host 的 HTTP/HTTPS 地址,不能带用户名或密码。抓取结果受目标站点可用性和访问策略影响,抓不到会返回 404,被安全策略拒绝返回 403。
第四步:包成 Agent 的两个工具
要让自己的 Agent 联网,最直接的做法是把两个接口各包成一个函数工具,交给模型按需调用。下面是一个示意的工具定义(OpenAI 兼容的 function calling 格式),描述写清楚「先搜后抓」,模型就不会一上来就 Fetch:
[
  {"type": "function", "function": {
    "name": "web_search",
    "description": "搜索网页,返回标题、链接和长摘要。先用它,摘要不够再调 web_fetch。",
    "parameters": {"type": "object", "properties": {
      "query": {"type": "string", "description": "关键词,128 字以内,可用 site:/lang:/after:"},
      "count": {"type": "integer", "minimum": 1, "maximum": 50}
    }, "required": ["query"]}}},
  {"type": "function", "function": {
    "name": "web_fetch",
    "description": "抓取单个网页全文(Markdown)。只对搜索结果里最相关的一两条使用。",
    "parameters": {"type": "object", "properties": {
      "url": {"type": "string"}
    }, "required": ["url"]}}}
]
工具实现里做三件事:调接口前检查 query 长度;拿到结果后按分数过滤,只把 title、url、summary、date 交回模型,不要把整个 JSON 原样塞回去;Fetch 返回的 Markdown 太长时截断或分段。这样一次联网查询通常只花 1~3 次计费请求,成本好估。
还要分清两种用法:自己写 Agent 时,调用次数由你的工具逻辑决定;在 Claude Code、Codex 里接 DeepSeek API 时,联网调用由服务端工具发起,你能控制的主要是提示里要不要让它联网、联网几次。
计费和限速:算清这几条
- 价格:Search 和 Fetch 都是每 1,000 次成功请求 5 元,按次数算,不按 token,也不按返回条数。
- 什么算成功:只有 HTTP 200 且有结果的请求计费。Search 的
results非空,Fetch 返回了正文。失败、没搜到、超时都不计费。 - 编程工具里的隐性调用:在 DeepSeek Harness、Claude Code、Codex 里用 DeepSeek API 时,服务端工具调用会访问这两个接口,2026-11-01 00:00(北京时间)起按次收费。重度用 Agent 联网的,到账单里留意这一项。
- 限速:按账号算,与用哪个 Key 无关,和模型并发限制分开计。Search 100 QPS,Fetch 25 QPS;Fetch 对同一目标域名还有单独限速。
按这个价格粗算一下:一个每天回答 1,000 个问题的助手,每题 1 次 Search,平均每两题抓 1 页,一天约 1,500 次计费请求,也就是 7.5 元左右;没搜到结果、抓取失败的请求不计入。容易超出预期的情况是 Agent 自己反复改写关键词、连搜五六次的情况,所以工具层最好加一个单次任务的调用上限,并把每次调用记进日志,月底对账时能对上。
常见坑
- 所有错误都重试:文档写得很清楚,408、429、5xx 等一下再重试;402 是余额不足,先充值;其他 4xx(参数错、Key 无效、403、404)不改请求就别重试,重试也不会变。
- 默认拿正文:
need_content默认关闭是有道理的。每条都要正文,模型上下文会被网页全文撑满。先用summary,确实不够再 Fetch。 - 并发抓同一个站:Fetch 有按域名的限速,批量抓同站文档页时要排队,否则会集中吃到 429。
- query 太长:上限 128 个字符。Agent 直接把用户整段话塞进
query会报 400,应改写成关键词,原话放ori_question。
完成标准
- 一次 Search 能返回带
rerank_score的结果,你的代码按分数过滤。 - Fetch 对目标页返回 Markdown,失败时按状态码走对应分支。
- 重试逻辑只覆盖 408、429、5xx。
最后
先拿一个真实问题跑通「Search → 过滤 → 必要时 Fetch」这条链,再接进 Agent。还没配置 DeepSeek 模型接口的,可以先看本站的 llm 命令行接 DeepSeek 教程,Key 是同一个。