团队共享 Agent Skills:.well-known 与 Skills over MCP
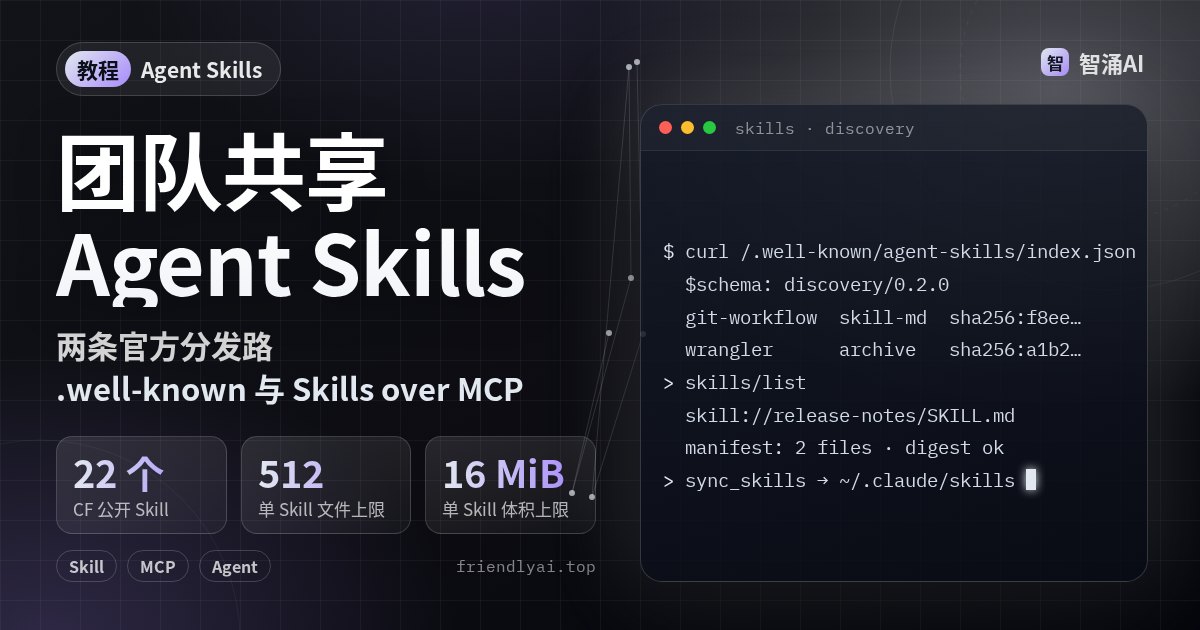
团队里的 Agent Skills 多半散在每个人的 ~/.claude/skills 里,谁改了一版就在群里发个 zip。现在有两条官方路子能换掉这种同步方式:一条是把 Skill 发布在自家域名的 /.well-known/agent-skills/ 下,另一条是 MCP 的 Skills 扩展(Skills over MCP),由 MCP 服务器按身份把 Skill 发给 Agent。Tailscale 11 月 10 日(美国时间)更新的 Aperture 两条都接了。这篇按两份规范和 FastMCP 文档,讲清楚各自怎么搭、什么时候用哪条。
先分清两条路解决的问题
.well-known 发现规范由 Cloudflare 起草,仓库 Apache-2.0。它解决「对外公开」:任何人拿到你的域名,就能列出你发布了哪些 Skill。Skills over MCP 的标识是 io.modelcontextprotocol/skills,对应 SEP-2640,2026 年 9 月 13 日合并、状态 Final,目前处在扩展生命周期的 Beta 阶段。它解决「对内分发」:Skill 跟着 MCP 服务器走,服务器认得调用者是谁,可以只给某个团队看某些 Skill。
两者都不改 Skill 本身的格式,仍是一个目录加 SKILL.md,frontmatter 至少有 name 和 description。还没写过 Skill 的,先看站内 写你的第一个 Agent Skill。
| 方式 | 适合 | 权限 | 更新 |
|---|---|---|---|
| 手工复制到本地目录 | 个人、少量 Skill | 无 | 靠人通知 |
Git 仓库 + npx skills add | 开源 Skill 包 | 跟仓库权限走 | skills update |
/.well-known/agent-skills/ | 厂商对外发布 | 公开 | 比对 digest |
| Skills over MCP | 公司内部、多 Agent | 按身份 | 服务器部署即生效 |
前置条件
- 手上至少有一个符合 Agent Skills 规范的 Skill 目录:
SKILL.md开头有 YAML frontmatter,name只用小写字母、数字和连字符,1 到 64 个字符,并且和目录名一致。 - 走第一条路:一个能控制根路径的 HTTPS 域名,能给静态文件设 Content-Type。
- 走第二条路:Python 3.11 以上环境装 FastMCP 4.2(
pip install -U fastmcp,11 月 13 日已发正式版),或用 TypeScript SDK v2.4.0 的ext/skills。
第一条:在自家域名发布 index.json
规范要求发布方在 /.well-known/agent-skills/index.json 放一份索引,顶层是 $schema 和 skills 数组。当前 schema 是 https://schemas.agentskills.io/discovery/0.2.0/schema.json,每条 Skill 必须有五个字段:name、type、description、url、digest。
type 只有两种:只有一个 SKILL.md 的用 skill-md,带脚本、参考文档的打成 .tar.gz 或 .zip,用 archive。截至 11 月 12 日我们查阅的两份线上索引:developers.cloudflare.com 列了 22 个 Skill,全是 archive;vercel.com 列了 9 个,4 个 skill-md、5 个 archive,url 直接指向 GitHub Release 的下载地址。可见 url 不必放在 .well-known 目录下,放 CDN 也行。
下面这段脚本扫描 .well-known/agent-skills/*/SKILL.md,生成 skill-md 类型的索引(frontmatter 解析写得很简单,只认单行的 key: value):
import hashlib, json, pathlib
root = pathlib.Path(".well-known/agent-skills")
skills = []
for md in sorted(root.glob("*/SKILL.md")):
    raw = md.read_bytes()
    front = raw.decode().split("---")[1]
    meta = dict(l.split(":", 1) for l in front.strip().splitlines())
    skills.append({
        "name": meta["name"].strip(),
        "type": "skill-md",
        "description": meta["description"].strip(),
        "url": f"/.well-known/agent-skills/{md.parent.name}/SKILL.md",
        "digest": "sha256:" + hashlib.sha256(raw).hexdigest(),
    })
index = {"$schema": "https://schemas.agentskills.io/discovery/0.2.0/schema.json",
         "skills": skills}
(root / "index.json").write_text(json.dumps(index, ensure_ascii=False, indent=2))服务器那边规范也有硬要求:index.json 用 application/json,SKILL.md 用 text/markdown 或 text/plain,.tar.gz 用 application/gzip;支持 GET 和 HEAD,不存在的返回 404。想让浏览器里的客户端读,再加 CORS 头。
消费端最省事的是 skills CLI:它的文档写明,给 npx skills add 传一个网址时,先尝试 well-known 发现,失败了才当直接下载地址处理。Aperture 的「Use a URL」导入走的也是这份规范。
digest 一变,客户端就知道该重新下载;对不上就必须丢弃,不能「先用着」。
第二条:让 MCP 服务器分发 Skill
Skills over MCP 没有发明新的传输方式,每个 Skill 文件都是一个 MCP 资源,地址惯例写成 skill://<skill-path>/<file-path>,用原有的 resources/read 读取。扩展只加了三个方法:
skills/list:列出服务器提供的 Skill,每条带原样的 frontmatter 和完整文件清单,清单里每个文件都有 SHA-256 和字节数。skills/get:按 URI 取单个 Skill。服务器可以不把所有 Skill 都放进列表,但必须响应这里的查询。resources/directory/read:可选,列出某个目录下的直接子项。服务器声明了directoryRead: true客户端才能调。
服务器要在 server/discover 里同时声明 resources 能力和这个扩展。规范建议单个 Skill 不超过 512 个文件、16 MiB。
用 FastMCP 搭一个,官方文档的最小示例是这样:
from fastmcp import FastMCP, Skill
from fastmcp.skills.provider import SkillCatalogProvider

release_notes = Skill(
    name="release-notes",
    description="Write release notes from merged pull requests.",
    instructions="# Release notes\n\nGroup changes by theme. Follow template.md.\n",
    files={"template.md": "## Highlights\n\n## Fixes\n"},
)

mcp = FastMCP("Team Skills")
mcp.add_provider(SkillCatalogProvider([release_notes]))
已有的 Skill 目录用 Skill.from_directory("skills/deploy") 读进来;Skill 存在数据库或经常改的,继承 SkillCatalogProvider 重写 load_skills(),FastMCP 每个请求调用一次,改动下一个请求就能看到。fastmcp list server.py --skills 可以列出当前提供的 Skill。
权限这块,FastMCP 的规则是调用者读不到的 Skill 不会出现在 skills/list 里,任何一个文件被 AuthMiddleware 拒绝,整个 Skill 都会从列表里消失。按团队分 Skill,就在这一层做。
多数 Agent 目前还只从磁盘读 Skill。FastMCP 4.2 的做法是客户端逐个 read_skill()(先核对每个文件的大小和 SHA-256),再用 to_directory() 写进本地目录;4.1 的 sync_skills() 在 4.2 里还能用但会告警,4.3 移除:
from pathlib import Path
from fastmcp import Client
from fastmcp.skills import SkillsClientExtension

target = Path.home() / ".claude" / "skills"
client = Client("http://localhost:8000/mcp", extensions=[SkillsClientExtension()])
async with client:
    for entry in await client.list_skills():
        skill = await client.read_skill(entry.uri)
        skill.to_directory(target / skill.name, overwrite=True)
服务器没开 Skills 扩展(比如还在 4.1)时,把 list_skills() 换成 list_skill_resources(),再把每个 str(resource.uri) 交给 read_skill()。overwrite=True 会整夹替换本地同名目录,本地改动会丢。
现在哪些地方能用
按 ext-skills 仓库维护的实现清单:官方 TypeScript SDK 在 v2.4.0 以 ext/skills 发布;Python SDK、C# SDK 已合并、还没发版。服务器侧有 Hugging Face、Cloudflare API MCP、n8n、Outline 等。宿主侧 fast-agent 在清单里标为 v1,ChatGPT 插件是部分支持(提交插件时导入一次快照),VS Code 还只是 planned,Goose、opencode 有 PR 在审。FastMCP 文档把 SkillCatalogProvider 标为 4.2.0 新增,4.2.0 正式版已于 11 月 13 日(美国时间)发布,详见站内 FastMCP 4.2 快讯。
Aperture 的做法是把两条路合在一个网关里:可以上传 SKILL.md 或 zip、同步公开 GitHub 仓库、按 .well-known 网址导入,也可以让接入 Aperture MCP 的 Agent 直接添加;分发时按 Skills over MCP 规范,管理员决定哪些人或团队拿到哪些 Skill。Tailscale 自己也写明,不是所有 Agent 都支持这个扩展。事件本身见站内 Aperture 快讯。
常见坑
- 以为读到 SKILL.md 就算加载了。规范写明,通过
resources/read读到内容并不等于激活;宿主要走自己的加载流程,校验内容、按需征得用户同意后才放进模型上下文。 - 改了一个参考文件,大家的授权全失效。持久授权绑定的是全部文件 URI 和 digest,增删改任何一个文件,宿主都必须重新请求批准。频繁小改的 Skill,发版节奏要想好。
- 同名 Skill 互相覆盖。Skill 的身份是「来源服务器 + URI」,名字只是标签。规范要求宿主不能让同名 Skill 静默替换;自己做内部服务器时,名字前加团队前缀省得混。
- index.json 漏写 $schema。没有
$schema的索引会被当成 v0.1.0 处理,而 0.2.0 和 0.1.0 不兼容,旧格式的files字段已经删掉。 - 把 Skill 当可信代码。两份规范都要求把 Skill 内容当不可信输入:
allowed-tools这类权限和脚本执行要按 Skill 单独批准,archive 解包要拒绝..路径和指向目录外的链接。
做到哪一步算完成
- 对外:
curl https://你的域名/.well-known/agent-skills/index.json返回application/json,每条 digest 和实际文件的 SHA-256 一致。 - 对内:
fastmcp list server.py --skills能列出团队 Skill,换一个没权限的账号连上去,看不到受限的那几个。 - 本地还不支持扩展的 Agent,用
read_skill()+to_directory()拷到 Skill 目录后能正常触发。
Skill 和 MCP 各管什么,可以对照站内 Skill 和 MCP 的区别。
最后
先挑团队里最常被转发的那一两个 Skill,按上面的 FastMCP 示例放到一台内部 MCP 服务器上,用上面的客户端脚本发给大家,跑一周再决定要不要上网关。